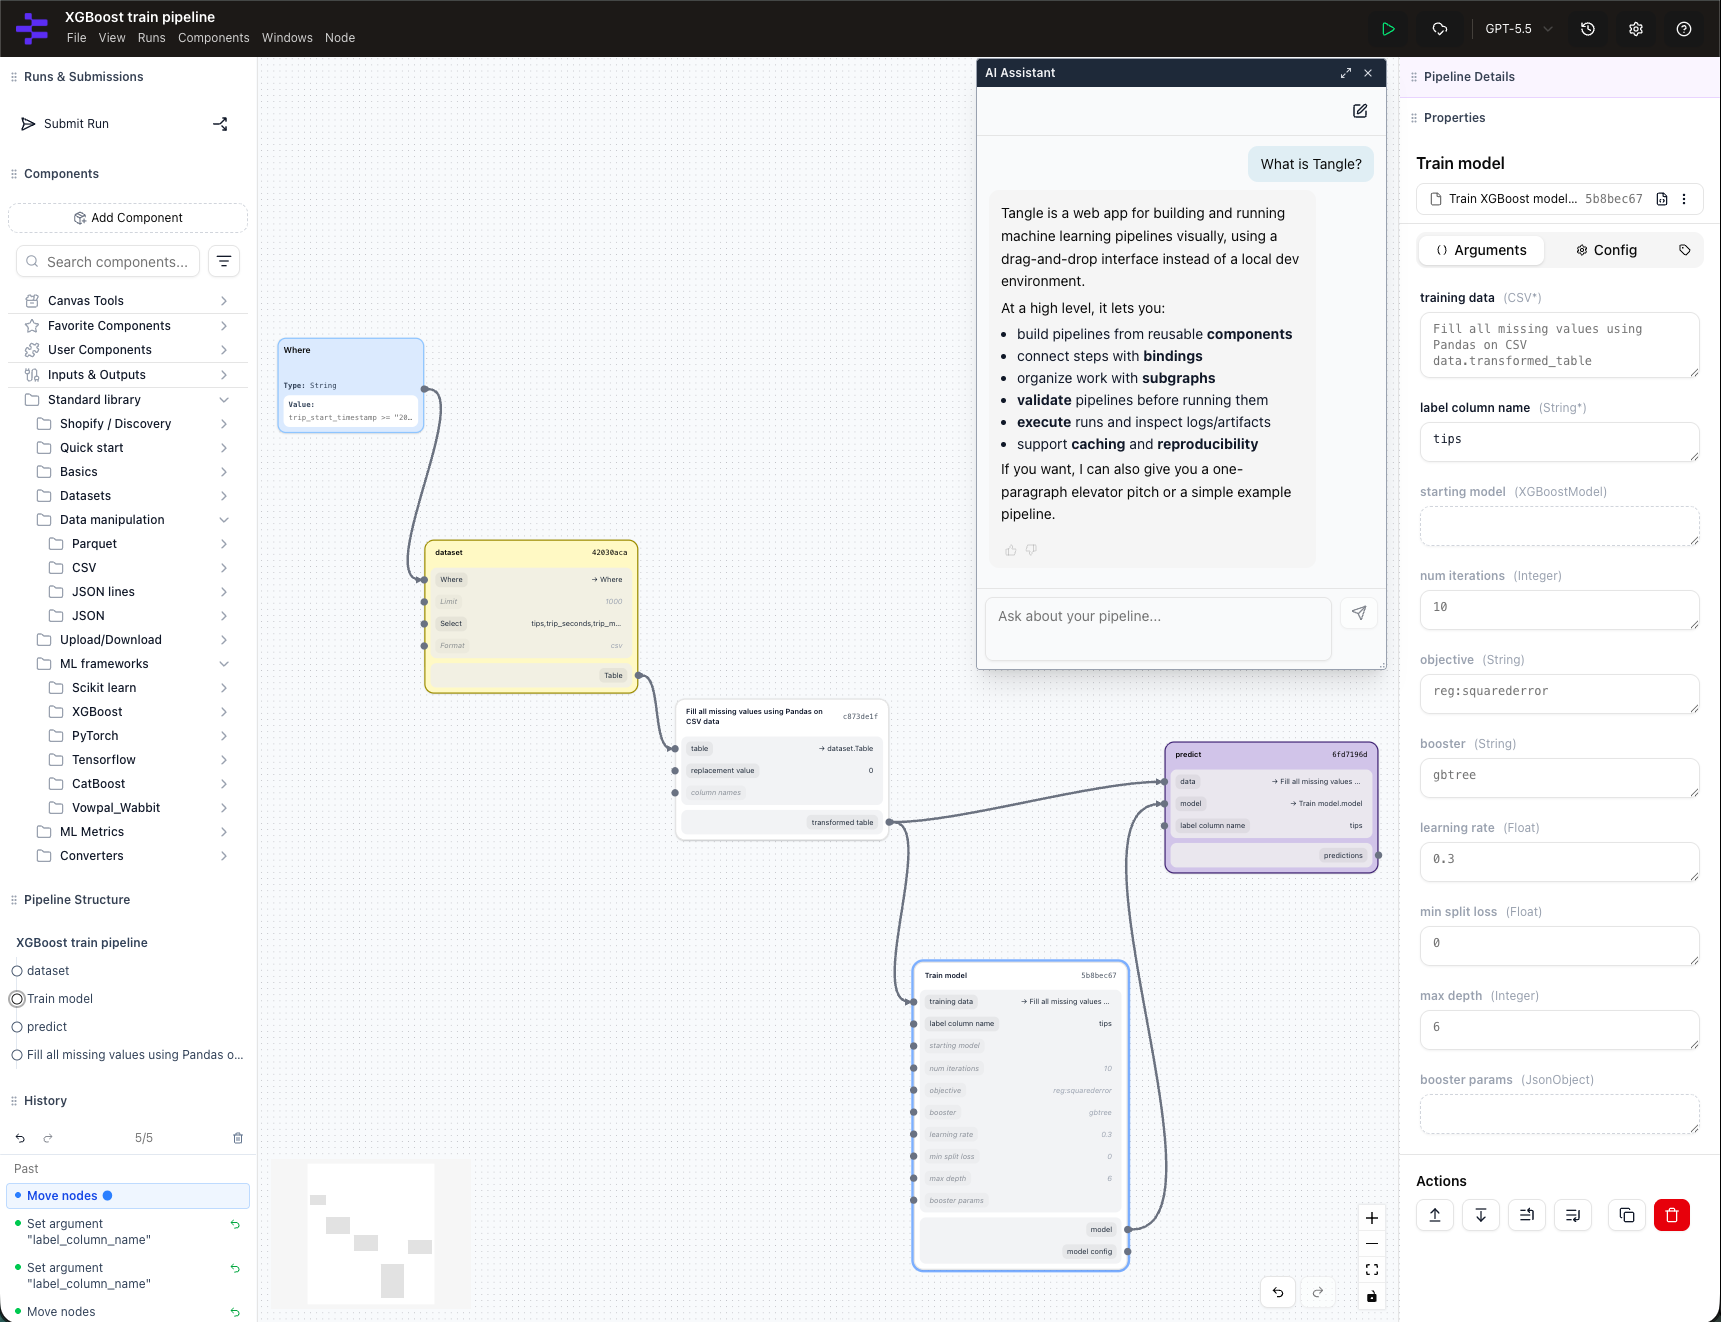
机器学习的工作充满循环:提出假设、搭建流水线、跑一遍、看指标、调整、再来。Tangle 是 Shopify 内部跑 ML 实验的地方,给工程师一个共享平台来构建和执行流水线;Tangent 是跑在它上面的自主 Agent,负责决定跑什么、怎么跑。
围绕 Tangent,Shopify 还搭了一套基于 Linux 的托管平台,让这些 Agent 能安全地持久化运行、远程工作、访问所需服务,同时全程不持有凭据。做法是容器化隔离、证书签发代理和每实例持久化存储。
项目概览
| 项目 | 信息 |
|---|---|
| 来源 | Linux.com / Shopify |
| 作者 | Alexey Volkov、Bo Li、Ben Chen、Maksym Yezhov、Pete Luferenko、Volv Grebennikov |
| 发布时间 | 2026年7月9日 |
| 核心组件 | Tangle(流水线平台)+ Tangent(自主实验 Agent) |
| 授权 | Apache 2.0(Tangle、Tangent 技能、托管平台、Tangent Shell 全部开源) |
| 关键词 | ML 实验自动化、Agent 隔离、凭证代理 |
一、Tangle:开源的可视化流水线平台
Tangle 是一个开源、平台无关的 ML 实验平台,带一个拖拽式的可视化编辑器。用户把组件拖到画布上,把输出连到输入,组成一张流水线图,然后提交执行(本地或云端均可)。
几个值得说的设计:
缓存层:跳过或复用已执行过的步骤,包括仍在执行中的步骤,所以迭代又快又省。
运行记录永久保存:包括图、组件和日志,所以流水线在多年之后依然可复现。- 共享运行与缓存:队友可以在几秒内查看、复制、修改彼此的流水线,不用再克隆一个私有 notebook、祈祷环境能对上。
对比同类工具:Tangle 与 Airflow、Kubeflow Pipelines 等开源工具相似,缓存模型和可视化编辑器是它实现快速实验循环的关键。
组件生态开放:任何容器化的 CLI 程序(任意语言)都能当 Tangle 组件,组件之间用文件交换数据,格式随意(CSV、Parquet、JSON 等)。
组合方式:像 shell 脚本、makefile 和 Unix 管道一样。
更多信息见官网 https://tangleml.com/ ,可以立即试用。
二、Tangent:自己迭代的实验 Agent
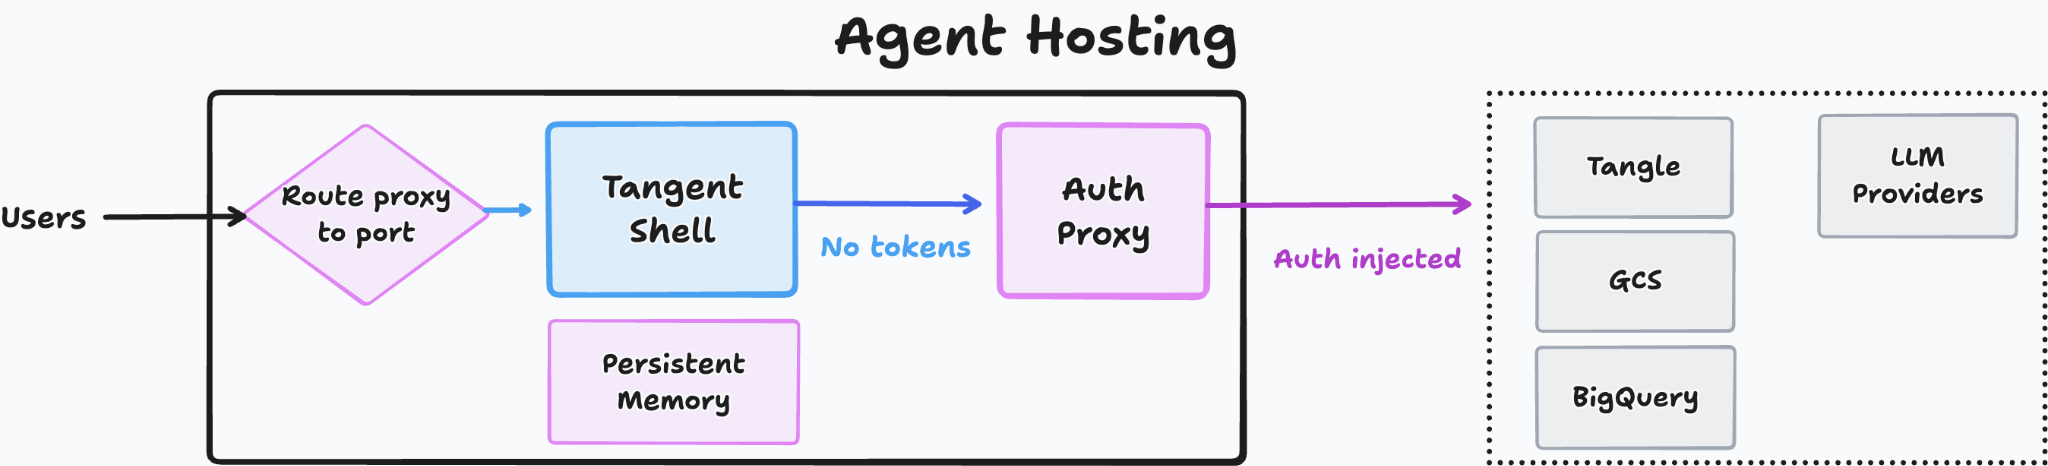
Tangent 是跑在 Tangle 之上的自主 ML 工程 Agent,用来加速你的 Tangle 实验工作流。它的思路来自 Andrej Karpathy 最近带火的 autoresearch,但把那个"单卡上的一个训练脚本"扩展成了跑在 Tangle 上的完整实验流水线——带一队专门的子 Agent、门控检查点和持久记忆。
用法是给它一个场景、一个模型、一个要优化的指标、一个数据集,它就开始迭代:分析结果、形成假设、修改流水线、提交运行、监控执行、综合学到的东西。
交多少活给它,你自己定。 Tangent 支持交互式使用,你可以只交办单步(搭这个组件、调试这次失败的运行、分析这批指标),也可以用一条命令把整个循环交出去:
tangent auto
八步循环 + 门控检查点
整个流程是一个八步循环,每一步都有门控检查点,清单上每一项都通过,Agent 才进入下一步。每个关卡还会重新加载指令和上下文,防止长时间运行时跑偏。
内存是持久化的纯文本:
| 文件 | 作用 |
|---|---|
MEMORY.md | 存当前最优配置和经验教训 |
| 每日会话日志 | 记录过程细节 |
| 每次运行的经验 | 归档到对象存储 |
三、Tangent 技能:用 Markdown 当大脑
Tangent 的"大脑"是一个技能,用 Markdown 写的。入口是一个单独的 SKILL.md,背后是一队子 Agent 技能:研究员、构建者、调试者、审查者,等等。
因为技能就是文件,所以它们可移植、可以在 PR 里审查、并且与具体 harness 无关——同一套技能能驱动你偏好的任何编码 Agent。
这种可移植性很重要,因为 Tangent 跑在开放的 Agent harness 上,而不是某个专有客户端。要加一个能力,就写一个 Markdown 文件并提交,没有二进制要构建或分发。选 Markdown 而不是配置格式或 DSL 是有意为之:它在普通 PR 里可 diff、不需要 schema 或解析器来校验、人与编码 Agent 都能原生阅读。技能文件本身就是它自己的文档。
# Tangent
A skill is just Markdown. This file is the entry point; each subagent is
its own Markdown file, loaded on demand.

## Commands
tangent <subagent>   Read agents/<subagent>.md and follow it.
tangent auto          Run the autonomous 8-step experiment loop.

## Subagents                Agent file
tangent builder             agents/builder.md
tangent debugger            agents/debugger.md
tangent researcher          agents/researcher.md
tangent reviewer             agents/reviewer.md
tangent reporter            agents/reporter.md

## Auto Mode - the loop
0 Initialize -> 1 Analyze -> 2 Hypothesize -> 3 Submit ->
4 Monitor -> 5 Evaluate -> 6 Synthesize -> 7 Decide -> (loop)

Each step has a gate. The agent won't advance until every item on the
step's checklist passes - and it re-reads its instructions at each
gate so it doesn't drift over a long run.
四、Agent 托管平台
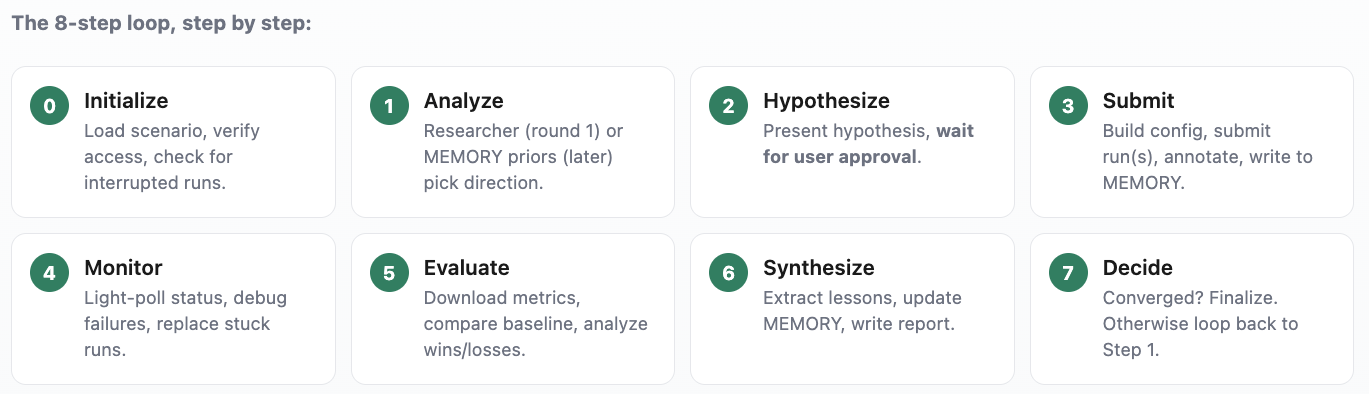
Tangent Agent 托管平台帮用户部署持久的 Tangent 实例,这些实例与 Tangle、云服务商和其他外部服务通信。
每个 Tangent 实例是一个多 Agent 空间:一台基于 Linux 的 VM/容器,可以托管多个 Agent 应用(TUI、API、WebUI)。因为每个 Tangent 组件都作为标准 Linux 进程跑在容器里,Tangent 直接继承了成熟的 Linux 网络、存储和隔离原语,而不需要引入自定义运行时。实例数据(如 Agent 会话和记忆)在重启后持久保留,另外还有跨实例的共享记忆。
Auth Proxy(证书签发代理)
Agent 需要访问服务,但总存在 Agent 读到凭据、再泄露给 AI 服务商的风险。Tangent 的解法是在单独的容器里跑一个系统级代理:
代理拦截并修改来自 Agent 工具的 HTTP 请求
自动加上认证头
可以改写请求 URL(比如把
api.aicompany.com重定向到某个 AI 代理)要改 HTTPS 请求,就动态签发新的 SSL 证书,Agent 容器的操作系统和程序通过生成好的证书颁发机构(CA)信任这些证书
实现细节
Kubernetes 版本里,每个实例是一个 StatefulSet:一个跑着 Agent、应用和代理的容器 Pod,背后挂一个每实例的 PersistentVolume,加上一个共享内存卷挂载。
五、Tangent Shell
为了原生操作 Tangle,Shopify 做了定制的 Agent Host 镜像——Tangent Shell。
它让 Agent 远程运行,重启后保留记忆和会话,合上笔记本也能继续干活。Tangent Shell 编排多个 Agent:把请求拆成切片、分派给并行的子 Agent、通过一个持有会话的 Prime agent 来协调结果。
Tangent Shell 是照着 ML 专家的需求建的:每个会话启动时就预装了 Tangent 技能工具包和 Tangle API 工具,并被指示协助基于 Tangle 的 ML 实验——构建和优化 ML 训练流水线、测试假设、消融研究、超参数优化等。借助触发器(webhook、定时器、调度),Tangent Shell 能监控流水线执行、执行深度实验计划。Agent 知道如何在丰富的 UI 里操作,也知道如何渲染可视化产物(Markdown、PNG、HTML)。
Shell 是开源的。Agent Bundles(把提示、工具、技能、工作流、触发器打包成套)可以在不改核心代码的前提下扩展它。
六、一个真实案例
Shopify 用 Tangent 端到端重建了一个大型 reranking(重排)模型。一位工程师设定方向(试哪些特征、加什么训练数据),并在每一步审查结果;Tangent 负责构建、运行和分析实验。走完整个循环,它尝试了一连串改动,并把每一项都与上一个最好结果做对比:
| 步骤 | Agent 改了什么 | R@90% 精度 | R@95% 精度 | R@97% 精度 |
|---|---|---|---|---|
| 旧的流水线 | 之前的蒸馏训练、标准特征和数据集 | 67.3% | 54.4% | 33.6% |
| + 标准化流水线 | 迁移到可复现的训练器(效果持平,但支持快速迭代) | 69.5% | 51.9% | 35.2% |
| + 更丰富的产品特征 | 加入结构化元数据、分类法、文本描述和预测属性(单项提升最大) | 71.3% | 58.7% | 48.5% |
| + 更多更难的训练数据 | 加入搜索派生、采样和难负例对 | 75.6% | 60.2% | 43.9% |
七、开源与参与
Tangle、Tangent 技能、托管平台和 Tangent Shell 全部以 Apache 2.0 授权发布。开发在 GitHub 上公开进行,项目接受新子 Agent 技能、Agent Bundle 和核心修复的 PR。
Tangle 由它的创建者 Alexey Volkov 维护,Shopify 是项目的初始赞助方和基础设施托管方。如果你做了觉得对他人有用的子 Agent 技能或 Agent Bundle,欢迎提 PR。
八、在哪里找到 Tangle 和 Tangent
Tangle 官网:https://tangleml.com/
Tangle 源码仓库:https://github.com/TangleML/tangle
Tangle CLI 与 Tangent 技能:https://github.com/TangleML/tangle-cli
Tangent Agent 托管平台:https://github.com/TangleML/tangent
Tangent Shell:https://github.com/TangleML/tangent-shell
原文来源: Linux.com
https://www.linux.com/news/shopifys-tangle-and-tangent/
作者:Alexey Volkov, Bo Li, Ben Chen, Maksym Yezhov, Pete Luferenko, and Volv Grebennikov – Shopify
*本文由内容创作助手整理。*
版权声明
本文仅代表作者观点,不代表本网站立场。
本文系作者授权本网站发表,未经许可,不得转载。



发表评论