DeepSeek-V4.1-Flash-1017 发布:跑分涨了一截,API 价格没动
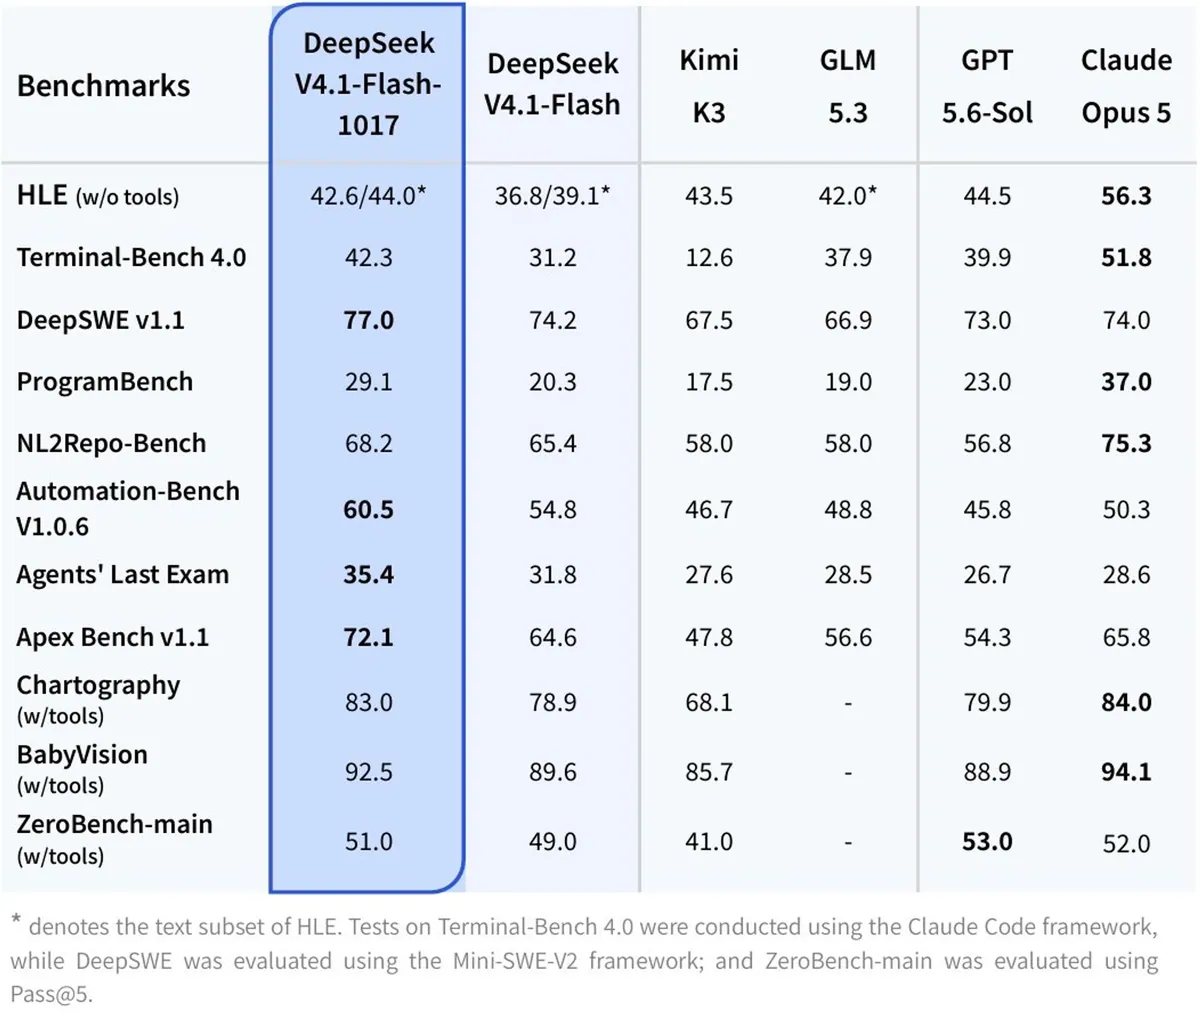
10 月 17 日,DeepSeek 在 X 上宣布 V4.1-Flash-1017 上线,网页端、App 和 API 三处同时切到新版本。官方给的说法是:跑分更强、任务完成更快、输出更短,性能和成本同时占优。
这不是新一代模型,是给 V4.1-Flash 打的一次带日期的补丁式更新。但分数上的变化不算小。
一、分数涨在哪
对比上一版 V4.1-Flash,几乎每个评测项都在往上走:
| 评测项 | V4.1-Flash | 1017 版 |
|---|---|---|
| HLE(无工具) | 36.8 | 42.6(纯文本子集 44.0) |
| Terminal-Bench 4.0 | 31.2 | 42.3 |
| DeepSWE v1.1 | 74.2 | 77.0 |
| ProgramBench | 20.3 | 29.1 |
| NL2Repo-Bench | 65.4 | 68.2 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 |
| Agents’ Last Exam | 31.8 | 35.4 |
| Apex Bench v1.1 | 64.6 | 72.1 |
| Chartography(带工具) | 78.9 | 83.0 |
| BabyVision(带工具) | 89.6 | 92.5 |
| ZeroBench-main(带工具) | 49.0 | 51.0 |
涨幅最明显的是命令行 Agent 这一类:Terminal-Bench 4.0 一次加了 11.1 个点,ProgramBench 从 20.3 跳到 29.1。按第三方对模型卡表格的整理,这两项已经压过 GLM-5.3 和 GPT-5.6 Sol,而 Opus 5 在 HLE 这类纯知识推理上仍然领先。
二、特点:同样的活,花得更少
官方这次强调的不只是分数,还有效率:新模型完成任务的时间更短,输出长度也更短。
这两件事直接决定账单。Agent 跑一个任务,往往要来回几十轮,每轮都在计费;输出短一截、少绕几个弯,token 消耗就跟着降。分数还高了,等于单位成本的产出变多。DeepSeek 管这个叫性能-费用上的帕累托改进。
配套方面,官方点名优化了 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等几个 Agent 工装。用 Harness 的人需要升到 0.2.1-rc.1 或更高版本才能拿到完整效果。
三、价格:单价不动,单次任务降
按 API 定价页,模型名还是 deepseek-flash,调用方式不变,价格也没调:
| 项目(每百万 token) | 谷时 | 峰时 |
|---|---|---|
| 输入(缓存命中) | $0.003 | $0.006 |
| 输入(缓存未命中) | $0.15 | $0.30 |
| 输出 | $0.60 | $1.20 |
同一个页面上的 deepseek-v4-pro,输出价是谷时 $1.98、峰时 $3.96,Flash 大约只有它的三分之一。上下文 1M、最大输出 384K、并发上限 2500,这些也和之前一致。旧模型名 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 还能用,请求会被转到 1017 版,按 Flash 价格计费。
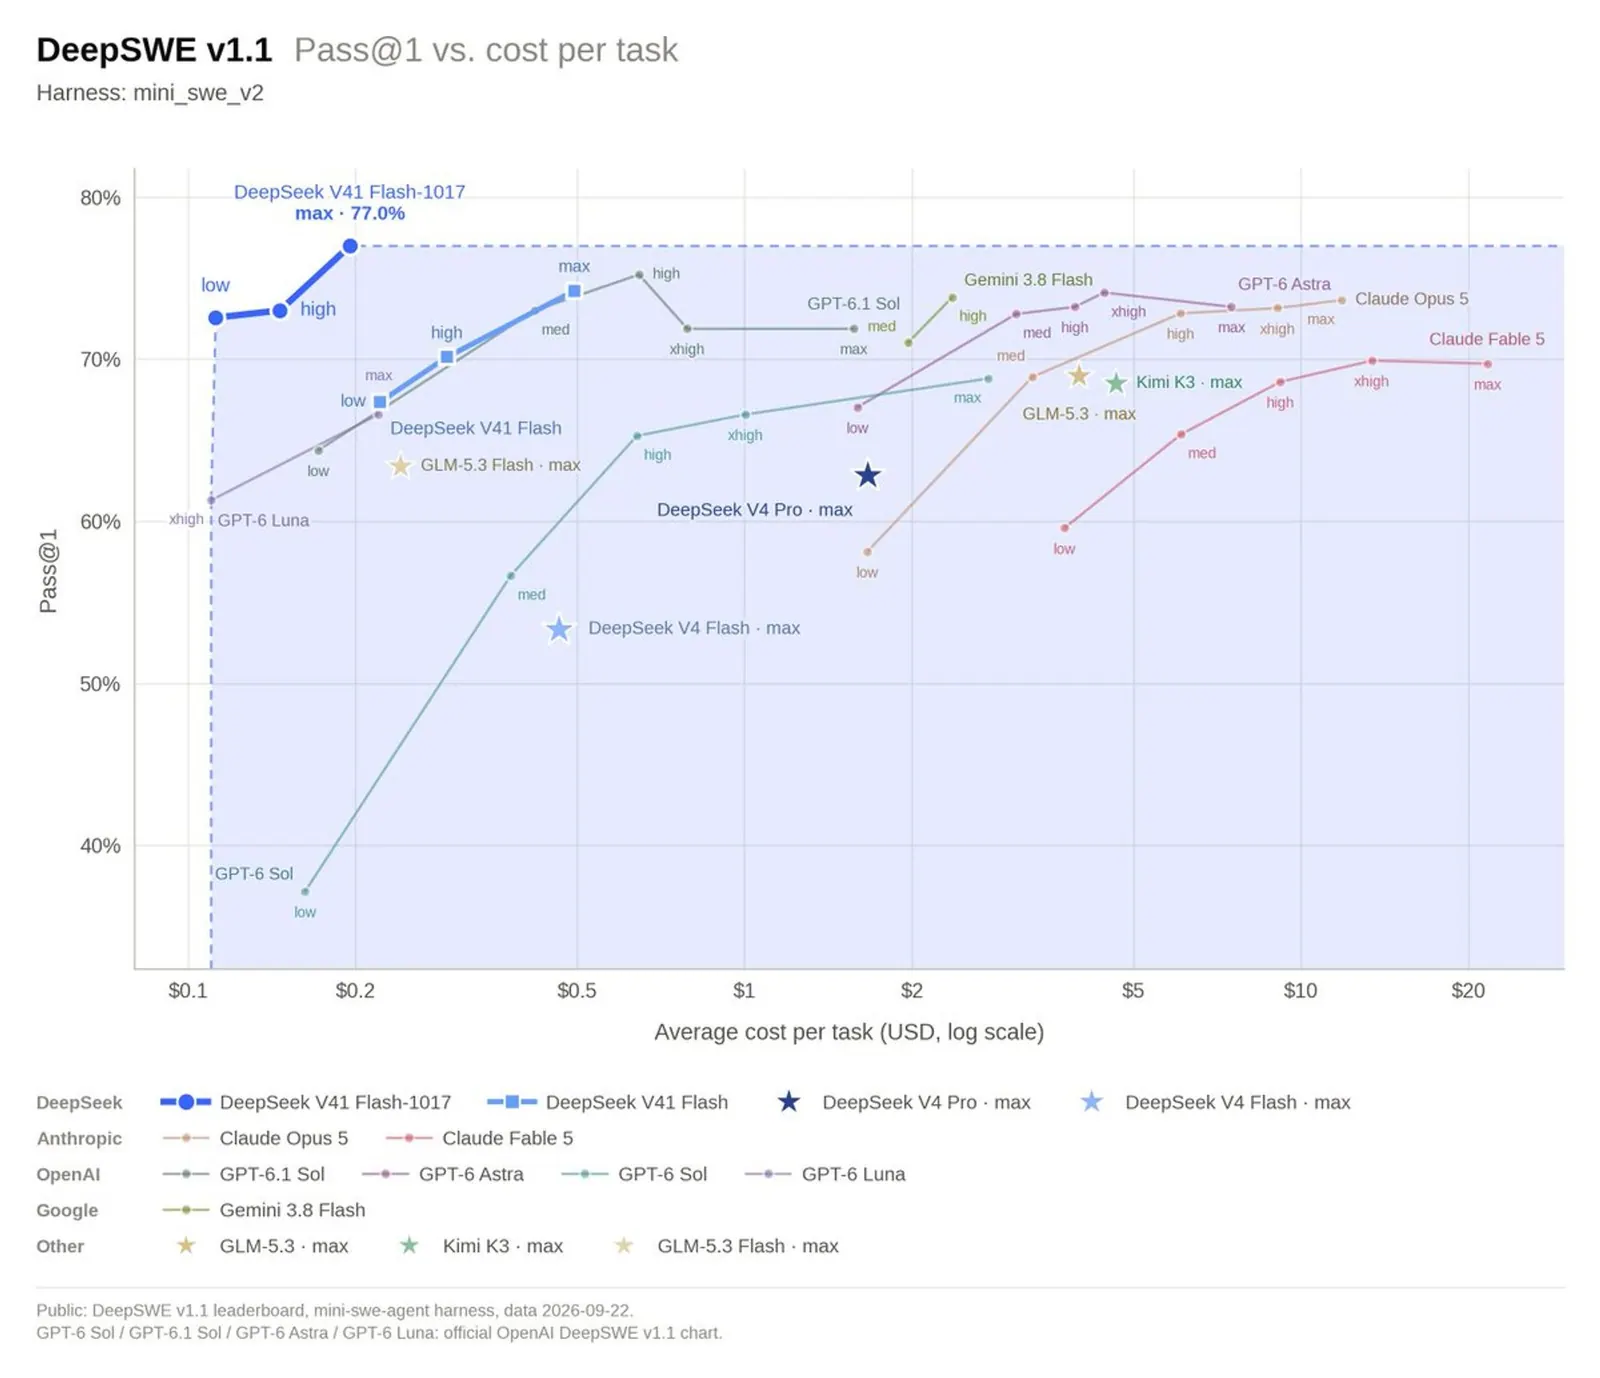
真正拉开差距的是单任务成本。在官方那张 DeepSWE 性能-费用散点图里,1017 版落在 77.0% 通过率、每任务一到两元的位置;上一版是 74.2%、三到四元。据第三方对这张图的拆解,Claude Opus 5 在同档约 74%、每任务约 80 元,GPT-6.1 Sol 约 73%、约 10 元。
四、怎么用上
API 直接调 deepseek-flash 就是新模型,不需要改代码。权重以 MIT 协议开放在 Hugging Face,FP8 量化,48 个 safetensors 分片。这次没有带 Jinja 聊天模板,官方给的是 encoding 目录下的 Python 参考实现,以及面向生产的 Rust 工具包 deepseek-recipe。
官方更新日志见 这里。