GenCAD:一张渲染图进去,一段能改的 CAD 建模历史出来
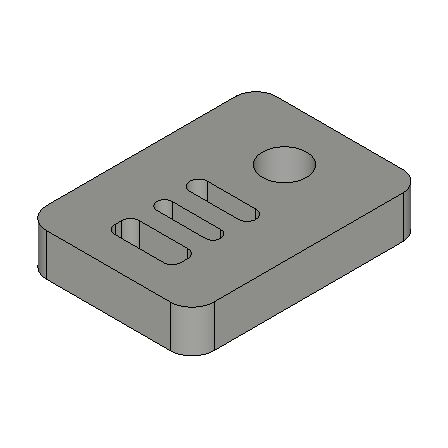
在 CAD 里建一个零件,靠的是几十上百步操作:画草图、拉伸、倒角、布尔。每一步都带着尺寸和约束,这件事到今天还是手工活,也很占工程师的时间。
用 AI 绕过去的研究不少,但多数停在「生成一个 3D 形状」:网格、体素、点云。看着像,拿不进设计流程——改不了一个孔的直径,也没法在仿真里保住工程精度。麻省理工机械工程系的 Md Ferdous Alam 和 Faez Ahmed(DeCoDE 实验室)做的 GenCAD 换了个目标:输出的不是形状本身,是造出这个形状的整段命令历史。项目主页在 gencad.github.io,代码在 GitHub,论文挂在 arXiv:2409.16294,TMLR 2025 接收,有 OpenReview 版。摘要里给出的定位很直接:把图像输入变成参数化 CAD 命令序列,换来可编辑的 3D 形状。
一、难的地方不在渲染,在数据结构
CAD 的底子是 B-rep(边界表示):一堆面、边、顶点,加上它们之间的拓扑和几何约束。这种表示精确、可编辑,也正是它难学——拓扑一变,命令序列就面目全非。而网格、体素、点云天生好收集、好训练,代价是把「怎么造出来的」丢掉了。
GenCAD 走参数化命令序列这条路。一段 CAD 程序被拆成一个个命令,每个命令是一个 17 维向量:1 维命令类型加 16 维参数,用不上的参数补位掩码;参数值量化成 8 位整数,这样就能当词元喂给语言模型那一套。生成出的序列再交给几何内核(实现上用 pythonocc / OpenCASCADE)重建实体,得到能打开、能改尺寸的 B-rep,而不是一坨三角面。
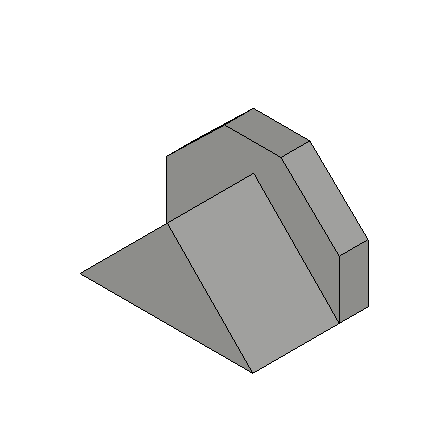
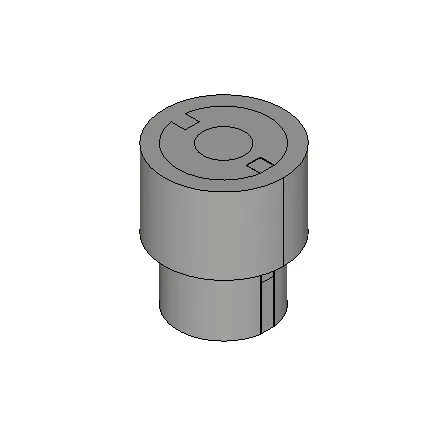
输入的图像就是上面这种 448×448 的渲染图,也支持手绘草图。
二、四个部件拼起来
GenCAD 不是一个大网络端到端训出来的,而是四个部件分别训练:
1. CSR(命令序列重建) 用自回归 transformer 做编解码。编解码器各 4 层自注意力、8 个注意力头,把整段命令序列压成一个隐向量;解码器再把它还原成命令。这块一共 6.72 M 可训练参数。所谓自回归,是训练时按顺序一步步预测,后一个命令依赖前一个,所以长序列不至于崩掉。
2. CCIP(CAD-图像对比预训练) 对比学习,把同一零件的图像隐向量和命令序列隐向量拉近,把不匹配的推远,用的是 NT-Xent 损失。图像编码器试了 ResNet-18、更深的 ResNet 和 ViT,ResNet-18 那版整体 28.22 M 参数。训练时 CAD 编码器是冻结的,只训图像侧,所以这 28.22 M 大部分落在图像编码器上。这一步是后面所有条件生成的地基:两个模态先得对得上话。
3. CDP(CAD 扩散先验) 在隐空间上跑扩散,不在像素上跑。条件是图像隐向量,去噪 500 步。它没用图像生成里常见的 2D U-Net,因为这个空间里的样本是向量,试的是 MLP 一类的结构。
4. 解码器 把扩散出来的隐变量交回 CSR 的解码器,吐出参数化命令序列。
训练规模不算夸张,全部在单张 80GB A100 上跑:CSR 1000 个 epoch(学习率 1e-3,batch 512),CCIP 300 个 epoch,CDP 100 万步(学习率 1e-5,每 2 步累积一次梯度)。数据用 DeepCAD 数据集,178,238 个 CAD 模型。
三、实测数字
论文的评测分三块,对照组都是同一数据集上的公开基线。
命令重建(对比 DeepCAD 的自编码器):命令类型准确率 µcmd 99.51% 对 99.36%,参数值准确率 µparam 97.78% 对 97.59%,平均 Chamfer 距离 0.762 对 0.783,无效形状比例 3.32% 对 3.44%。提升幅度不大,论文的解释是自回归编码在长序列上更稳。
图像检索 CAD 程序:
| 候选池规模 | GenCAD 命中率 | ResNet-18 图像相似度 |
|---|---|---|
| 10 | 98.49% | 77.70% |
| 128 | 91.41% | 19.26% |
| 1024 | 70.28% | 5.21% |
| 2048 | 60.77% | 3.91% |
池子放大到 2048 个 CAD 程序还能命中六成,论文说比纯图像相似度准 15 倍以上。论文把检索当成独立的一块成果,理由是「拿渲染图反查建模程序」在 CAD 社区里是长期没解决的问题。主页上的演示更直观:从约 7000 个 CAD 程序里挑出最像的前 3 个。
生成质量(COV 越高越好,MMD、JSD 越低越好):GenCAD 无条件 78.27 / 1.44 / 3.94,图像条件 81.37 / 1.38 / 3.49,草图条件 82.59 / 1.33 / 3.53。对照的 DeepCAD 是 78.13 / 1.45 / 3.76,SkexGen 78.17 / 1.55 / 4.89,ContrastCAD 78.93 / 1.44 / 3.67。Brepgen 的 MMD、JSD 更好(1.05 / 1.22),但 COV 只有 73.10——保真度上去了,多样性掉了。FID 方面 GenCAD 图像条件版是 0.13,无条件 0.22、草图条件 0.32,DeepCAD 是 0.87。
四、三种用法
主页上有一段官方演示视频,把「图像进、CAD 程序出」的过程串起来看更直观。
条件生成是主线:给图像或草图,出建模历史。论文另外演示了两件附带的事。一是同一张图能出多个解——扩散模型本来就带随机性,做方案时想要的正是「多给几个思路」。二是检索:把一张渲染图丢进去,从几千个 CAD 程序里按概率排出最像的几个。
五、短板与上手
论文自己承认的短板是数据:DeepCAD 里的命令相对简单,真实工程里那套复杂特征还没覆盖,团队下一步打算构建更贴近实际的 CAD 数据集。所以现在的 GenCAD,更像把「CAD 程序也能像语言一样生成」这条路验证通了,离替代建模师还有距离。
想自己跑一遍,代码是开源的。作者的主页在 ferdous-alam.github.io,GitHub 是 ferdous-alam。数据集和预训练权重放在 Google Drive,链接在仓库 README 里;环境可以走 Docker,也可以 conda 手动装:
conda create -n gencad_env python=3.10 -y
conda activate gencad_env
conda install -c conda-forge pythonocc-core=7.9.0
pip install -r requirements.txt
训练按三段跑,对应上面四块里的前三块:
python train_gencad.py csr -name test -gpu 0
python train_gencad.py ccip -name test -gpu 0 -cad_ckpt "model/ckpt/ae_ckpt_epoch1000.pth"
python train_gencad.py dp -name test -gpu 0 -cad_emb 'data/embeddings/cad_embeddings.h5' -img_emb 'data/embeddings/sketch_embeddings.h5'
推理在无头服务器上要套一层 xvfb,导出渲染图加 -export_img;仓库里还附了个 stl2img.py,把 STL 批量转成 PNG。README 的评测那一节,目前还写着 Coming soon。
如果你的期待是让 AI 参与设计,而不是把设计师换掉,这类「输出命令序列」的路线值得盯住:改一个参数,模型还是那个模型,不用整块重新生成。