轻量本地 TTS 能走多远:实测 Hojo-TTS-Light 的 40M 与 80M
AI 助手念出一段短回复、网站把文章转成音频、App 播一条语音通知——三件事都叫 TTS,但对模型的要求完全不是一回事。
也不是每个应用都需要一个大模型或者一个托管语音 API。轻量、能本地跑的 TTS 才因此有意思:开发者直接拿着模型用,自己决定语音在哪生成,不必把整条链路交给外部服务商。
@HuggingModels 这篇实测就围绕 HojoAI 的开源项目 Hojo-TTS-Light 展开:两种规格(40M、80M)分别适合干什么,短句、对话、长文拼接三种任务跑下来手感如何。
一句话结论:40M 在短的英文段落上最有用——多音色都能出可懂的语音,对话文本也撑得住;80M 加上参考音频,把项目推向个性化语音。两者都不要求你从一套依赖云端的大系统起步。
一、它到底提供了什么
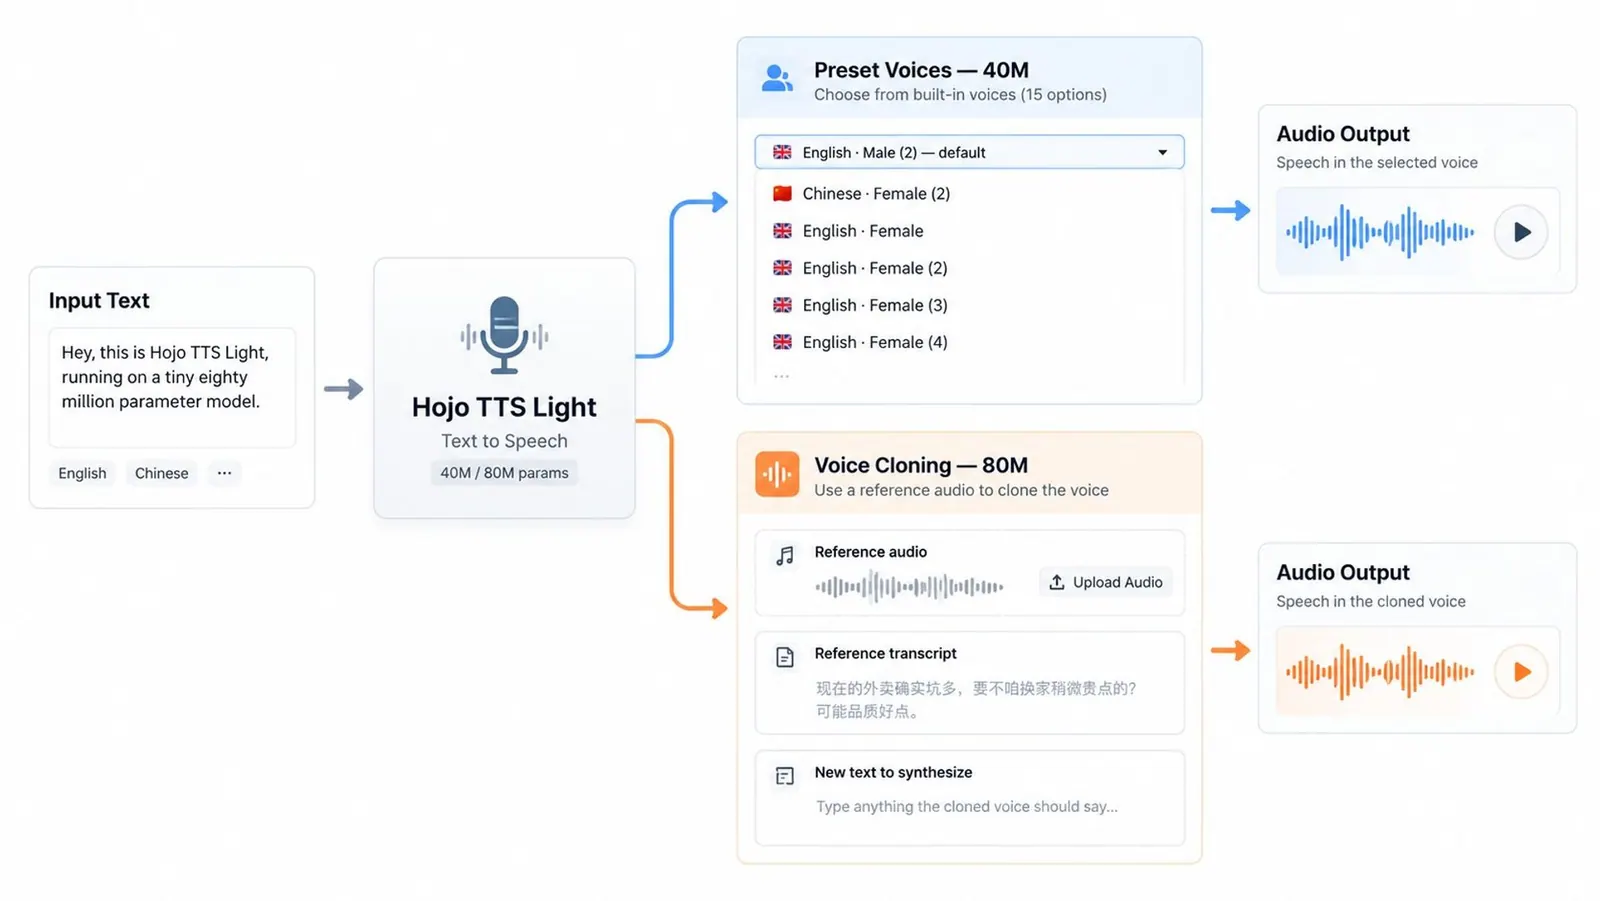
Hojo-TTS-Light 建在 Token-LM 架构上,目前两个公开规格:
| 规格 | 定位 | 音色 |
|---|---|---|
| 40M | 预设音色生成 | 内置 15 个:13 个英文 + 2 个中文 |
| 80M | 参考录音条件下的语音生成 | 用你给的样本,而不是只能挑预设说话人 |
两个都支持中英文。模型文件在 Hugging Face,推理实现发布在 GitHub;项目还提供面向本地执行的 ONNX 包,其中 40M 有 CPU 推理路径。
纸面上这些能力都挺好看。但开发者真正要问的是:落到一个能搭出来的东西上,它是什么样。
我顺手核了一遍仓库(原文没写)
| 项 | 实测值(2026-10-26 查询) |
|---|---|
| 仓库 | HojoAI/Hojo-TTS-Light |
| 星数 / Fork | 611 ★ / 9 |
| 语言 / 许可证 | Python / Apache-2.0(README:可学术、个人、商业二次开发) |
| 最后推送 | 2026-10-19 |
| 建库时间 | 2026-05-08 |
README 补了两个原文没提的关键细节:语音分词器是 18M 编码器 + 30M 解码器,所以「40M / 80M」指的是核心语言模型骨干,不是整条推理链路的参数量;当前版本跑 50 Hz token 速率,12.5 Hz 版本标注为「即将发布」。路线图里流式合成、情绪与风格控制、多语种多方言都还是未勾选状态——想拿它做情感语音的,先别急。
二、场景一:给 AI 助手配个声音
想象一个助手,任务是汇总已完成的工作或者回应用户请求。回答可能就这么一句:
Your report is ready. I found three items that may need your attention.
应用把生成好的文本喂给 TTS,播出音频。链路是:生成文本 → 语音合成 → 音频回复。这是本地 TTS 最直接的用法,也正好对上 40M 表现最好的短文本区间。
40M 的预设音色让这条链路不用先准备参考说话人,也不用搭一套定制音色的流水线。
同一段文本,换两个声音
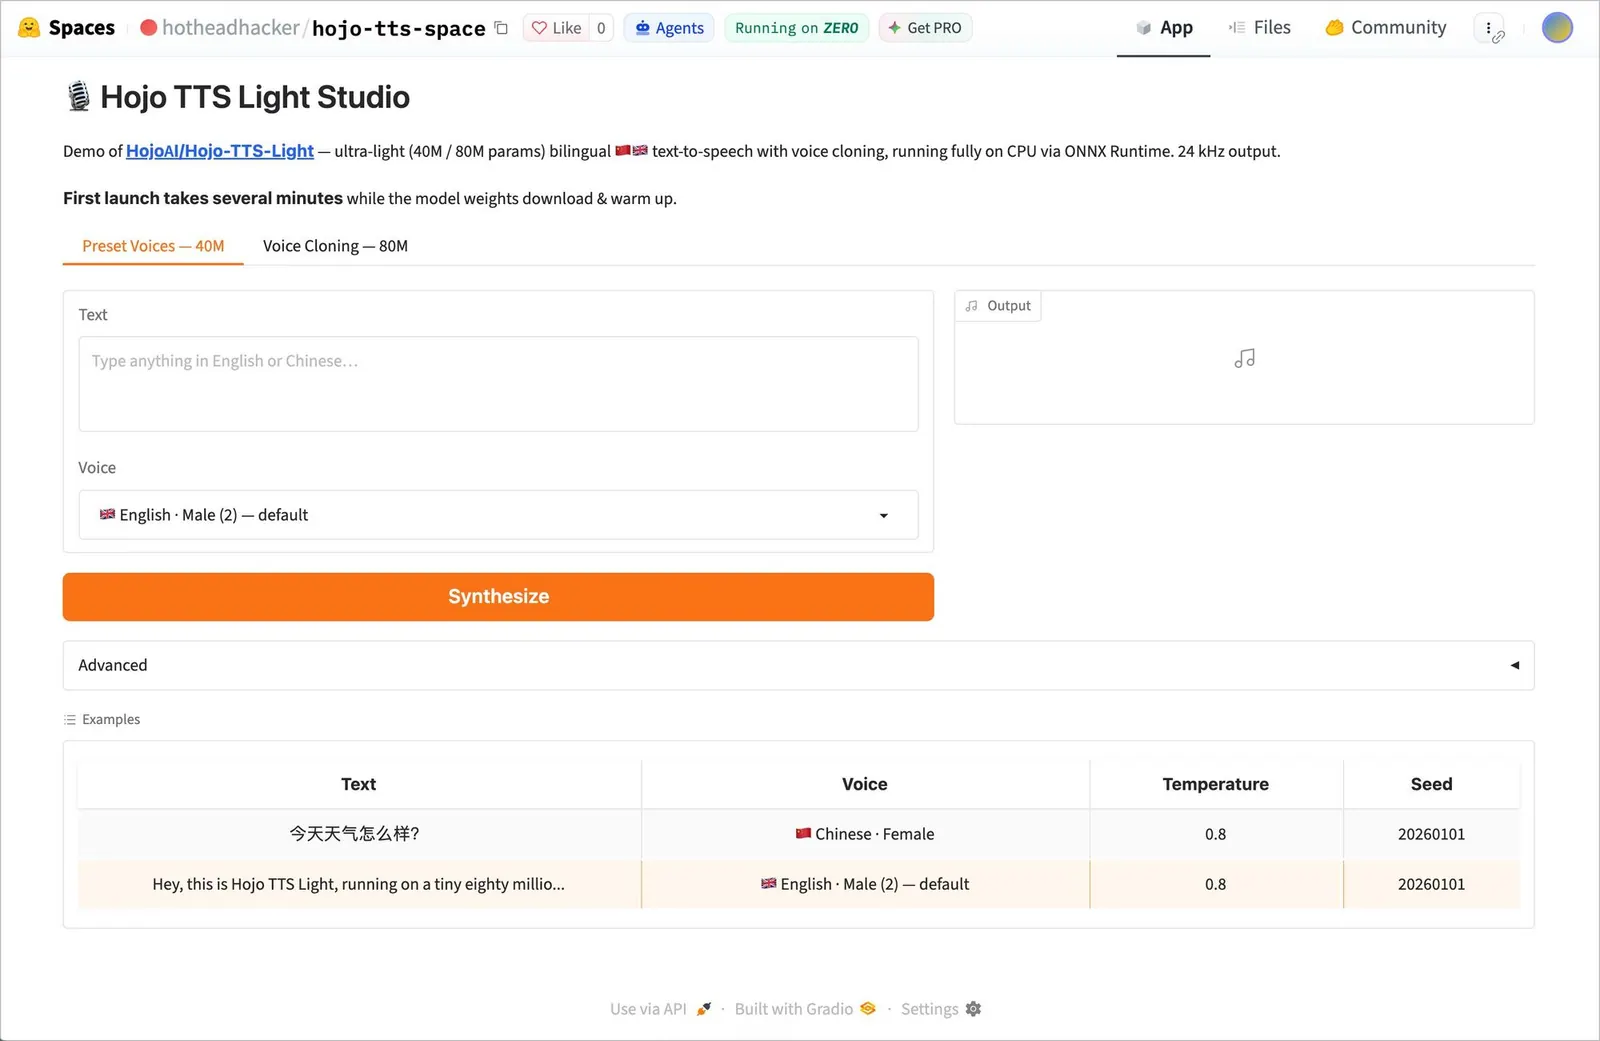
为了看音色差别,先做一个受控测试:同一段英文旁白,用两个不同的预设说话人各生成一遍。
两段都听得懂,声音特性和表达方式差别明显,虽然文本一模一样。
这在给应用挑音色时很有用:朗读工具可能适合某个说话人,对话型助手可能适合另一个。用同一段文字横跨多个音色试听,是最省事的评估方式。15 个预设也意味着不用先录自己的参考音频,就能把多个说话人选项过一遍。
三、场景二:从规整朗读到对话口吻
真实的助手回复很少是结构完美的句子。里面有问句、口语表达、标点,句子长短也在变。这些细节直接影响合成出来自不自然。
第二个测试换成对话文本,再换两个英文音色:
两段在对话交换里都保持可懂。
清晰度是这批短测试里比较稳定的优点。 至于自然的节奏、重音、表现力,这些更主观,要更全面的测试才能评。对语音助手回复、简短说明、语音交互界面这类应用来说,先听得懂是最重要的起步条件——目标不一定非得是长篇朗读或者很强的表演性。有时候模型只需要把一句短回复变成能用的音频。这也正是 40M 在这个测试里最有说服力的地方。
四、场景三:把文字内容变成音频
另一个实用方向是朗读:网站给短文配个音频版、学习平台把讲义念出来、阅读应用给文档某几节生成音频。
这类工作流带来另一个挑战:内容可能比一条助手回复长得多。
一个办法是分段生成,再把音频拼起来。作者的做法是分别生成旁白片段,把两段录音合成一个试听样本:
- English Narration Sample:听 WAV
这一段是两段独立生成的录音拼起来的,不是一次不中断的推理。
它演示了一种可行的分段朗读流程:按可处理的段落生成,再合成更长的试听。对做文章朗读器的开发者来说,这条路值得试。
但它也带来单个音频片段之外的问题:句子边界要处理好,段落之间的停顿要自然,音色要前后一致,拼起来还得流得顺。测试显示,较短的输入通常结果更稳定,这也是分段方案特别值得试的原因。
作者没有把「文章转音频」整个应用做出来,这些录音只覆盖了其中的语音生成环节。
五、80M:超出预设音色的个性化语音
预设音色适合「应用需要一个现成说话人」的场景。但有些产品要的是某个特定声音,而不是从音色库里挑一个。
80M 版本引入了参考音频条件下的语音生成:不选预设音色 ID,而是给一段参考录音、对应的转写文本,以及要合成的新文本。
Hojo 把这项能力称为几秒音频的语音克隆,支持中英文合成,也支持两种语言之间的跨语种生成。
和普通预设 TTS 相比,它的应用方向不同:个性化助手可以用选定的参考说话人;互动角色可以在统一的音色身份下生成对白;朗读应用可以探索贴合内容的音色。
对这类应用,参考录音本身成了关键输入——它的质量、对应转写的准确度、要生成的文本,三者都影响结果。
Hojo 在 80M 的公开仓库里放了参考录音,包括英文男声、英文女声、中文女声,还有一段中英混说示例。
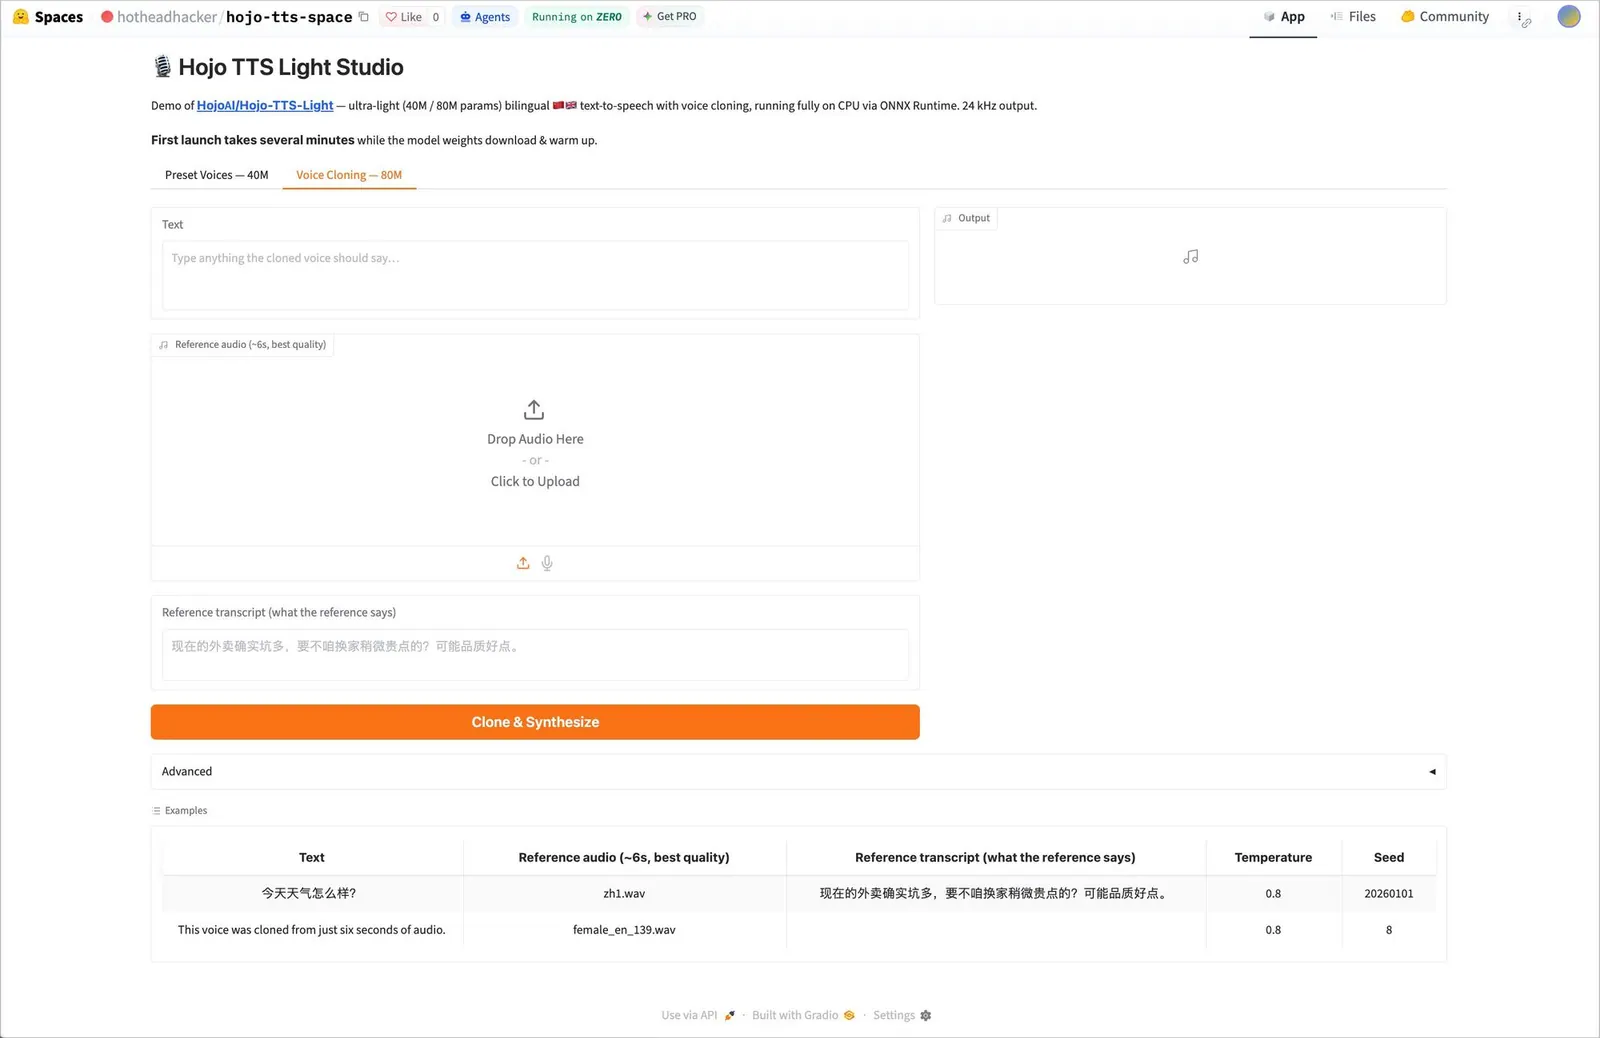
混说示例正好对上 Hojo 的双语路线。想试个性化语音的开发者,可以拿自己的参考素材跑——前提是拿得到说话人的授权。
六、在本地跑起来
Hojo-TTS-Light 的一个特点是推理栈是公开的:权重通过 Hugging Face 分发,GitHub 给出对应实现和安装说明。
40M 用 ONNX Runtime,输出 24 kHz 单声道,支持 CPU 推理——也就是说不用专门配一块 GPU 就能开始试。
流程不复杂:拿到模型文件 → 配好推理环境 → 选音色 → 给文本 → 生成音频。仓库同时提供命令行和 Python 两种推理接口。
如果你的应用要产出大量短语音回复,可以在推理实现外面套一层本地语音生成;做朗读就往分段处理上靠,最后拼接。
推理代码给的是零件,剩下的体验——文本处理、音频播放、各种对接——由应用开发者自己负责。
实际生成速度和内存占用取决于硬件、运行时配置和输入长度。原文没给具体数字;我也没在本机跑(纯 CPU 环境,没按它的说明装环境),所以这里不编一个数。另外要记住前面说的:40M / 80M 指的是骨干语言模型,完整推理链还有别的组件,部署时按整条链路算。
Hojo 还文档化了基于拼音的发音纠正——针对容易读错的多音字和专有名词。这对处理专业文本(药名、人名、型号)的应用挺实用。
许可证是 Apache 2.0,可以按条款自由使用和二次开发。
七、这些模型最适合用在哪
| 场景 | 建议 | 要注意 |
|---|---|---|
| AI 助手短回复 | 40M + 预设音色 | 短文本正是它稳定的区间 |
| 语音通知 / 界面播报 | 40M | 输入短,一致性最好 |
| 朗读工具、旁白 | 40M,分段生成再拼 | 节奏与前后音色一致是难点 |
| 个性化语音体验 | 80M + 参考音频 | 参考录音质量、转写准确度、授权 |
| 本地开发与原型 | 两个都行 | 有模型文件和推理代码,比只能调托管接口灵活 |
这些场景的期待值本来就不同,所以拿真实输入去评,比只看参数量有意义得多。
八、实测结论与局限
40M 跑下来,三个观察最突出:
- 短语音是最明确的强项。 不同预设音色都能出可懂的英文旁白,短回复这类任务正对口。
- 对话文本仍然可懂。 样本能看出模型处理口语对话和变化句式的方式;但表现力是否稳定,需要更广泛的测试。
- 分段朗读值得一试。 按段落生成再拼,是长内容的一条可行路线,同时要顾到连续性和剪辑。
80M 靠文档化的克隆流程和中英双语能力补上另一个维度,Hojo 也公开了示例。
需要写清楚的一点:Hojo 报告该模型族在 Seed-TTS 评测集上平均 DNSMOS 高于 4.0(我核对过 GitHub README,确有这条)。这是项目方自报的基准,和作者自己的听感是两回事——DNSMOS 是自动指标,不能替代人耳对韵律和表现力的判断。
作者也明说了:这些测试不是正式基准,只是回答一个更实际的问题——开发者能在哪些地方用上它,生成结果又说明了什么。
九、上手资源
- GitHub 仓库:https://github.com/HojoAI/Hojo-TTS-Light
- 40M 实现与推理指南:https://github.com/HojoAI/Hojo-TTS-Light/tree/main/Hojo-TTS-Light-40M
- 80M 实现与录音:https://github.com/HojoAI/Hojo-TTS-Light/tree/main/Hojo-TTS-Light-80M
- 40M 模型(Hugging Face):https://huggingface.co/HojoAI/Hojo-TTS-Light-40M
- 80M 模型(Hugging Face):https://huggingface.co/HojoAI/Hojo-TTS-Light
- HojoAI 官网:https://hojo.ai/
说明:本机网络访问不到 huggingface.co,两个模型页我只核了链接形式,没做内容核对;GitHub 仓库的星数、许可证、推送时间都是 2026-10-26 现查的。
十、判断
重点不在模型够小。重点是开发者拿得到它:用自己的输入生成、自己听结果、再决定怎么放进应用。
如果你的产品经常需要语音提醒、状态播报、助手短回复,40M 是个实在的起点:本地生成能减少对联网和托管 TTS API 的依赖,15 个内置音色让你不用先准备参考录音。
反过来,指望它直接念完一篇长文、或者做有强烈表演感的角色配音,目前还不合适——路线图上的情绪与风格控制、流式合成都没发布,长文要靠分段拼,一致性得自己守。