300 个 agent,一张图,和一个会改写自己的循环
“循环、图、动态工作流和例程——按照你实际该建的顺序来。”
今年我把同一套 agent 设置重做了四次,扔掉了三次。每一版能撑一周左右。
然后那些修正开始重复:同一个重名的公司又被合进了错误的节点,同样一个单薄的信息源又被当成了证据,周一打的同一条指令,周五我又打了一遍。
终结这个循环的,是给「修正」找了一个能住下去的地方。
一个系统能在两次运行之间变好,需要两件事同时成立:有东西能沉淀下来,也有东西能在它沉淀之前把不合格的活儿挡回去。循环工程给你第一件。
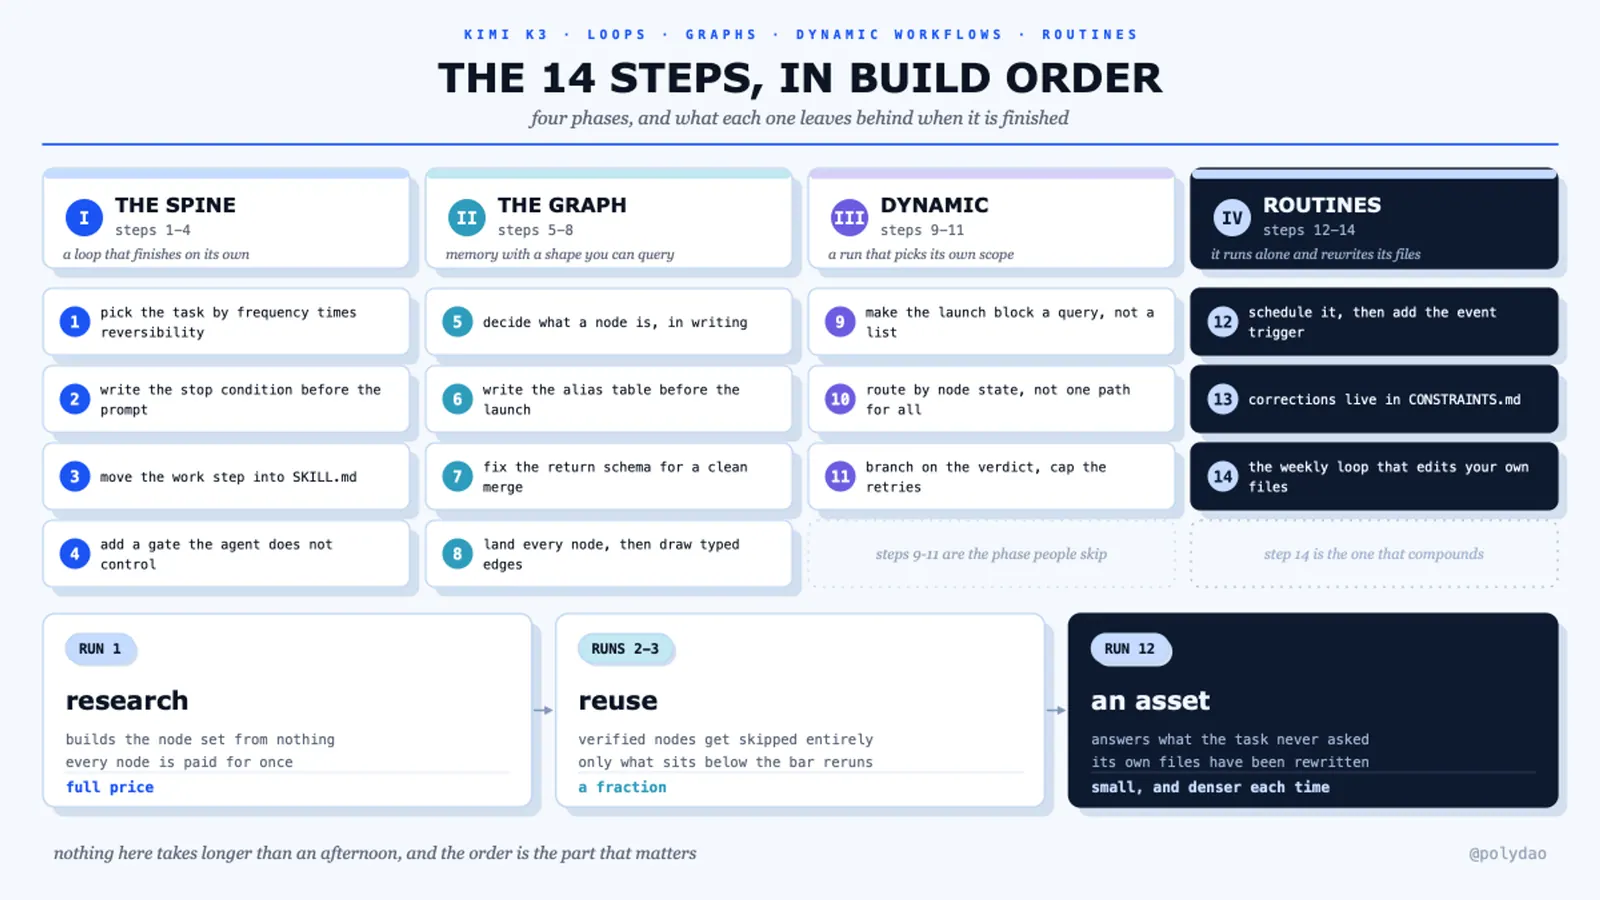
图工程给这份记忆一个可以查询的形状。例程让它在你不在场时也能跑。Kimi K3 的 Agent Swarm 提供了足够的并行容量——一个问题上最多三百个 agent——这才让搭这套结构本身变得划算。
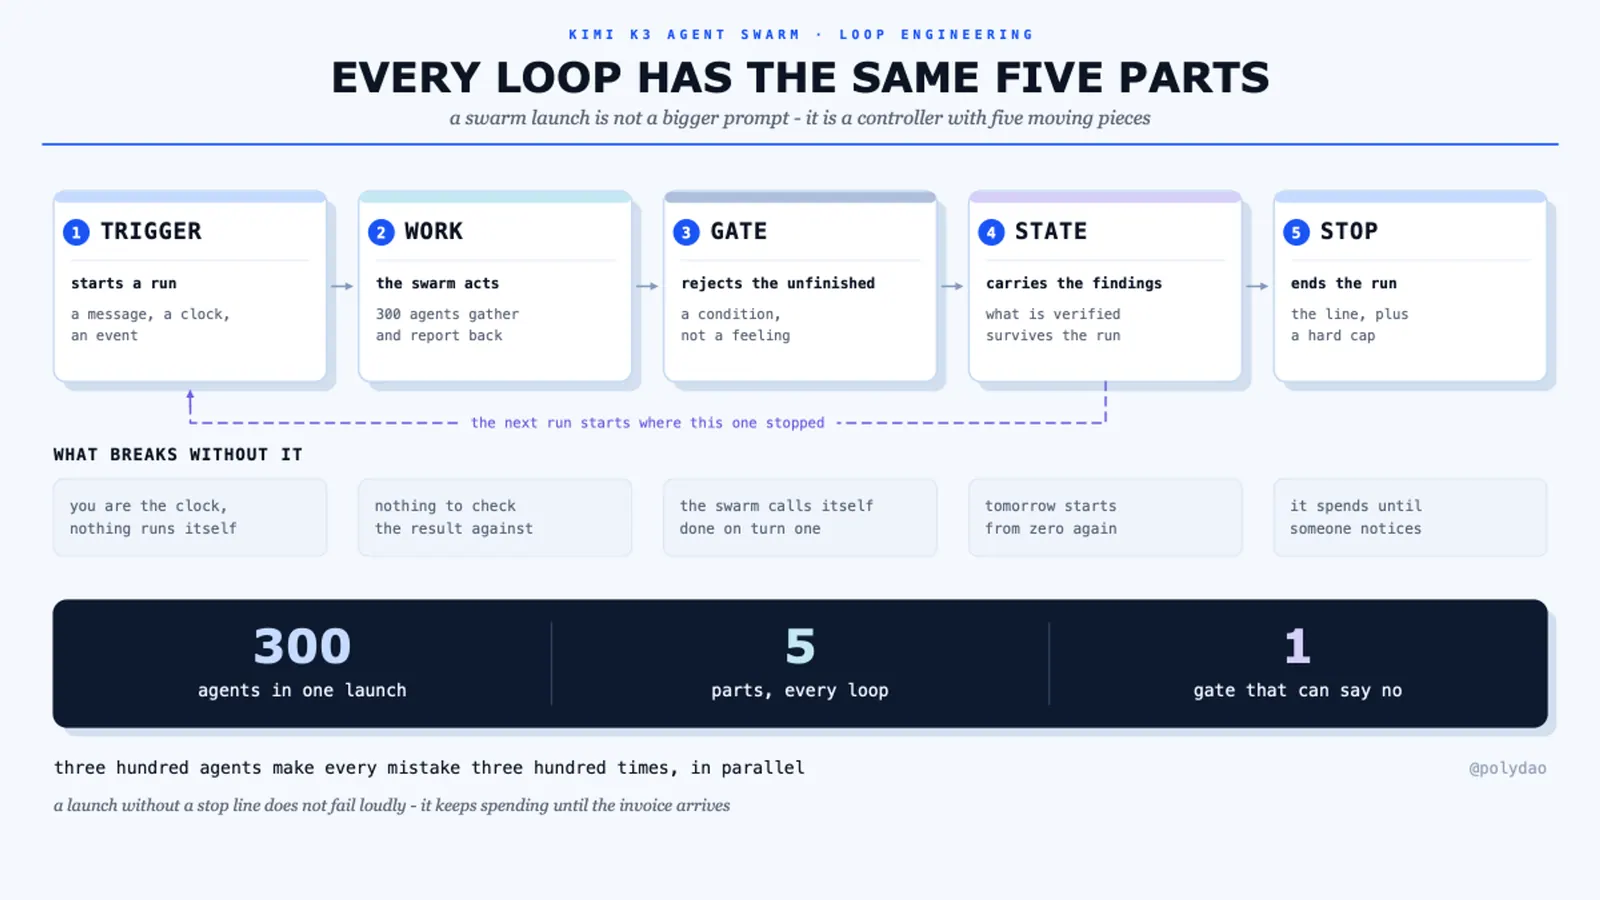
十四个步骤,按建设顺序排列。每一步要么是你写下的一个文件,要么是你立下的一条规则,没有一步超过一个下午。
| 阶段 | 步骤 | 产出什么 |
|---|---|---|
| 一 · 主干 | 1–4 | 一个能自己跑完、并且会拒收烂活儿的循环 |
| 二 · 图 | 5–8 | 有形状的记忆,而不是一份聊天记录 |
| 三 · 动态工作流 | 9–11 | 从图的状态自己决定本次范围的运行 |
| 四 · 例程与复盘 | 12–14 | 按计划跑,并且会改自己的指令 |
阶段一 · 主干
1 · 用「频率 × 可逆性」挑第一个任务
第一个任务决定了这套系统能不能活过第一个糟糕的星期。你要的是这样一件事:至少每周发生一次,一分钟内能验证,做错了也不用付出代价。
频率给你足够多的运行次数去看清模式,可逆性给你在公开场合犯错的余地。
竞品跟踪、更新日志监控、入站线索补全、信息源筛选,都合格。任何会发送、会付钱、会对外发布的事,这个月先不碰。
2 · 先写停止条件,再写提示词
agent 项目反复倒在同一个轴上:它们知道怎么开始,却不知道什么算做完。先把结尾写出来,写成一个机器能判断的形状。
STOP when either is true:
  - 40 nodes verified at 2+ independent sources each
  - 3 full passes completed with no new verified node
HARD CAPS: 300 agents · 45 min wall clock · 2 retries per node
ON CAP HIT: write 40-runs record, escalate the unfinished list, exit
停止条件由计数构成,而不是由形容词构成——这就是「一个循环」和「一个失控的进程」的区别。「直到研究充分为止」不叫停止条件。
3 · 把工作步骤从提示词里搬到 SKILL.md
提示词是你意图的一个样本,文件才是意图本身,有版本、可复用,而且 swarm 会最先加载它。
SKILL.md · entity research
STEPS: 1 identify → 2 pull primary sources → 3 extract fields → 4 self-check → 5 return
DECISION RULES:
  - filings and first-party docs outrank coverage of them
  - conflicting numbers: return both with dates, never average
SELF-CHECK before returning:
  - every field traces to a source line
  - confidence below 0.6 means return it flagged, not dropped
OUTPUT: the return schema in SCHEMA.md, nothing else
自检那一段,是让三百个 agent 不至于返回三百种格式的关键。它很便宜,在 agent 内部执行,能在机械错误到达你那道闸门之前先拦下来。
4 · 加一道闸门,并确保 agent 控制不了它
一个 agent 重读自己的输出时,会看到自己当初那么写的全部理由,于是它就批准了。K3 如此,Claude 如此,榜上每个模型都如此。真正能用的闸门必须在这次运行之外。
| 闸门类型 | 能抓住什么 | 成本 |
|---|---|---|
| 确定性脚本 | schema 崩坏、字段缺失、死链、数量不符 | 20 分钟,之后永久免费运行 |
| 全新上下文的校验者 | 证据单薄、认错对象、编造关系 | 一条提示词,每节点多一次调用 |
| 阈值规则 | 低于你在 SCHEMA.md 里设的置信度下限的一切 | 一行 |
| 人工队列 | 失败两次的那一小堆 | 你每天五分钟 |
按这个顺序跑。脚本是免费的,所以它应该在花一个 token 去做校验之前,把所有能拒的都拒掉。
阶段二 · 图
5 · 把「节点是什么」写下来
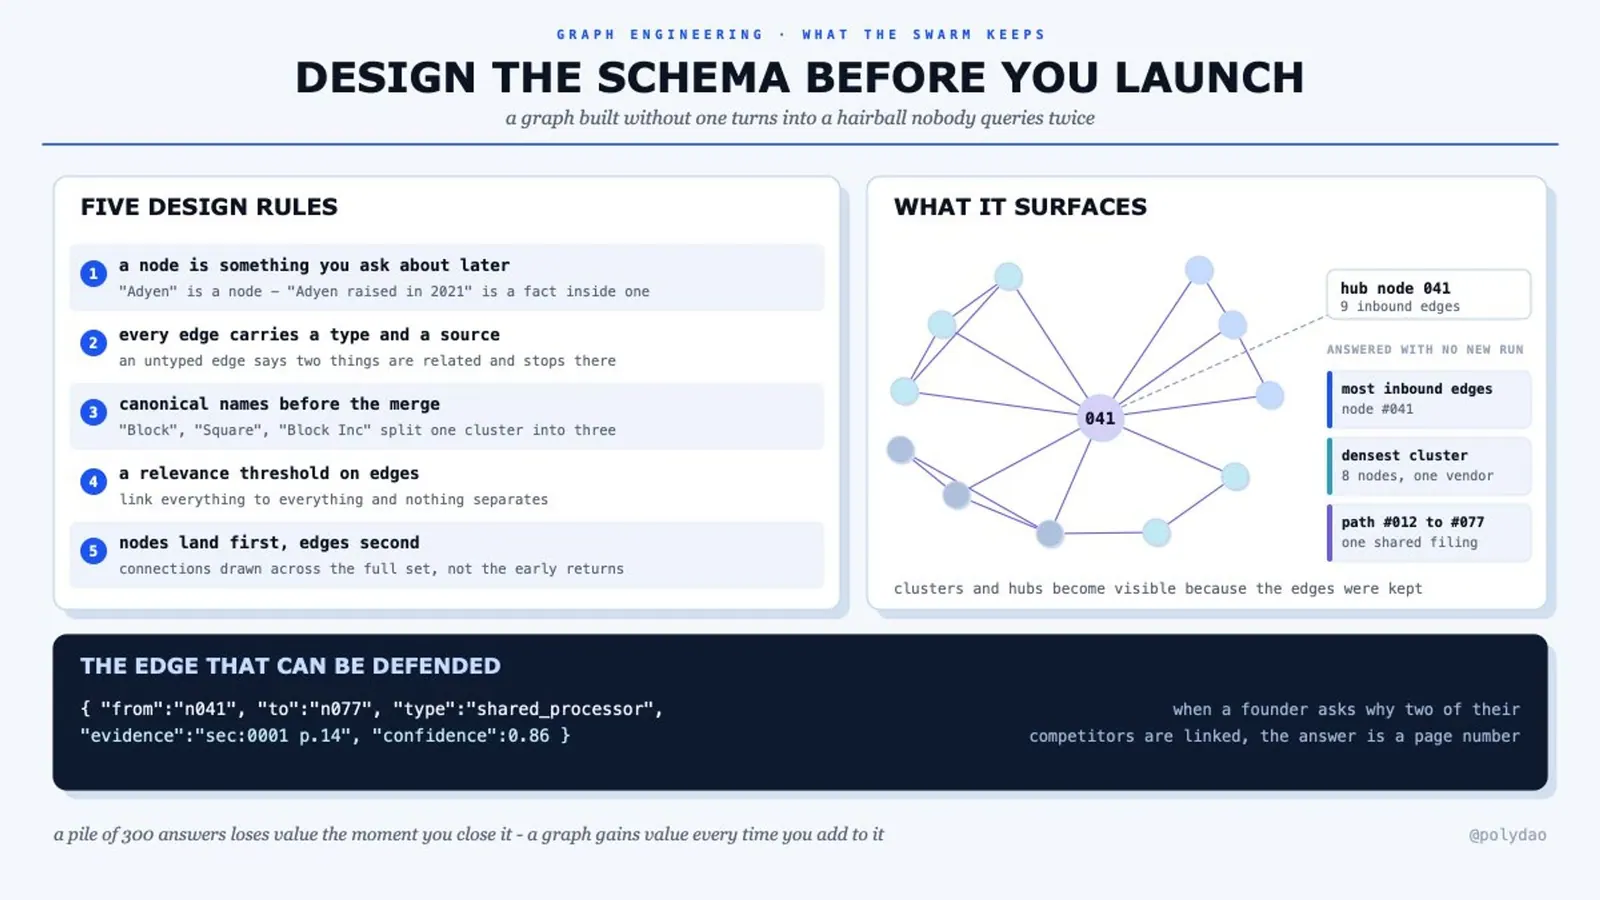
SCHEMA.md 里的这一行,决定了这套系统以后能回答哪些问题。节点是一家公司,或者一个人,或者一份申报文件,或者一个协议。每张图只选一种主类型,其余当属性处理。
SCHEMA.md
NODE TYPES:  company · person · filing · vendor · protocol
EDGE TYPES:  shared_investor · shared_vendor · shared_filing
             depends_on · supersedes · contradicts
THRESHOLD:   drop candidate edges below 0.6 confidence
VERIFIED:    a node counts at 2 independent sources
写一次,之后每一次针对任何一个市场的运行,产出的图都能用同样的方式合并和比较。
6 · 第一次启动之前先写别名表
“Block”、“Square” 和 “Block Inc” 作为三个节点进来,一个簇就被拆成了三个,而之后你跑的每一条查询都继承了这个错误。十分钟的 aliases.csv,保护的是投入三百个 agent 的那次运行。
它放在图之上而不是图之内,因为它是每一次未来启动的输入。每一个漏网的重复,在这里修一次就够了。
canonical,alias
Block Inc,Block
Block Inc,Square
Alphabet Inc,Google
7 · 固定返回结构,让合并保持确定性
三百个 agent 用散文回复,会把任何编排器撑爆。三百个 agent 用固定形状回复,合并的时候不需要任何判断,token 成本只是零头。
RETURN (per agent, nothing else):
  node_id · label · type
  sources: [max 3, url + date]
  candidate_edges: [target label + relation type + evidence line]
  confidence: 0-1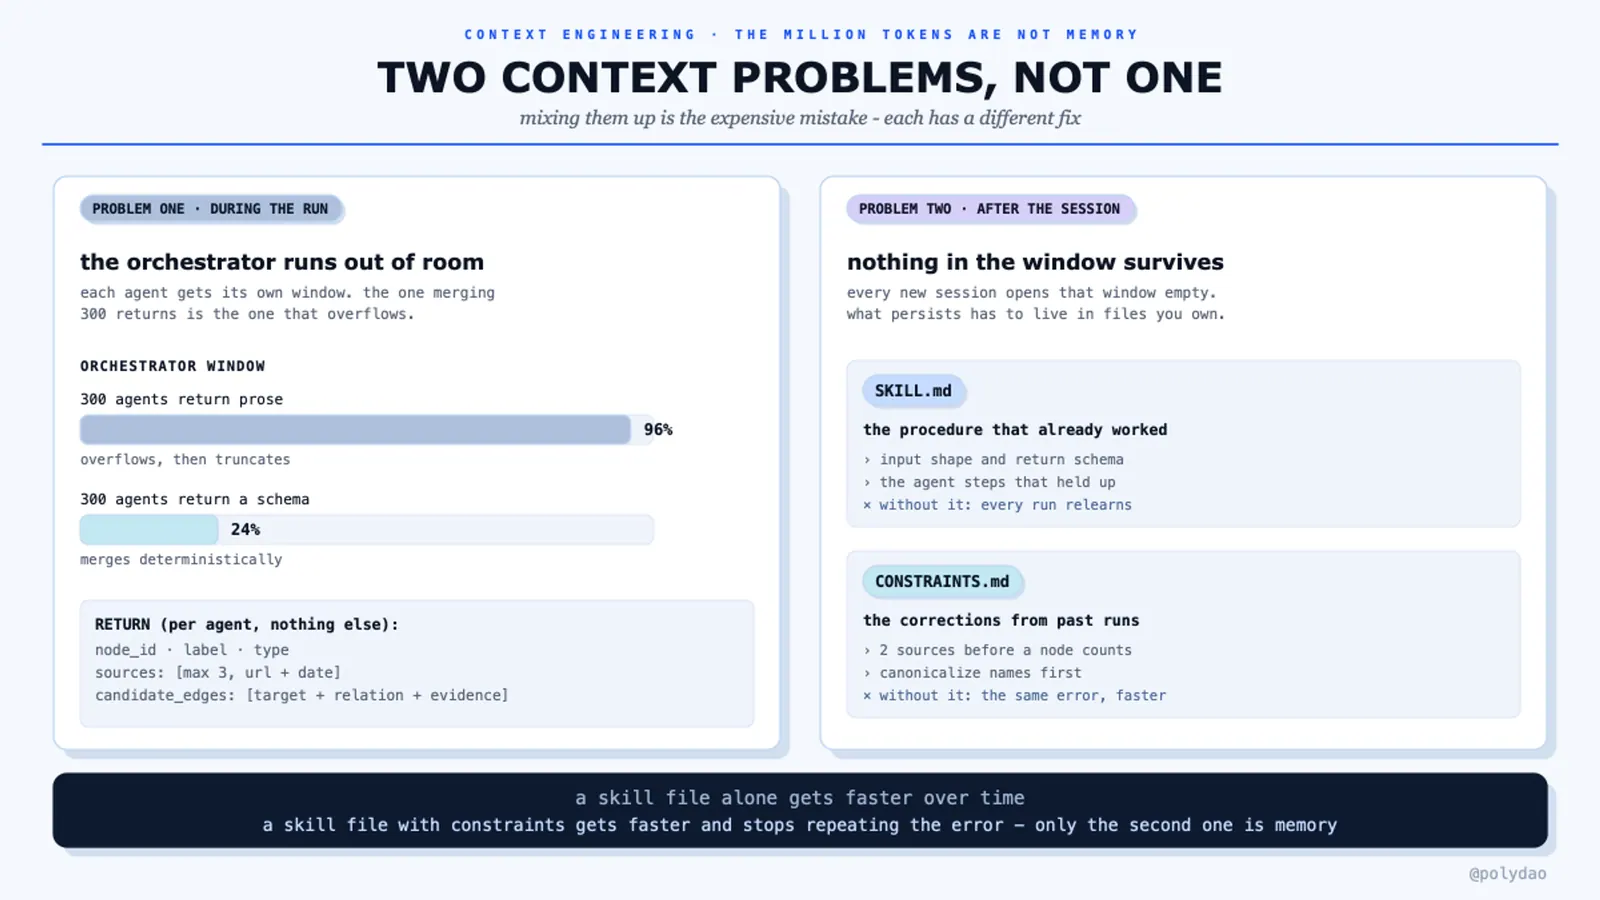
8 · 先把节点全部落地,再画第一条边
顺序工具会在读的过程中就发现关联,于是整张图会朝它先读到的东西倾斜。
swarm 则是先把完整的节点集铺出来,再一次性在整体之上推理。保持这个次序,并且给每条边配一行来源:
{ "from": "n041", "to": "n077", "type": "shared_processor",
  "evidence": "sec:0001 p.14", "confidence": 0.86 }
evidence 字段的意义在于:你可以带着客户沿着一个结论走一遍,而不是请他相信。
阶段三 · 动态工作流
这一段是大多数人会跳过的,而恰恰是静态自动化变成「会响应自己状态的东西」的地方。
9 · 把启动块写成查询,而不是清单
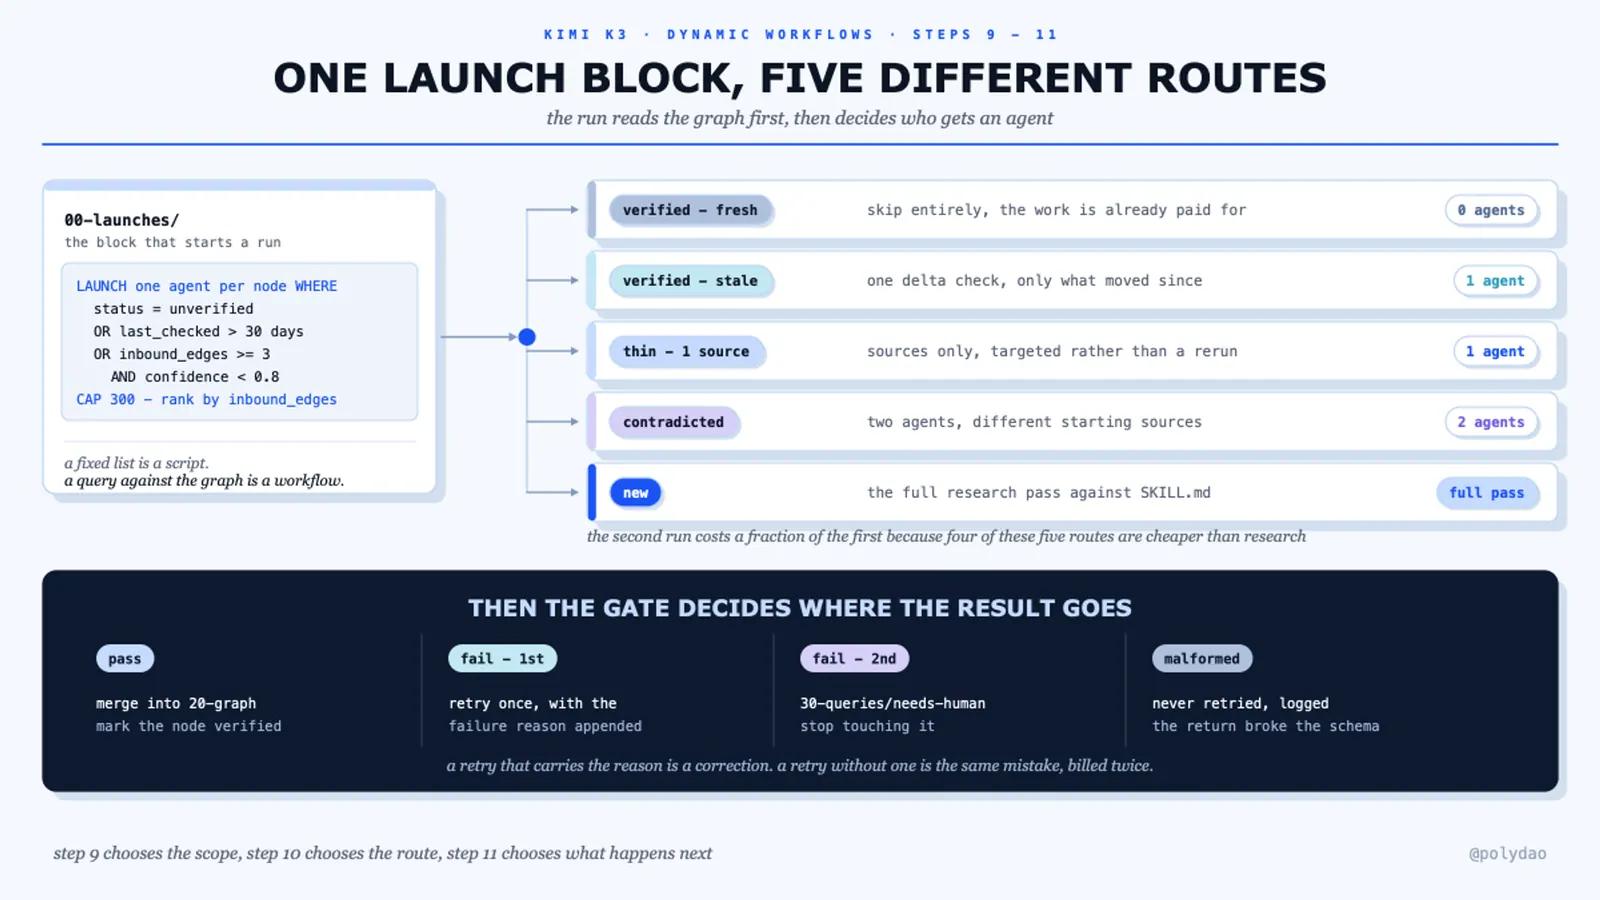
一个写死的四十家公司的清单是脚本。一个先读图再决定派谁的启动块是工作流——下周它会派出另一批 agent,而你什么都没改。
后半句正是「底下有一张图」的全部意义:系统按结构重要性给自己的任务排序,而不是按行号顺序。
LAUNCH: dispatch one agent per node WHERE
  status = unverified
  OR last_checked > 30 days
  OR inbound_edges >= 3 AND confidence < 0.8
CAP: 300. If the query returns more, take the highest inbound_edges first.
10 · 按节点状态分流,而不是所有东西走同一条路
| 节点状态 | 路径 | 为什么 |
|---|---|---|
| 已验证且新鲜 | 完全跳过 | 已经付过费了,没有理由重查 |
| 已验证但过期 | 一个 agent,只查增量 | 便宜,能抓住变化 |
| 单薄(只有 1 个来源) | 一个 agent,只补来源 | 精准,不做全量重跑 |
| 存在矛盾 | 两个 agent,从不同来源入手 | 分歧需要独立视角 |
| 全新 | 完整研究一遍 | 还没有任何可复用的东西 |
这张表就是第二次运行成本只有零头的原因。跳过已经定下来的活儿,是这套设置全部的经济性所在。
11 · 按判定结果分支,并给重试设上限
gate pass         → merge into 20-graph, mark verified
gate fail (1st)   → retry once, with the failure reason appended to the task
gate fail (2nd)   → write to 30-queries/needs-human.md, stop touching it
script fail       → never retried, the return was malformed, log and move on
不告诉 agent 哪里失败就重试,是循环把预算烧在同一个错误上的方式。把原因传回去,重试才会变成修正。
阶段四 · 例程与复盘循环
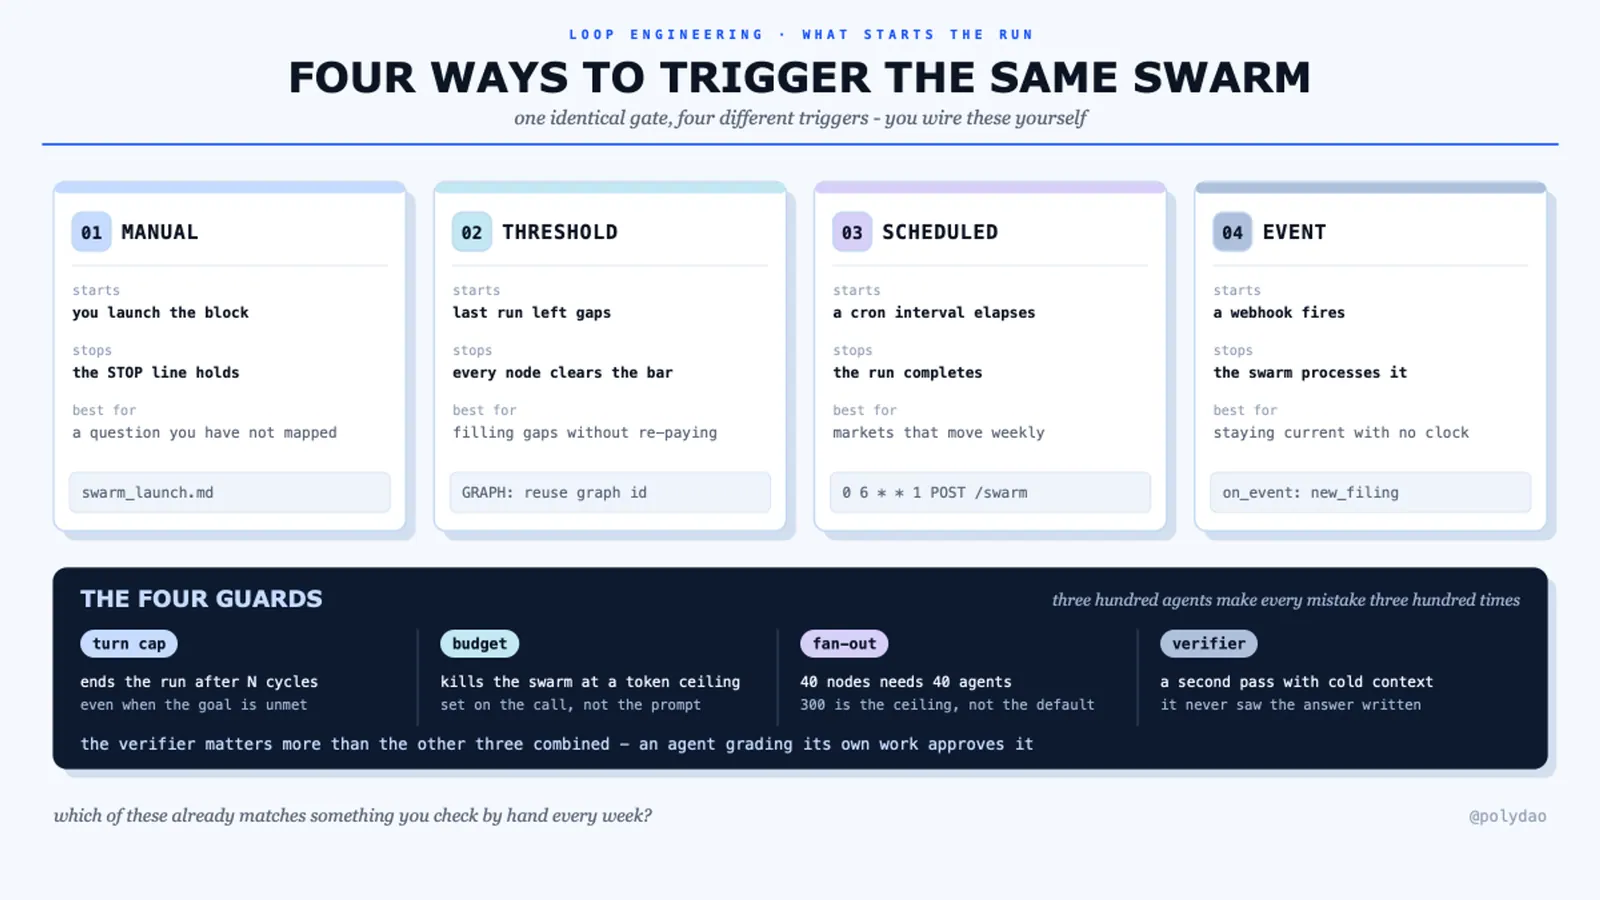
12 · 先排期,再加事件触发
ROUTINE weather-check
  schedule: Mon 07:00 Europe/Warsaw
  launch:   00-launches/mobile-payments.md
  budget:   120 agents, 30 min
  on-finish: write 40-runs record, post the diff to me
TRIGGER on new filing in the watched set → run the same launch, scoped to that entity
排期定下限,事件触发接峰值。
间隔要跟底层数据真实的变动速度匹配:一个月才变一次的市场不需要每天跑一次,为这个付钱的,是最常见的那种「agent 很贵」的结论来源。
13 · 给修正一个永久的家:CONSTRAINTS.md
这个文件是系统能变好、而不只是重复的原因。每次你纠正了什么,那条纠正就写进这里,而不是写进一条会消失的聊天消息。
CONSTRAINTS.md
2026-08-19 · press releases are not independent sources. Two releases = 1 source.
2026-08-24 · "acquired by" needs a filing or a company statement, never coverage.
2026-08-29 · subsidiaries roll up to the parent node unless they file separately.
每次启动时最先加载,第一周只有三行,第三个月会有三十行。每一条都是一个未来任何一次运行里、任何一个 agent 都不会再犯的错误。
14 · 跑那个改你自己文件的元循环
最后一步,是让整件事自我改进的那一步。每周一次,由一个 agent 读运行历史,对你拥有的那些文件提出修改。
保留审批环节。一个能不经审阅就改自己约束的 agent,早晚会把那条不方便的约束改掉,而且它能解释清楚为什么那样很合理。
WEEKLY REVIEW (one agent, fresh context):
  read: 40-runs/* from the last 7 days
  find: failure reasons appearing 2+ times
        nodes escalated to human more than once
        alias collisions caught at merge
  propose: edits to SKILL.md, SCHEMA.md, aliases.csv, CONSTRAINTS.md
  output:  a diff. You approve or reject. It never writes to those files itself.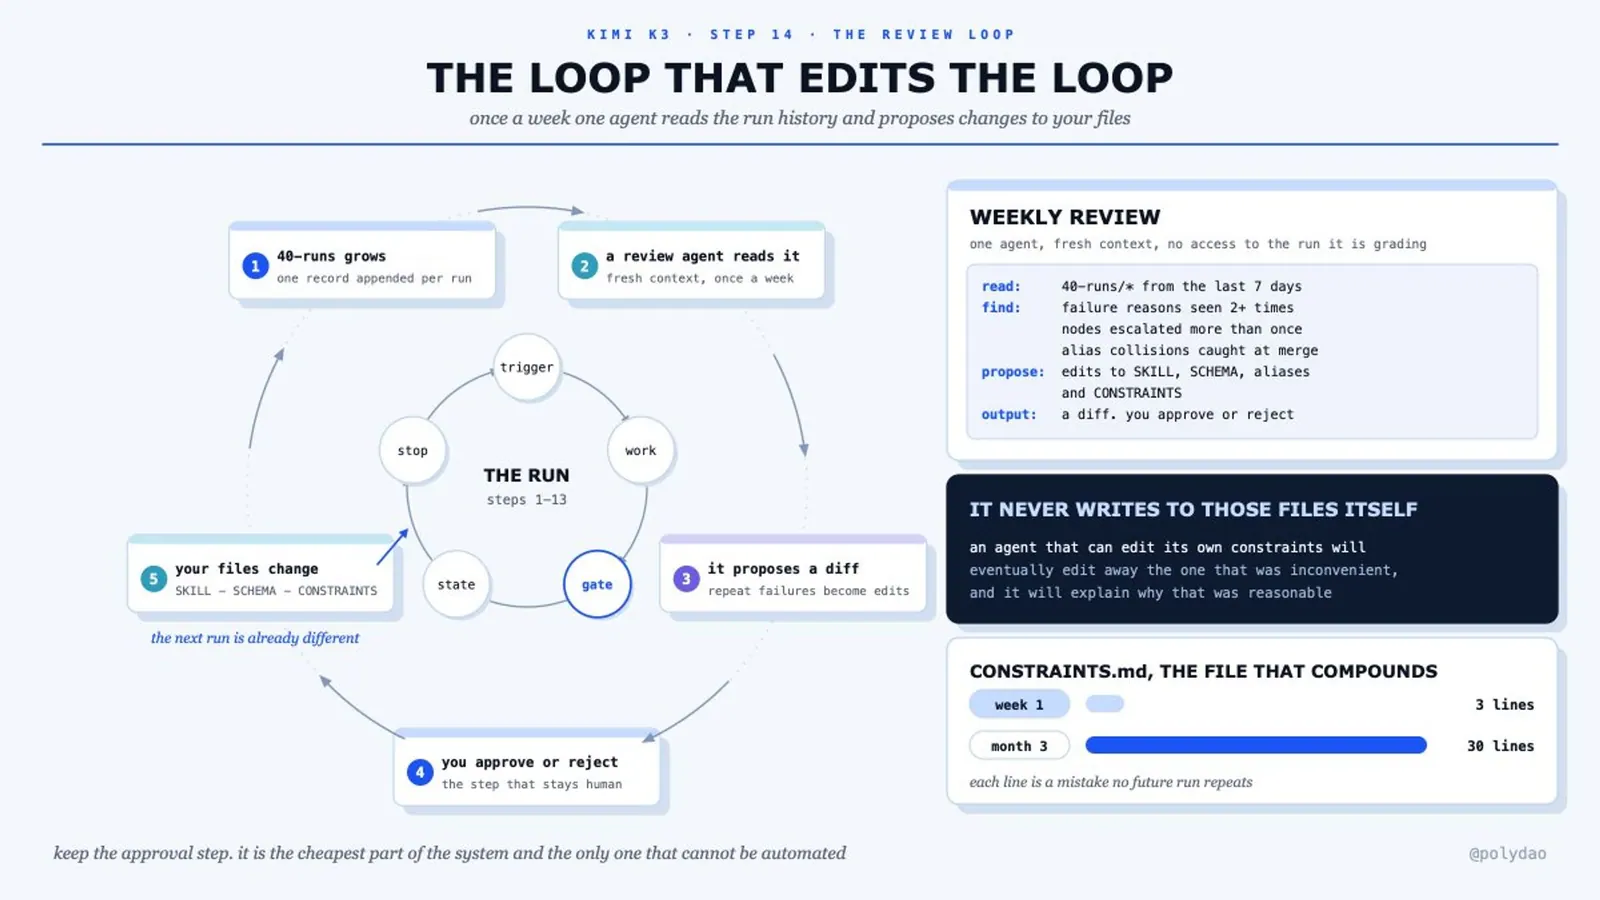
文件都放在一处
graph-workspace/
├── SKILL.md          你写      · 流程,最先加载
├── SCHEMA.md         你写      · 节点类型、边类型、阈值
├── CONSTRAINTS.md    你写      · 会延续下去的修正
├── aliases.csv       你写      · 规范名,合并前先查
├── 00-launches/      你写      · 每个问题一条启动查询
├── 10-returns/       swarm 写
├── 20-graph/         swarm 写  · nodes.jsonl · edges.jsonl · graph.md
├── 30-queries/       你问它答  · 含 needs-human.md
└── 40-runs/          只追加    · 第 14 步的输入
每个目录只有一个作者。数字前缀固定写入顺序,于是 returns 永远不会覆盖 launches,图也永远不会覆盖 returns。
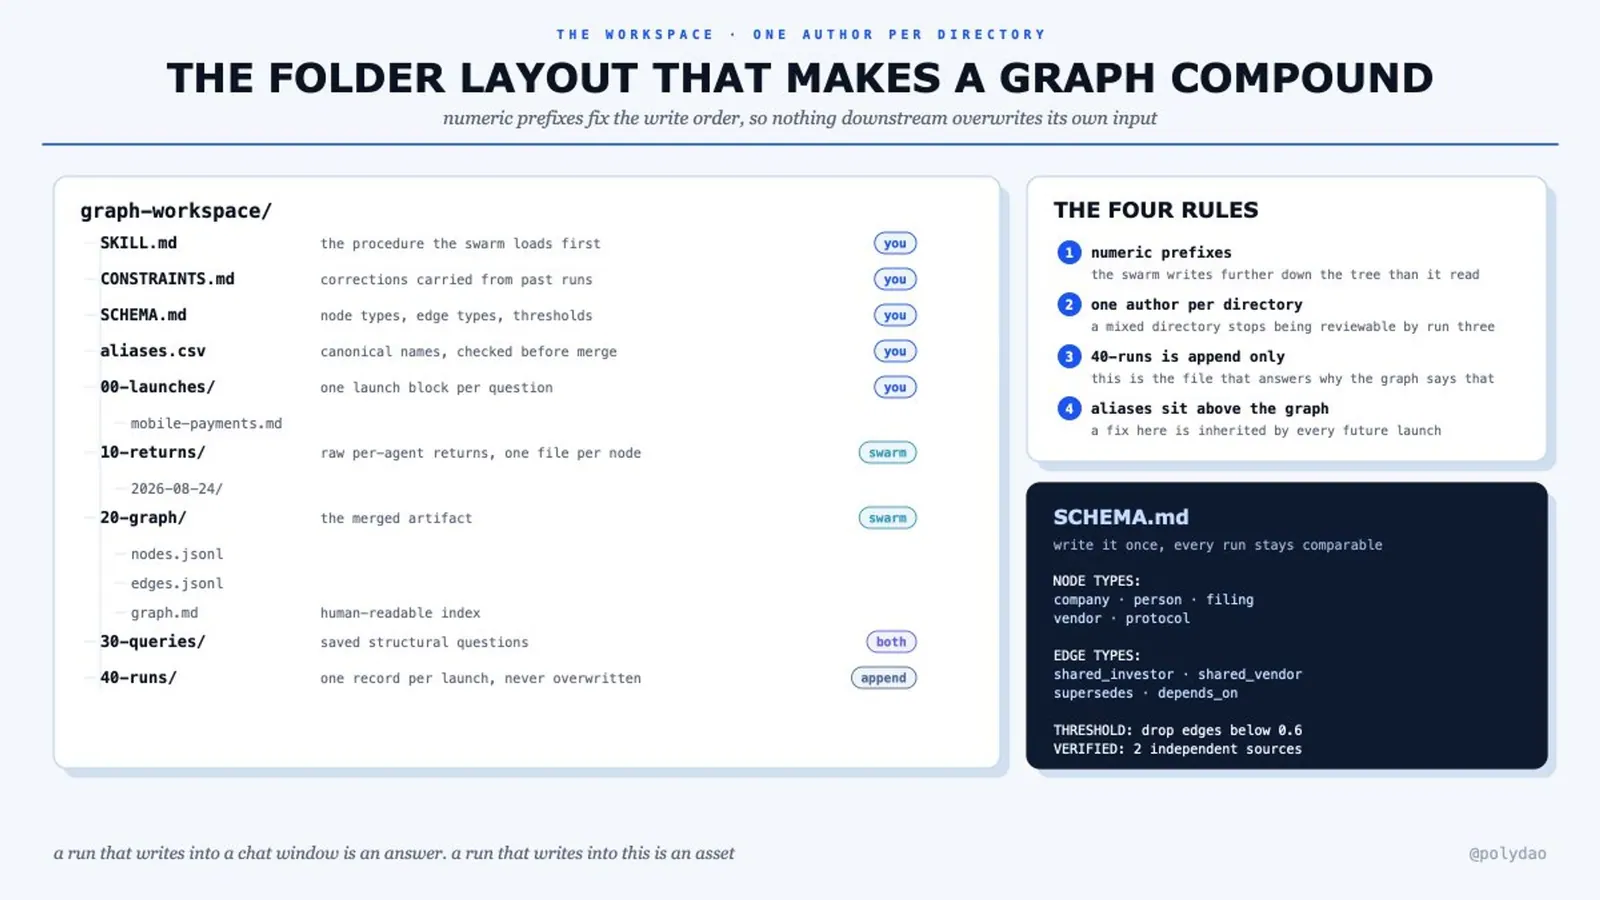
40-runs 只追加,因为六周之后,“图为什么会这么说”这个问题,要靠它来回答。
成本与回报
| 变现方式 | 它付给你什么 | 你需要先有什么 |
|---|---|---|
| 把市场地图当交付物卖 | 替掉一份四位数报价的分析师合同,一个下午交货 | 一张你熟悉的市场的图,端到端建完 |
| 活图的年费服务 | 每月费用:重跑、标出新边、重新验证变动过的部分 | 第一个客户的图已经在按计划运行 |
| 把工作区当产品卖 | 十四个步骤打包,用在别人的领域里 | 这套结构在两个不同市场验证过 |
第三个才是真正的生意。步骤不随领域改变,变的是 schema 和别名表。
建过两套的人,一上午就能替别人建第三套;而第 14 步意味着,他交出去的那套会在他离场之后继续变好。
短版
第 1 到 4 步,给你一个会收尾的循环。第 5 到 8 步,给它一个有形状的记忆。第 9 到 11 步,让它自己挑选要干的活。第 12 到 14 步,让它在你不在场时运行,并用自己的失败改写自己的指令。
第一次运行是调研。第十二次运行是一项资产,两者之间隔着的,是你一个下午写下的四个文件。
原文结尾
如果这篇对你有用,原文作者的建议是:把文章存下来当参考(链接会变,新仓库每周都在冒);想看 AI 架构、量化交易和 agent 经济的每周深度内容,可以关注 @polydao;也可以加入他的 TG 频道 Buzzoni Notes。