提示词只是第一层:把 Agent 工程拆成九层的一张地图
模型是所有人吵得最凶的部分,也是你真正在搭的东西里最小的一块。
这两句话是原作者(X 上 @distortgeekin)那篇长文的出发点。他连着写了九天,一层一篇,第九天把这九层拼成一张图:哪一层缺了会坏在哪、按什么顺序搭、怎么用一份 AGENT.md 全串起来。
他摆在最开头的是三组数字:
- Anthropic 测过「是什么让一个研究 agent 赢过另一个」,光看 token 用量就能解释 80% 的差距;
- LangChain 没换模型,只改了模型外围 —— 提示、工具、检查 —— Terminal Bench 2.0 上从 52.8% 到 66.5%;
- 提示工程只是这摊活里的第一层,后面还有八层。
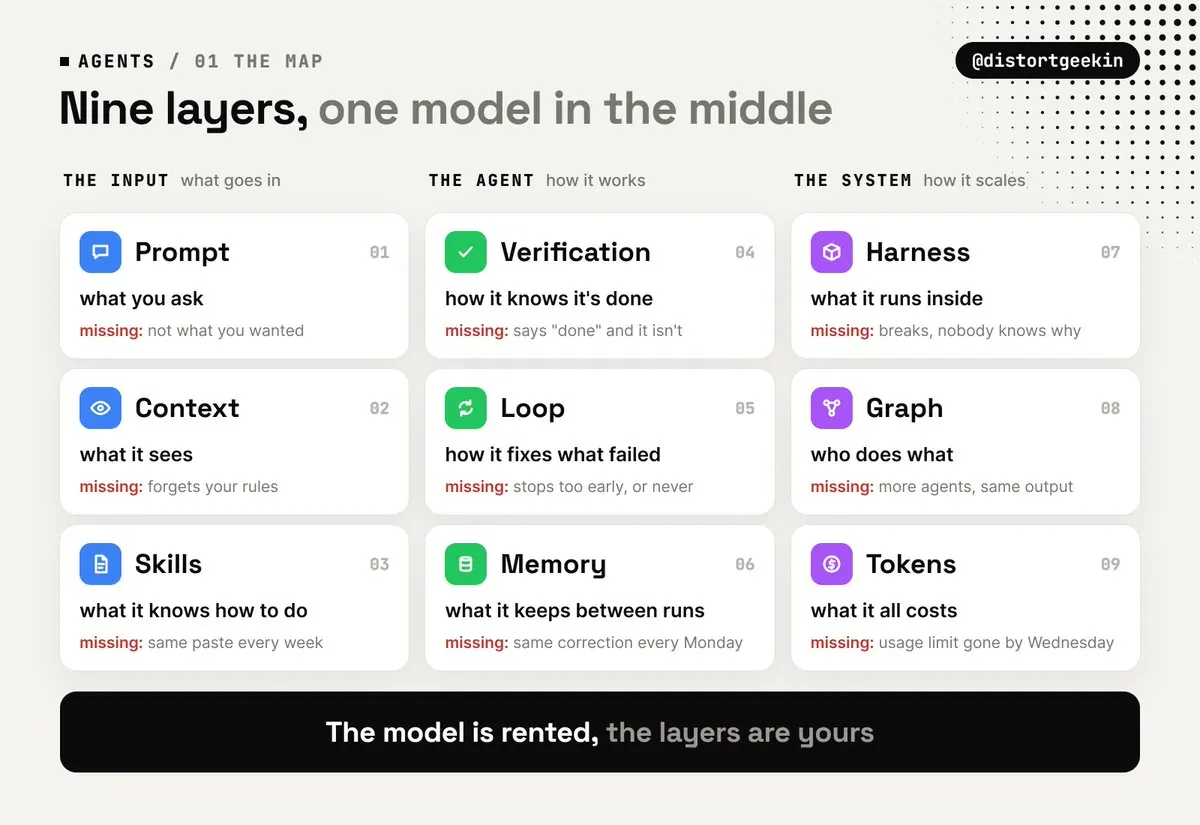
一、三十秒版:九层,三个阶段
| 阶段 | 层 | 回答的问题 |
|---|---|---|
| 输入 | Prompt | 你要它做什么 |
| 输入 | Context | 它看得见什么 |
| 输入 | Skills | 它会做什么 |
| agent | Verification | 它怎么知道活干完了 |
| agent | Loop | 它怎么修没干成的部分 |
| agent | Memory | 两次运行之间它留下什么 |
| 系统 | Harness | 它跑在什么东西里面 |
| 系统 | Graph | 谁负责哪一步 |
| 系统 | Tokens | 这一切花多少钱 |
搭的顺序就照这张表从左往右。一个漂亮的 harness 套在一个烂提示上,结果还是个烂 agent;一群没有检查的 agent,等于同一个错误并行地犯。
二、为什么说模型是最小的一块
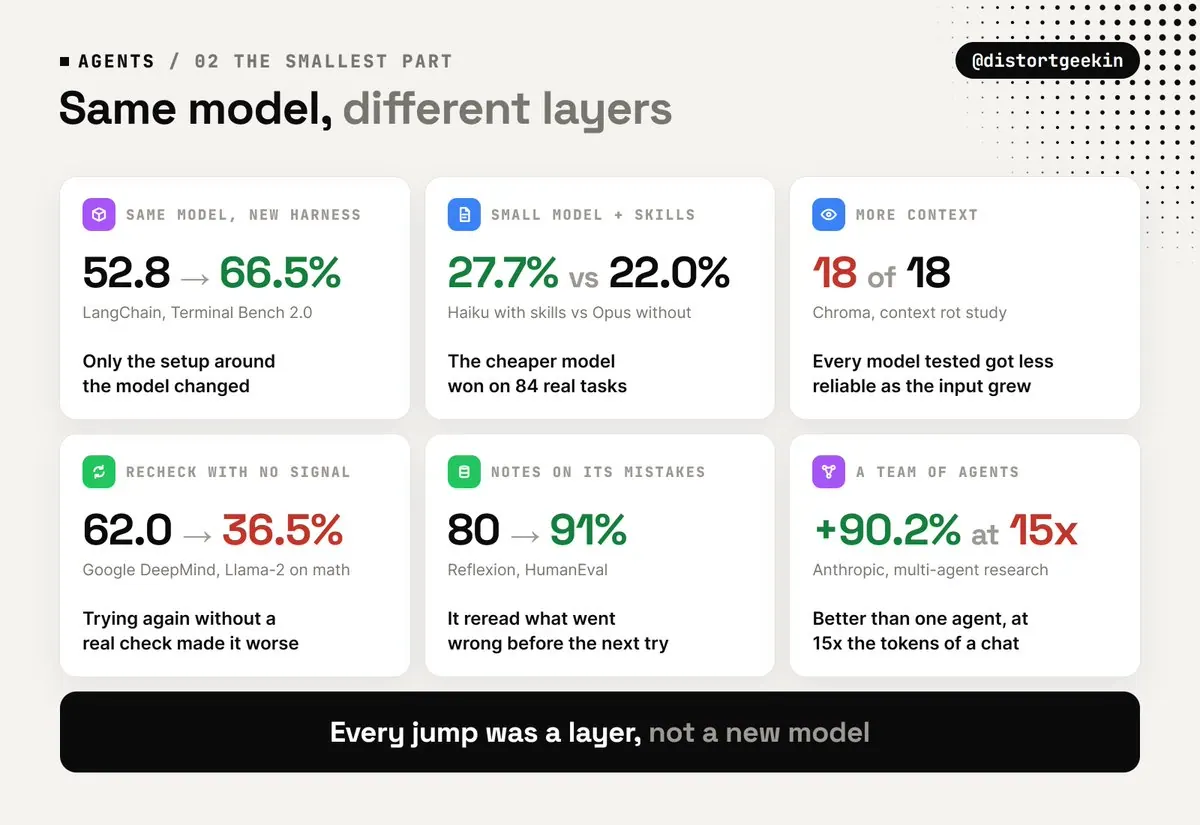
这一系列里每一个能拿出来的跳跃,都来自某一层,而不是来自换模型。
- 同模型,换 harness:LangChain 只改动了固定模型周围的设置——提示、工具、检查——Terminal Bench 2.0 从 52.8% 到 66.5%。
- 小模型,配对技能:SkillsBench 里,Claude Haiku 4.5 带技能得 27.7%,Claude Opus 4.5 不带技能得 22.0%。便宜的那个赢了。
- 上下文更多,答案更差:斯坦福那篇《Lost in the Middle》说明模型会漏掉长输入中间的内容;Chroma 测了 18 个模型,全部随着输入变长而变得不可靠。
- 再试一次不等于检查:Google DeepMind 让模型在没有外部信号的情况下复查自己的答案,Llama-2 在小学算术上从 62.0% 掉到 36.5%。
- 会记教训的记忆:Reflexion 让 agent 把自己出错的原因写成笔记、下一轮重读,HumanEval 上 91%,只用 GPT-4 是 80%。
- 团队花 token:Anthropic 的多 agent 研究系统比单 agent 高 90.2%,代价是大约 15 倍于一次聊天的 token。
规律就是:同一个模型可以是玩具,也可以是同事,取决的是这九层。
三、九层逐条拆
1. Prompt:你要它做什么
提示词是任务、目标和「做成什么样」的定义,写在一段话里。这是所有人已经在做的一层,也是最早不再见效的一层:说清目标、几条硬限制、一个好结果的例子,再往后加字很少换来更好的答案。
- 规则:说清做成什么样,剩下的八层干重活。
- 缺了会怎样:agent 干了一件看起来合理、但不是你要的事。
- 备注:这一层原文没有单独的长文拆解,系列九篇从上下文开始。
2. Context:它看得见什么
窗口里的每个 token 都在争模型的注意力,所以更多通常更糟,而不是更保险。五个动作能解决大部分问题:只留下一步用得上的、规则放开头目标放结尾、让它自己去取文件而不是粘进来、把旧轮次压缩成笔记、重活丢给带独立窗口的子 agent。
- 规则:上下文里每一行都要在这一步挣到自己的位置。
- 缺了会怎样:它忘了你二十条消息前说过的规则。
- 完整拆解:Context Engineering: What Your Agent Sees Decides What It Does
3. Skills:它会做什么
一个技能就是一个文件夹加一个 SKILL.md:一段说明什么时候用它,把步骤写成命令,把必须每次都一样的东西写成脚本。常量加载的只有那段说明,大约 100 token,其余等任务需要时再读,所以一个 agent 可以背着几十个技能。
- 规则:第二次解释同一件事,那就是一个你还没写的技能。
- 缺了会怎样:你每周粘一遍同样的说明,结果每周还都不一样。
- 完整拆解:Skill Engineering: How to Turn Everything You Do Twice Into a File
4. Verification:它怎么知道活干完了
自己给自己打分的 agent,说「做完了」的次数远多于真的做完。验证要做的是把判分挪到 agent 争不过的地方:测试、跑起来的应用、一个数字、一个没看过推理过程的独立检查器。每个漏过去的错误都变成一条新检查,同一个错就不会发两次。
- 规则:做这件事的人不判这件事。
- 缺了会怎样:它产出的每一样东西你都要读一遍,那你省下的时间其实不存在。
- 完整拆解:Verification Engineering: How to Build AI Agents You Never Have to Check
5. Loop:它怎么修没干成的部分
一个循环四件事:做、查、改、停。每轮只改一处,检查项 agent 改不了,用一个文件记录哪些改动留下了、哪些被撤回,开跑前就写好三个出口:完成、卡住、超预算。没有检查的那一步,「再试一次」只是第二次瞎猜——上面 DeepMind 那组数字往下掉,就是这么掉的。
- 规则:一轮一改、一查、一个决定。
- 缺了会怎样:要么停在第一稿,要么跑一整夜把东西改得更糟。
- 完整拆解:Loop Engineering: How to Build Agents That Fix Their Own Mistakes
6. Memory:两次运行之间它留下什么
记忆是把一次纠正变成一条规则,而不是下周再讲一遍的东西。做法是:写教训不写流水账,规则、事实、事件分开放,只加载这次任务用得上的,定期把笔记变成规则,最新的事实优先,每周让人读一次。
- 规则:如果它不会改变 agent 下一次的行为,就不用写。
- 缺了会怎样:每周一你都在改同一个毛病。
- 完整拆解:Memory Engineering: How to Build an Agent That Gets Smarter Every Day
7. Harness:它跑在什么东西里面
harness 是模型运行时所处的一切:一张工作地图、它能用的工具、它踩不得的规则、一个检查器、记忆、一个停止条件。这也是同一个模型在一家公司能上线、在另一家只会说「做完了」然后崩掉的原因。
- 规则:agent 挂了,先修 harness,再怪模型。
- 缺了会怎样:每次运行都从零开始,谁也说不清周二为什么行、周三为什么不行。
- 完整拆解:Harness Engineering: Why the Same Model Works for Them and Breaks for You
8. Graph:谁负责哪一步
加第二个 agent 之前,先把活画出来:步骤是节点,交接是边,每个 agent 领走图的一部分。多数 agent 团队死在图上而不是 agent 上——两个 agent 做同一步、有一步没人认领、每处交接都在等同一个 agent。并行 agent 在能干净切分的工作上划算,比如调研;在每一步都依赖上一步的工作上,多花的钱比赚的多。
- 规则:先画活,再招 agent。
- 缺了会怎样:agent 更多,产出一样,账单更大。
- 完整拆解:Graph Engineering: Draw the Work Before You Build the Agents
9. Tokens:这一切花多少钱
一个 agent 大约烧掉 4 倍于聊天的 token,一个团队约 15 倍,没人设计的话账单涨得比产出快。六个手段能把它压平:按任务量 token、把每次调用里永不变化的部分缓存、简单步骤路由给小模型、裁掉这一步用不到的内容、给每个 agent 设上限、能等的批处理。
- 规则:没有上限的 agent 不叫自主,叫没人看着。
- 缺了会怎样:周三就把额度用完,还说不出是哪个 agent 吃掉的。
- 完整拆解:Token Engineering: How to Run 12 Agents on One Plan
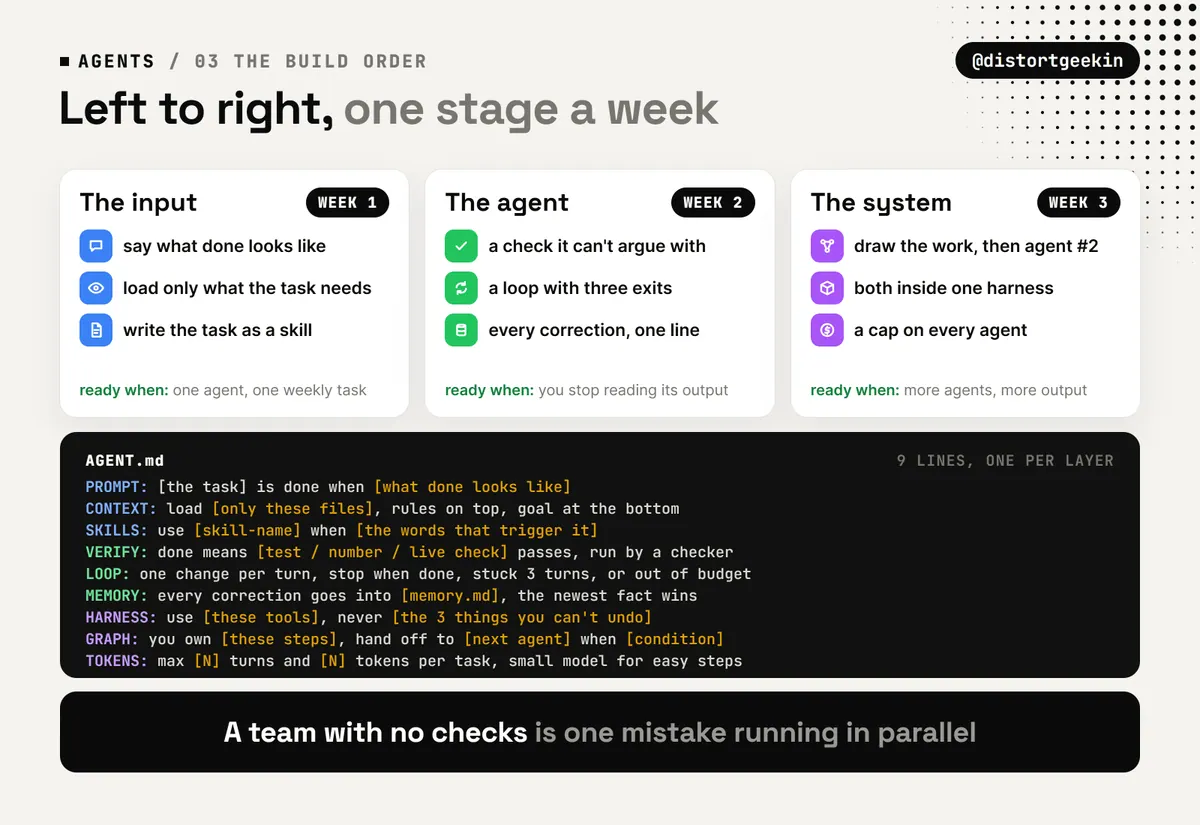
四、搭建顺序:三周,从左往右
多数人是倒着搭的:第一天五个 agent、一个群聊、一块看板,一个检查都没有。照地图从左往右:
- 第一周,输入层:一个 agent、一件你每周都干的任务、一段说清做成什么样的提示、干净的上下文、把任务写成一个技能。
- 第二周,agent 层:加一个它争不过的检查,套进带三个出口的循环,为每次纠正开一个记忆文件。
- 第三周,系统层:到这时才加第二个 agent,先画图,两个都塞进同一个 harness,每个都设上限。
每一段只能长在前一段上:没有检查的循环只是把错误重复一遍,没有图的团队只是并行地重复一遍。
五、一份 AGENT.md 把九层串起来
一个文件,每层一行,方括号是唯一需要改的部分:
PROMPT: [the task] is done when [what done looks like, one line]
CONTEXT: load [only these files] for this task, rules on top, goal at the bottom
SKILLS: use [skill-name] when [the words that trigger it]
VERIFY: done means [test / number / live check] passes, run by [a checker that isn't you]
LOOP: one change per turn, stop when [done], [stuck 3 turns], or [out of budget]
MEMORY: every correction goes into [memory.md] as one line, the newest fact wins
HARNESS: you can use [these tools], you never [the 3 things you can't undo]
GRAPH: you own [these steps], hand off to [next agent] when [condition]
TOKENS: max [N] turns and [N] tokens per task, small model for [easy steps]
九行,每一行封掉一条 agent 以前会崩的路。原文给的模板就是英文,直接照着填比翻译一遍再填更省事;中文版按同样九件事填就行——任务与完成标准、要加载的文件、触发技能的说法、验收方式与验收人、循环的退出条件、记忆写入位置与优先级、可用工具与不可逆动作、负责的步骤与交接条件、轮数与 token 上限。
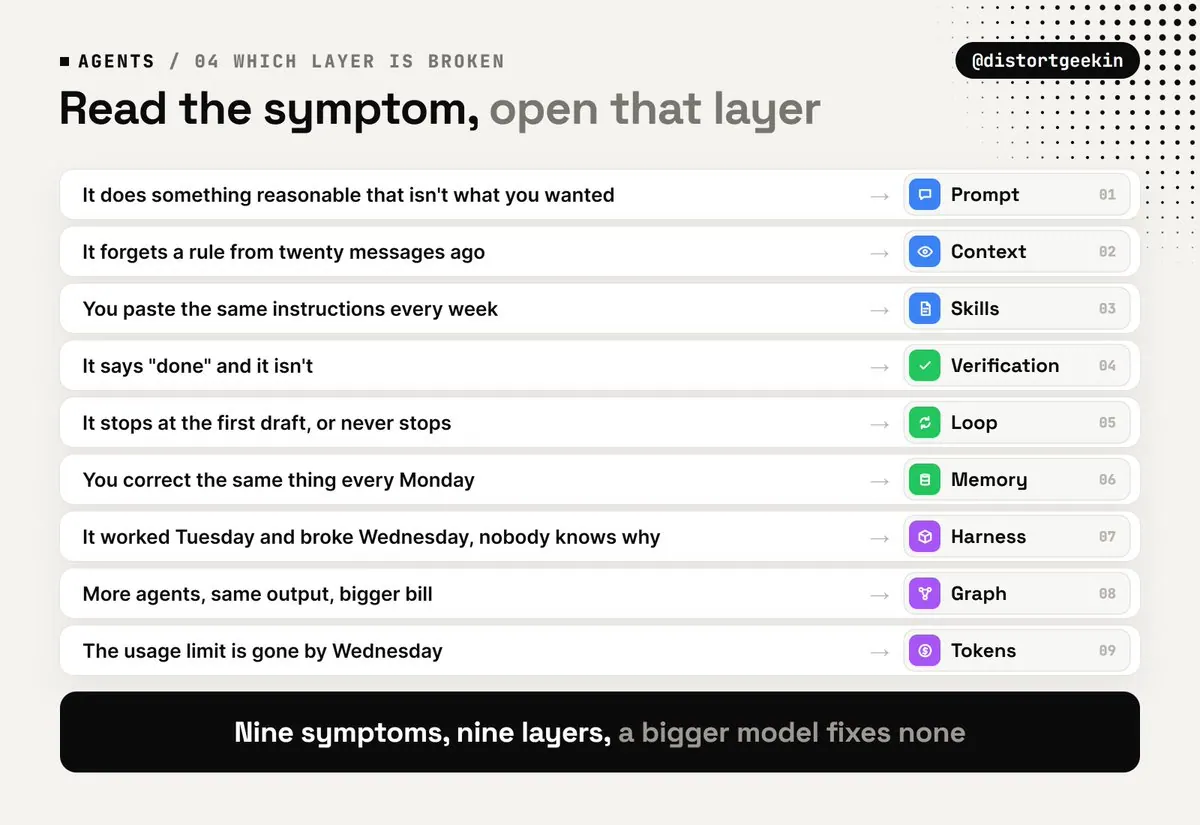
六、哪一层坏了:照症状查
| 你看到的现象 | 先翻哪一层 |
|---|---|
| 干了一件合理但不是你要的事 | Prompt |
| 忘了二十条消息前说的规则 | Context |
| 每周粘一遍同样的说明 | Skills |
| 说「做完了」,其实没有 | Verification |
| 停在第一稿,或者永远不停 | Loop |
| 每周一改同一个毛病 | Memory |
| 周二行、周三不行,没人说得清为什么 | Harness |
| agent 更多,产出一样 | Graph |
| 周三额度就没了 | Tokens |
九个症状,九层,换更大的模型一层都修不了。
七、把九层全废掉的五种做法
- 等下一个模型:这篇里每个数字都来自某一层。新模型会让好的层更好,坏的层还是坏的。
- 从团队开始:团队会放大单 agent 的一切,包括它的错误和它的 token 账单。
- 整套照抄别人的配置:别人的 AGENT.md 编码的是别人的错误,你的那份得来自你真的犯过的错。
- 什么问题都靠加长提示解决:多数失败在第 2 到第 9 层,加长提示只是让第 1 层变重。
- 九层一起上:没人分得清是哪一层起的作用。加一层,量一次,再加下一层。
八、今晚从哪开始
- 挑一件你最常丢给 agent 的活;
- 对着上面的症状表,找出第一个坏掉的层;
- 打开该系列里那一篇,做它「今晚从哪开始」那一节;
- 抄下上面的 AGENT.md,把你已有的那几层填上,其余先空着;
- 下周再填一行。
原文的收尾是:九周之后,你手里会有一个 agent,而别人还在等新模型发给他们。
九、全系列
- Grok Bot: The Ultimate Guide:九层怎么落在真实产品上
- Harness Engineering:它跑在什么里面
- Graph Engineering:谁负责哪一步
- Verification Engineering:它怎么知道干完了
- Loop Engineering:它怎么修没干成的
- Context Engineering:它看得见什么
- Token Engineering:这一切花多少钱
- Memory Engineering:它留下什么
- Skill Engineering:它会做什么
作者还有一条 Telegram 频道(t.me/+g6DzurhKNAkwYjYy),以及每天一篇 AI agent 拆解。