当 AI 开始造 AI:Anthropic 把内部的账本摊开了
Anthropic Institute 发了一篇长报告《When AI builds itself》,作者 Marina Favaro 和 Jack Clark。结论摆在最前面:Anthropic 正把越来越多的 AI 研发工作交给 AI 系统自己做。推到极端,就是一个能完全自主设计、开发自己下一代的系统,报告叫它递归自我改进。报告说还没到那一步,也不是必然,但可能比多数机构准备好了的要早。报告同时点了两头:科学医疗上的巨大好处,以及人类失控的风险。
一、外部证据:能独立完成的任务,每四个月翻一倍
METR 测的是模型能可靠独立完成的任务有多长:这个时长现在约每四个月翻一倍,此前是每七个月翻一倍。2024 年 3 月 Claude Opus 3 约四分钟,一年后 Sonnet 3.7 一小时半,再一年 Opus 4.6 到 12 小时;照这趋势,2027 年可能是几周的任务。
benchmark 同步饱和。SWE-bench 两年从个位数到接近满分,CORE-Bench 从 2024 年约 20% 到十五个月后饱和。METR 说 Mythos Preview 能工作「至少」16 小时,已经是不改任务就测不出的上界。
二、内部证据:合并进主干的代码,八成由 Claude 写
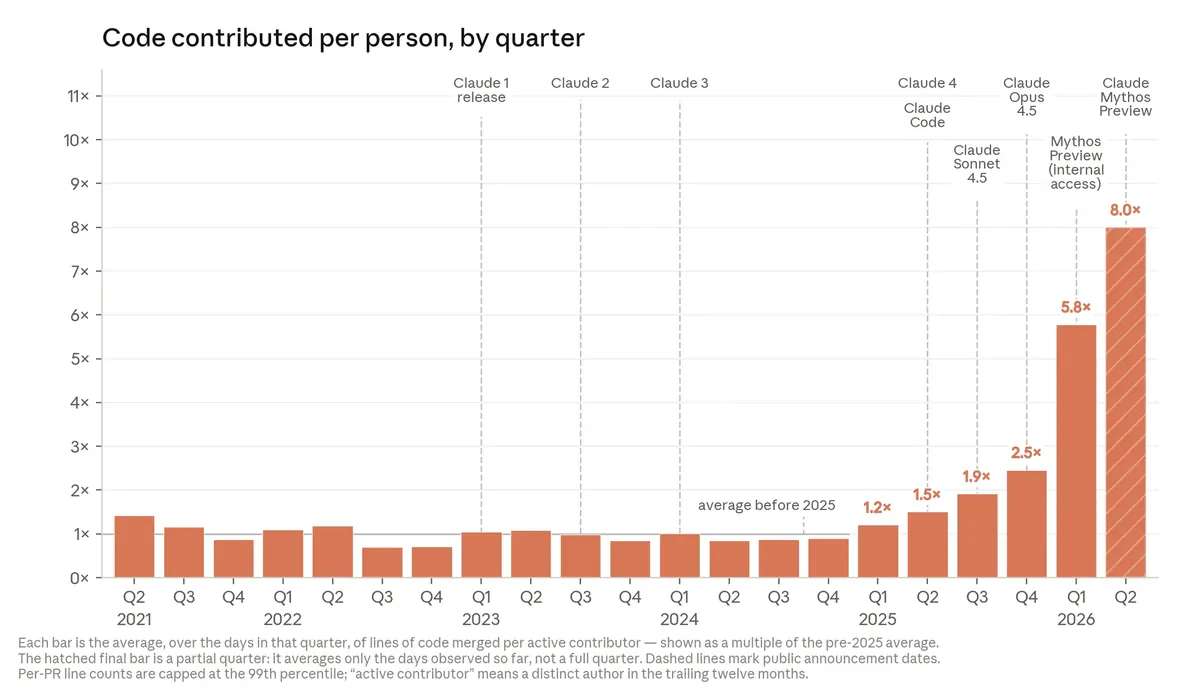
2026 年 5 月,合并进 Anthropic 代码库的代码超过 80% 由 Claude 撰写;Claude Code 在 2025 年 2 月进研究预览之前,这个数是个位数。
人均每天合并的代码量 2021 到 2024 年是条平线,2025 年抬一次,2026 年再陡一次,2026 年第二季度是 2024 年的 8 倍。报告自己说代码行数只量数量不量质量,「8 倍」几乎肯定高估。
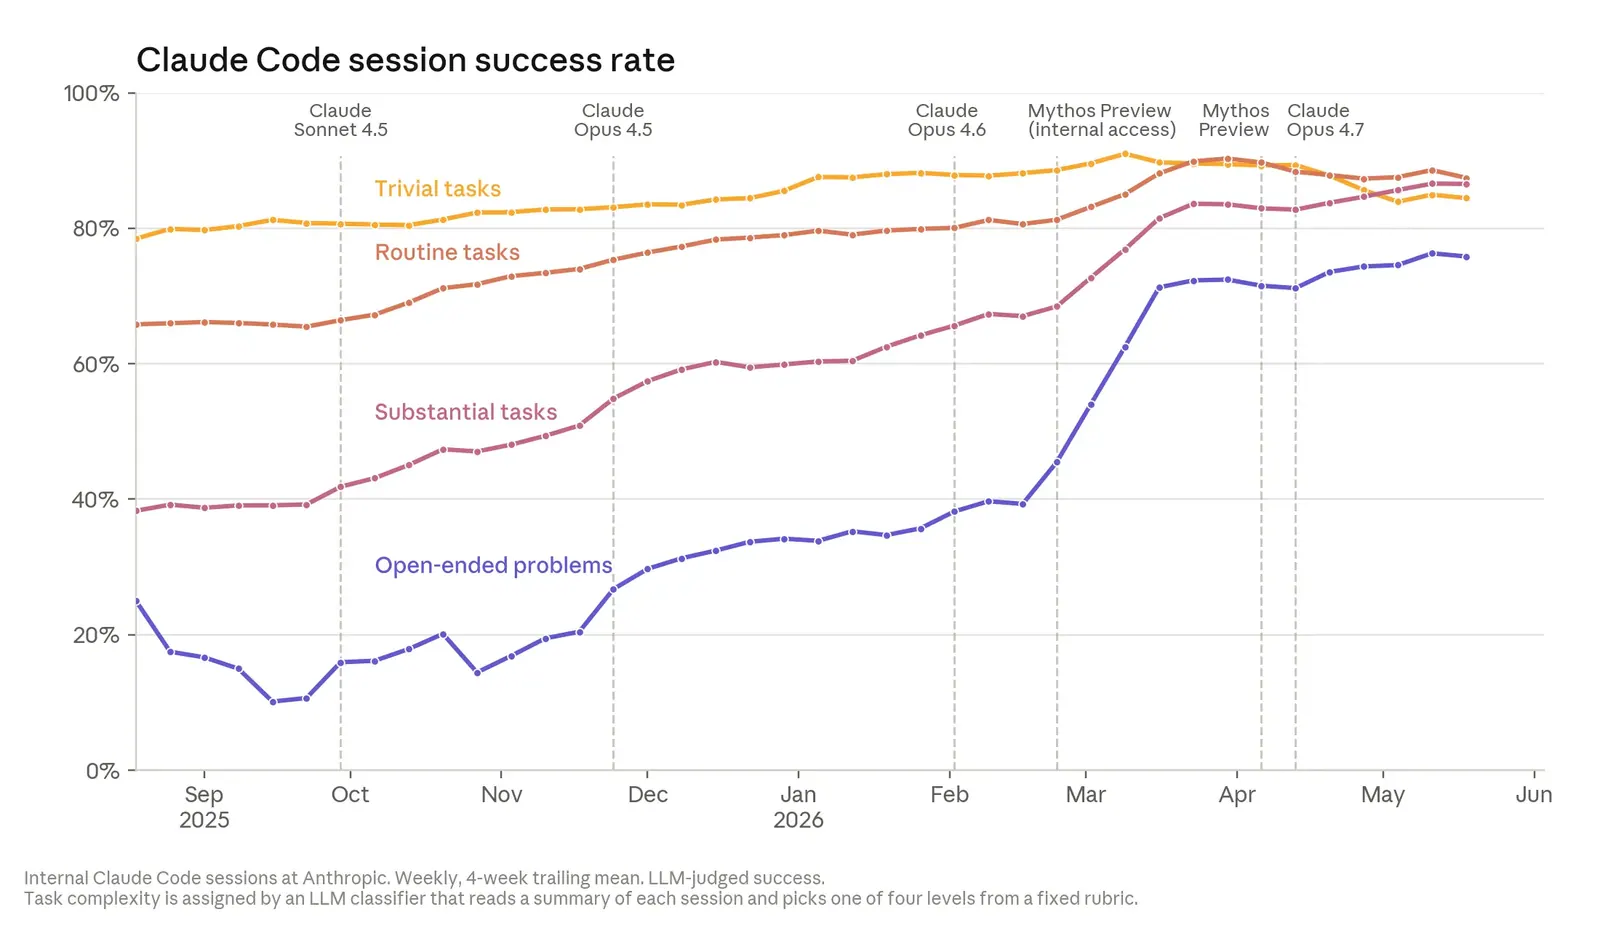
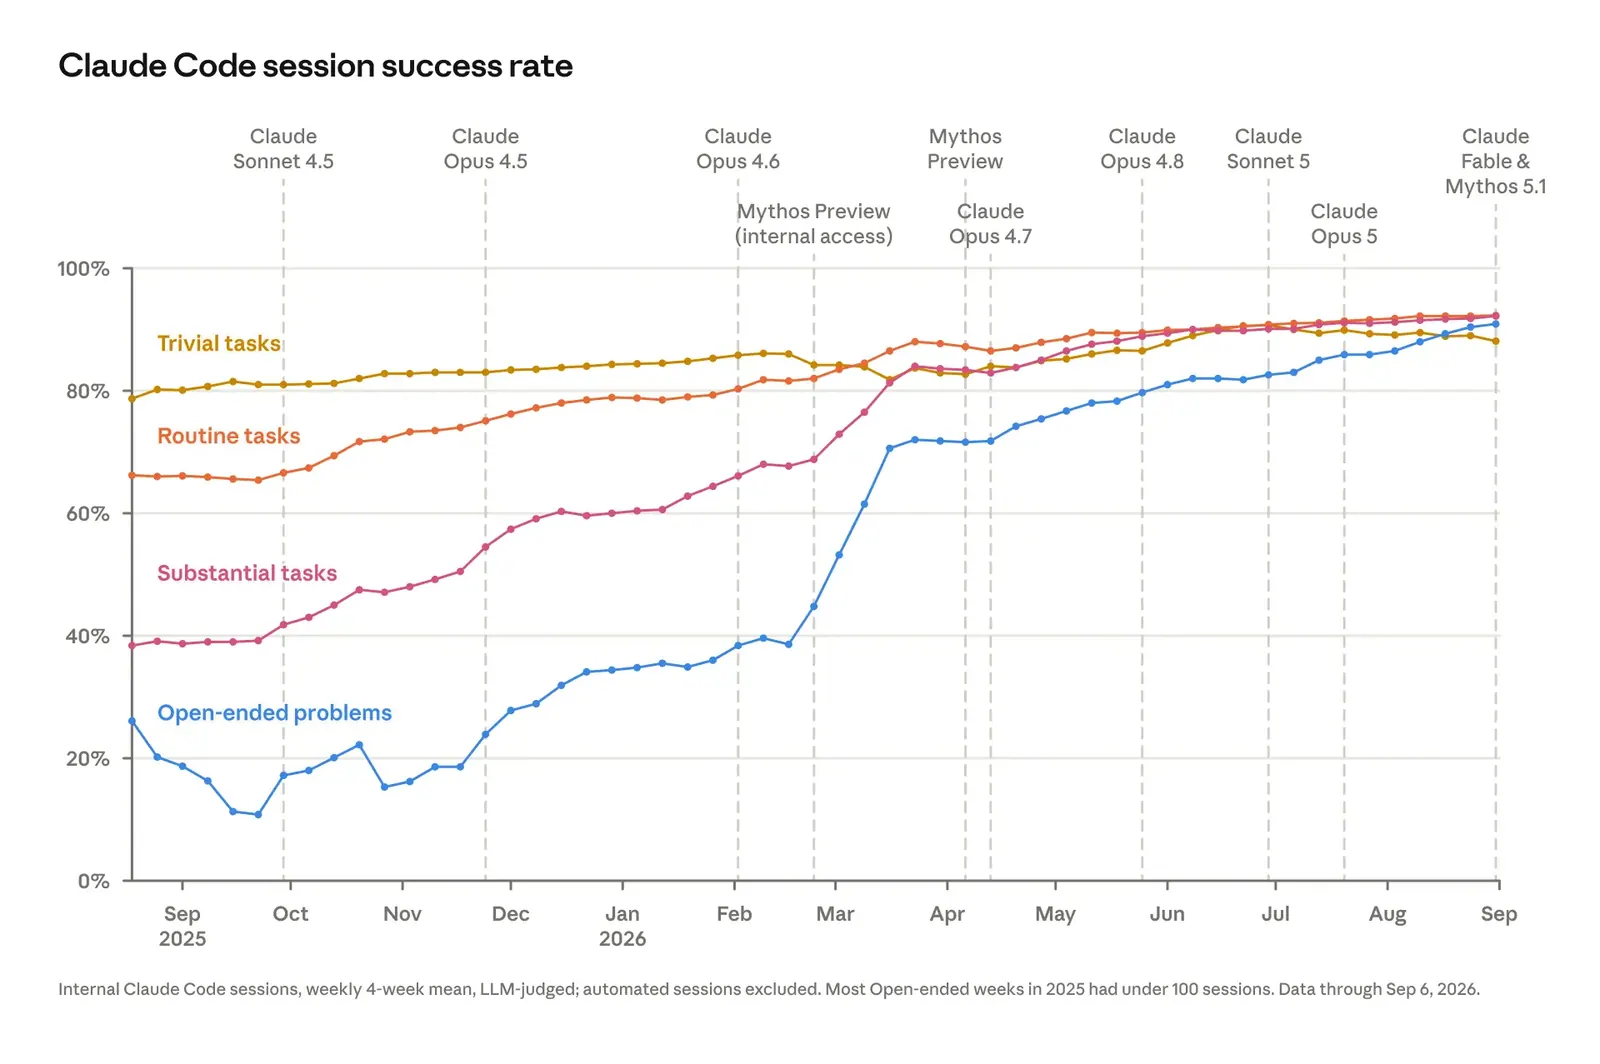
质量上,不少人认为 2025 年底 Claude 写的代码还不如人,现在大致持平;接进合并流程的自动评审,回顾分析能拦下过去 claude.ai 事故里约三分之一的 bug。最开放任务的会话成功率 2026 年 5 月到了 76%,六个月涨 50 个百分点。
三、还差的那一步:定方向,判断下一步
执行实验这一段,Claude 一年内从很好用到了超人水平。每次发模型都重跑同一个测试,给一段训练小模型的代码,让它提速又不破坏正确性。2025 年 5 月 Opus 4 约 3 倍,2026 年 4 月 Mythos Preview 约 52 倍;熟练人类要四到八小时才做到 4 倍。
端到端研究也开了头。2026 年 4 月 公布的演示让 agent 去解「弱模型能否可靠监督强模型」:两名人类花一周补上 23% 的差距,agent 用 800 累计小时、约 1.8 万美元算力补上 97%,但结果没能干净迁移到生产规模模型。
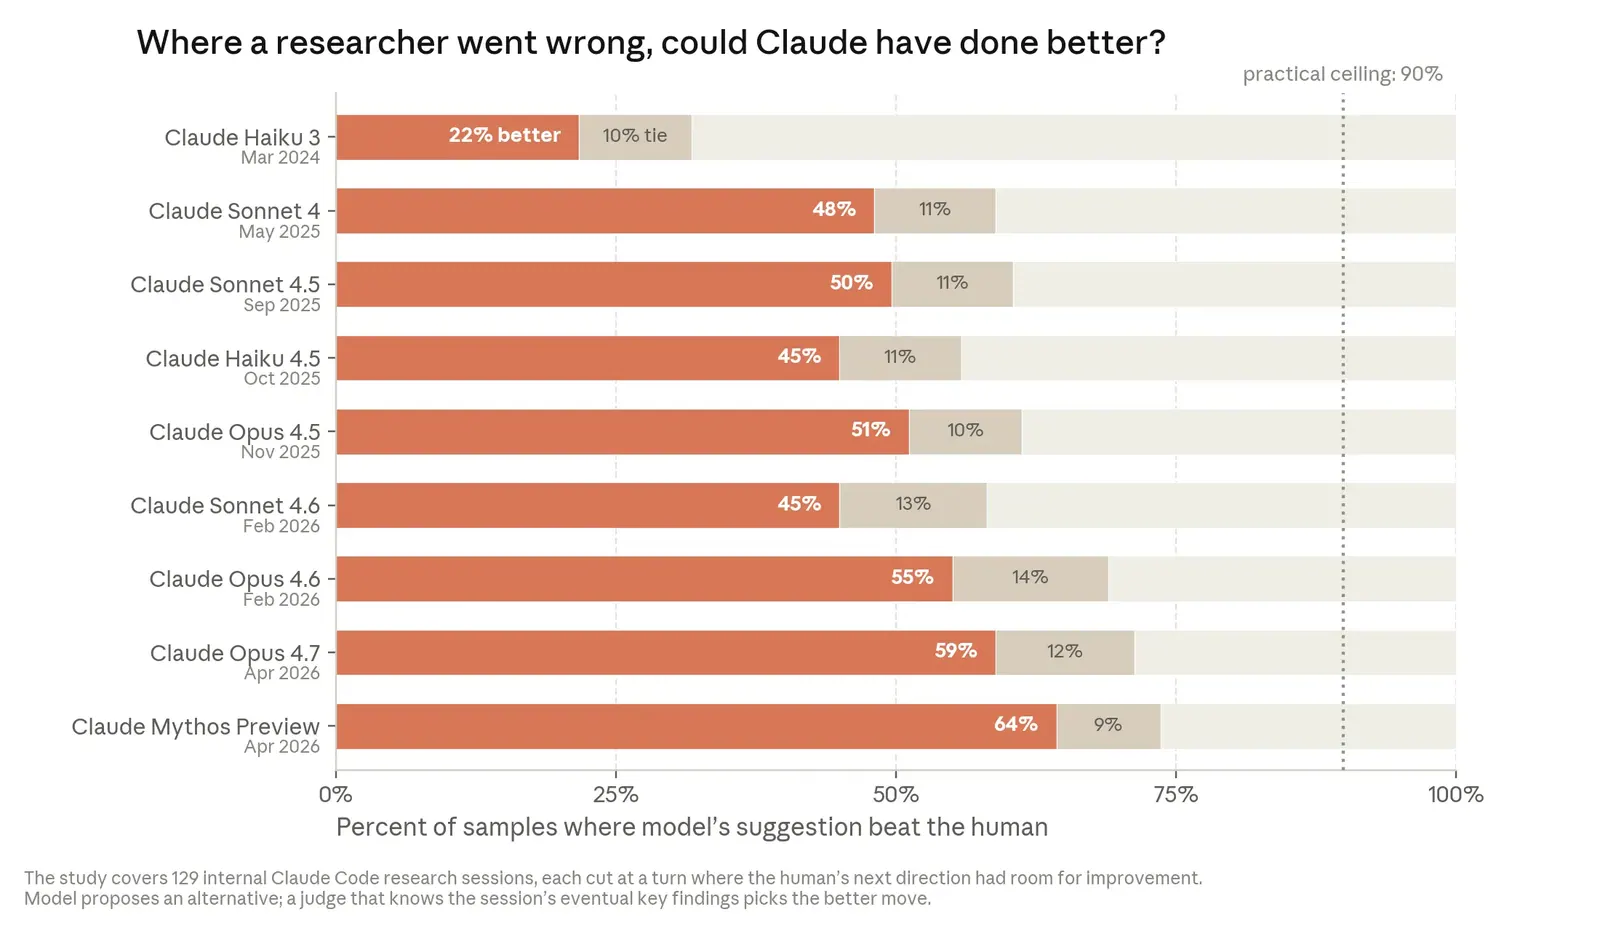
判断力更难。在 129 个研究者走了弯路、后来又回到正轨的时刻,2025 年 11 月的 Opus 4.5 有 51% 给出比人更好的下一步,2026 年 4 月是 64%;另取 127 个人类本来就选得好的时刻,模型只赢约 20%。
四、人退到哪一步
报告的推演是:代码质量和人持平之后,人就不再写、只审;如果审得没 Claude 写得快,人工评审反而成了 AI 研发的瓶颈。今天还留在人手里的,是研究品味——选哪个问题、信哪个结果、判断一条路是不是死胡同。
五、如果这个判断错了
报告的回应是:AI 的进展很少靠灵光一现,多数是放大一点、看哪里坏、修好再试,而这正是 Claude 擅长的活。就算它永远学不会研究品味,只要人只做定方向的那一小部分,每个人也带得动远多于此的工作。
六、三种未来
一是趋势停滞但能力扩散:指数也许是 S 曲线,瓶颈可能在芯片、电网、带宽,或者要等替代 Transformer 的新架构。哪怕冻在今天,Project Glasswing 头几周就找到一万多个高危漏洞,防御瓶颈从找漏洞变成打补丁。报告认为这一种不太可能,理由是它测过的能力都还走在同一条曲线上。
二是实验室继续拿复合效率增益,100 人公司做出 1 万到 10 万人的活。报告认为最可能落在这,也是它担心的:按阿姆达尔定律,一个环节变快,瓶颈就挪到没变快的环节。
三是完全递归自我改进,进度由算力决定,人转向监督与核查。对齐问题怎么解最不确定:模型可能自己找到人没想到的解法,也可能足够谨慎地停手;也可能今天的失准在自造下一代时累积,直到人控制不住。
七、该做什么:留一条能踩刹车的路
报告主张世界保有暂停的选项。可信的暂停要多个国家、多家前沿实验室按同样条件停下,还得能互相核实。难在可探测性:训练运行比导弹发射井好藏,输入通用,偷跑的动机极大,属于军控里更麻烦的一类。那类核查机制花了几十年才建成,报告说我们没那么多时间。一家实验室单独停下立刻能做,但只会换掉领跑者;如果放慢只让最不谨慎的人追上来,所有人都会更不安全。
Anthropic Institute 说未来几个月会组织政策、研究、公民社会和其他公司的对话,列在研究议程里。报告 9 月 18 日更新过一次,补了图表读法。
| 指标 | 数字 |
|---|---|
| 可靠完成的任务时长 | 约四个月翻一倍,此前七个月 |
| Claude 写码占比 | 超过 80%(2026 年 5 月) |
| 人均合并代码量 | 2026Q2 是 2024 年的 8 倍(报告承认高估) |
| 员工自估产出 | 中位数 4 倍(130 人调查) |
| 小模型训练提速 | 3 倍 → 约 52 倍 |
| 端到端研究 | 人补 23%,agent 补 97% |
| 下一步胜过人类 | 51% → 64% |