MCP 与 CLI 之争是个伪命题:把工具定义从上下文搬进代码,15 万 token 压到 2000
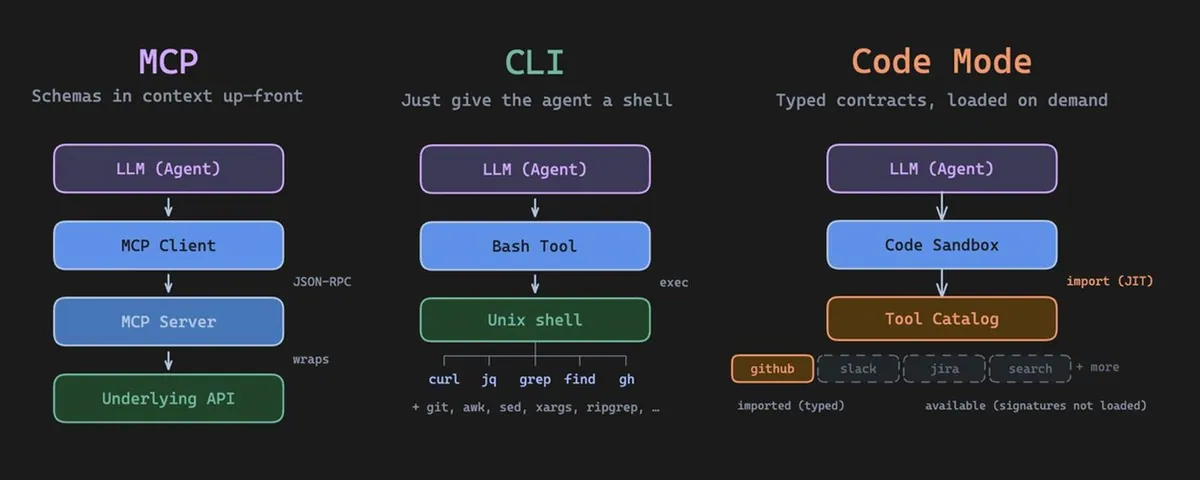
2025 年,AI 工程师们为「agent 该怎么调工具」吵了整整一年。一派说用 MCP,也就是 Anthropic 发布的那套把 agent 接到外部服务的协议;另一派说别用协议,直接给 agent 一个 shell。两边的论据都站得住,也都漏掉了真正的问题。
这是 Akshay Pachaar 在 X 长文《MCP vs CLI was the wrong debate》里的判断(原文 2026 年 5 月 9 日发布)。他认为争的从来不是协议本身,而是「会话一开始就把每个工具的完整描述全塞进上下文」这个习惯。再加上工具返回的数据每一步都要过一遍模型,单个工作流能膨胀到 15 万 token。
本文按原文脉络整理,原文引用的两份一手材料(Anthropic 与 Cloudflare 的工程博客)都已逐条核对。
一、争论双方各自对在哪
质疑 MCP 的一方拿出了实测数据。原文列出的是这几个数:
- Playwright MCP 吃掉 13.7K token - Chrome DevTools MCP 吃掉 18K token - 配到 5 个 MCP 服务,开工前就烧掉 55K token
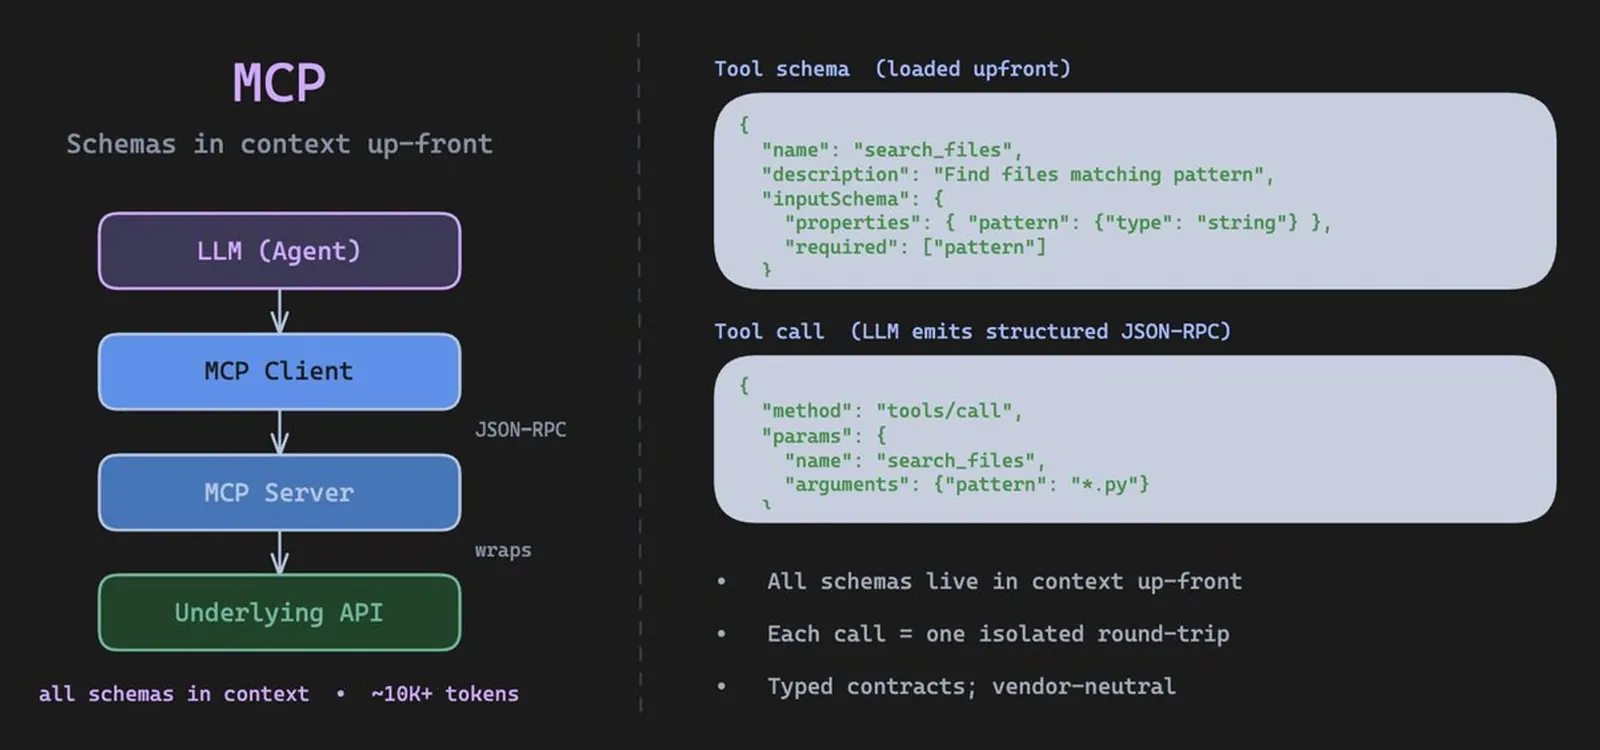
上图是 MCP 的链路:LLM 通过 MCP Client 走 JSON-RPC 找到 MCP Server,再由 Server 包住底层 API。图上的标注是「all schemas in context,约 10K+ tokens」,工具描述在会话开始时就已经占住位置,跟这一轮任务用不用得上无关。
支持 MCP 的一方也不缺理由,原文列的同样具体:
- CLI 在多租户应用上会直接崩 - 没有类型契约,agent 只能靠猜来处理输出 - 碰上不熟悉的 API,agent 会浪费好几轮去解析文本
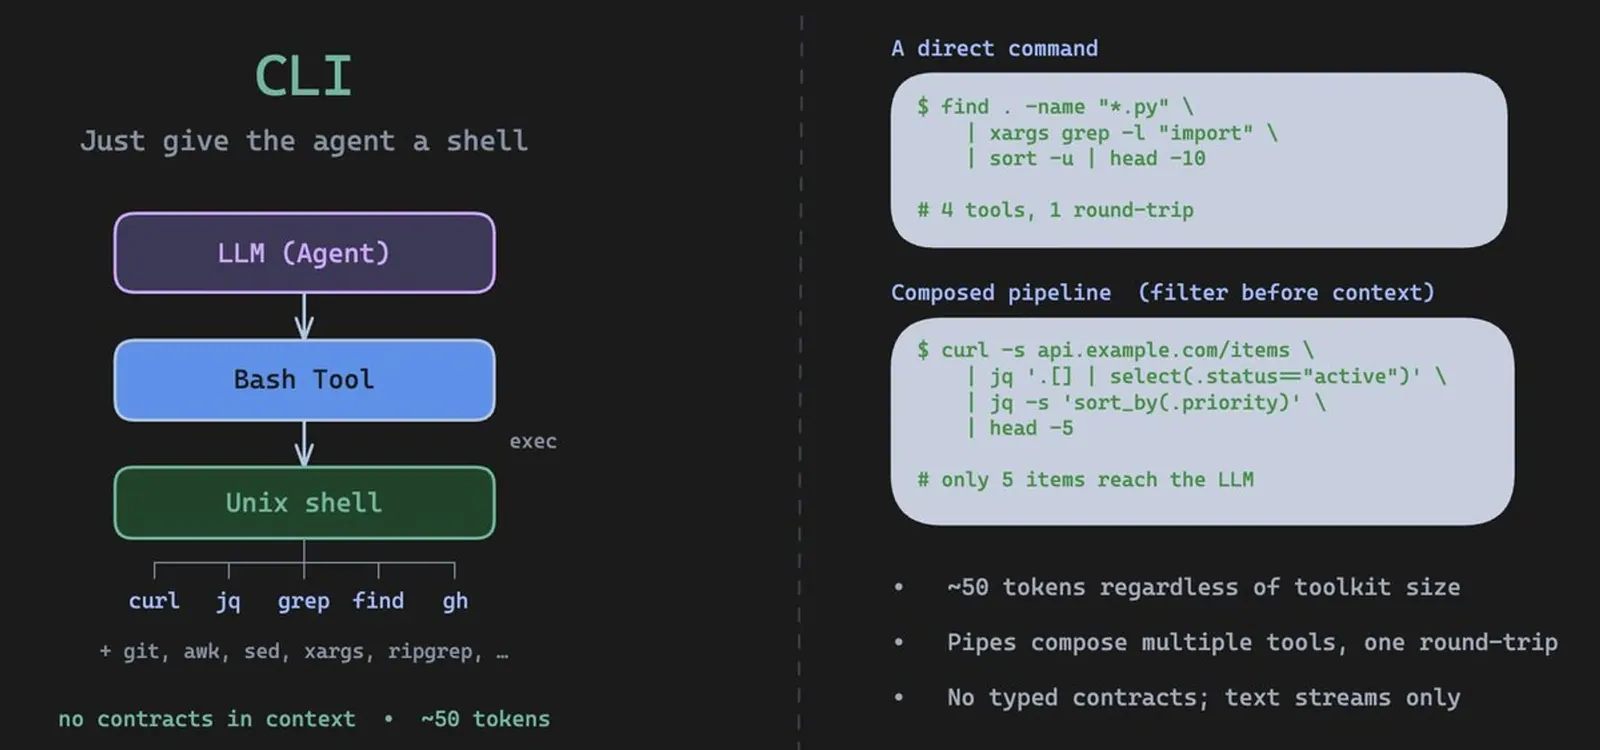
CLI 这一侧几乎不花钱:图上的标注是「no contracts in context,约 50 token」,跟工具集的规模无关。curl 拉数据、jq 过滤、head 截断,几个工具用管道串起来,只有最后那几条结果进模型。代价是全程只有文本流,没有类型契约。
原文在这里插了一句:如果你看到这儿在问「那到底谁赢」,那这个问题本身就问错了。
二、转折点:让模型写代码去调工具
2025 年 11 月 4 日,Anthropic 发布《Code execution with MCP》,把讨论拉回到真正花钱的地方。
问题从来不在协议,而在「会话一开始就加载每个工具的完整描述」这个动作。原文的说法是:把工具描述和工具返回的数据都算上,一个工作流涨到 15 万 token 太容易了。
解法是换掉模型要做的事。模型不再通过自己的上下文去调工具,改成自己写一段代码,由运行时去执行;模型只看见自己 import 进来的东西。
Anthropic 原文里那个例子值得抄一遍:把 Google Drive 里的一份会议转录稿同步到 Salesforce 的 lead 记录。老办法要加载两边的工具 schema,转录稿还得从模型里过两遍;新办法是几行 TypeScript,import 需要的那几个接口。同一个任务,从 150,000 token 降到 2,000 token,省了 98.7%。
Cloudflare 把这个思路推得更远。他们在 2026 年 2 月 20 日的文章里,把整个 Cloudflare API——2500 多个端点——压缩成两个工具:search() 和 execute(),进上下文的部分只占大约 1000 token,而且这个数字不随端点数量变化。他们给出的对比是:不做 Code Mode 的等价 MCP 服务要吃掉 117 万 token,输入 token 减少 99.9%。
下图是原文引用的 Cloudflare 实测数据,用 tiktoken 量的:
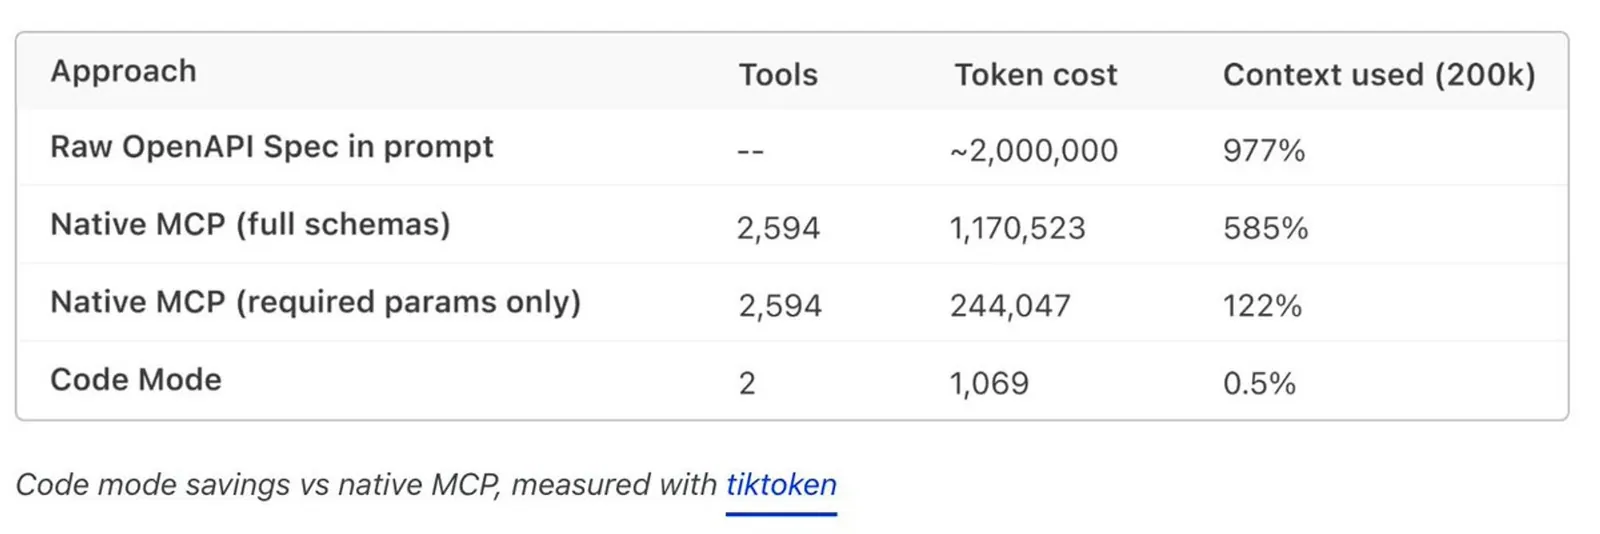
| 方案 | 工具数 | Token 开销 | 占 20 万上下文的比例 |
|---|---|---|---|
| 直接在 prompt 里塞原始 OpenAPI 规范 | — | 约 2,000,000 | 977% |
| 原生 MCP(完整 schema) | 2,594 | 1,170,523 | 585% |
| 原生 MCP(只留必填参数) | 2,594 | 244,047 | 122% |
| Code Mode | 2 | 1,069 | 0.5% |
注意第三行:就算把 schema 瘦身到只留必填参数,244,047 token 仍然超过 20 万上下文窗口的容量。这条路走不通的地方在这儿。
三、Code Mode 到底长什么样
原文把 Code Mode 定义成一个运行时,agent 在里面写代码,代码混用两种原语。
第一种是 bash,用于 $PATH 上已经有二进制的活,比如 git、curl、grep。这些命令模型在训练数据里见过无数遍,知道怎么组合。要找出所有 import 了 pandas 的 Python 文件,agent 写一行就行:
grep -r “import pandas” —include=“*.py” .
不需要额外的工具定义,shell 自己把活干了。
第二种是带类型的模块 import,用于 Salesforce、Stripe 或内部服务这类专有 API。可以把它理解成一个个小 TypeScript 文件,每个文件描述一个工具,输入输出写清楚,agent 按需加载。
关键在于:类型签名跟着 import 走。agent 用到的工具拿到严格契约,没用到的工具一分钱不花。
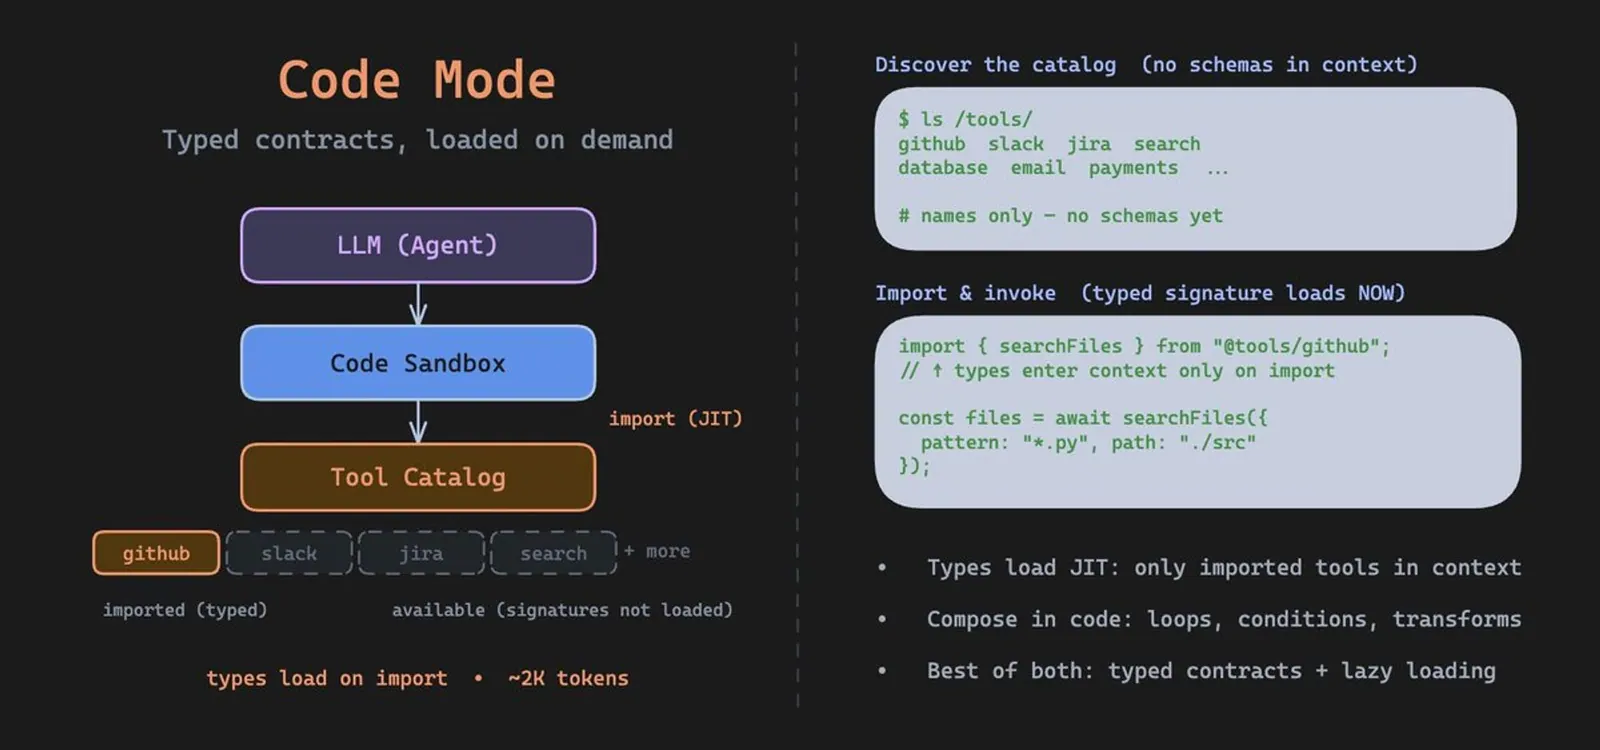
原文给的例子是这样:
// The agent writes this. Types load only on these import lines.
import { searchFiles } from "@tools/github";
import { sendMessage } from "@tools/slack";
const files = await searchFiles({ pattern: "*.py", path: "./src" });
const summary = files.map(f => f.path).join("\n");
await sendMessage({

  channel: "#engineering",

  text: `Found ${files.length} Python files:\n${summary}`,
});
这段代码里有三件以前做不到的事:
1. GitHub 和 Slack 的工具定义只在 import 那两行进入上下文,运行时提供的其他工具全都在外面待着 2. 文件列表在代码里处理完,模型从头到尾没看见那串原始路径,只看见代码生成的摘要 3. agent 用真正的代码写循环和变换,每一步不必再往模型里绕一趟
原文给了一个比喻:老办法是 agent 走进一间屋子,每件工具都摊在桌上;Code Mode 是 agent 走进一间屋子,墙上挂着工具目录,需要哪个再取哪个。
按图上的标注,Code Mode 的上下文开销大约是 2K token。
四、三种方案并排看
把三种做法放在一起看。
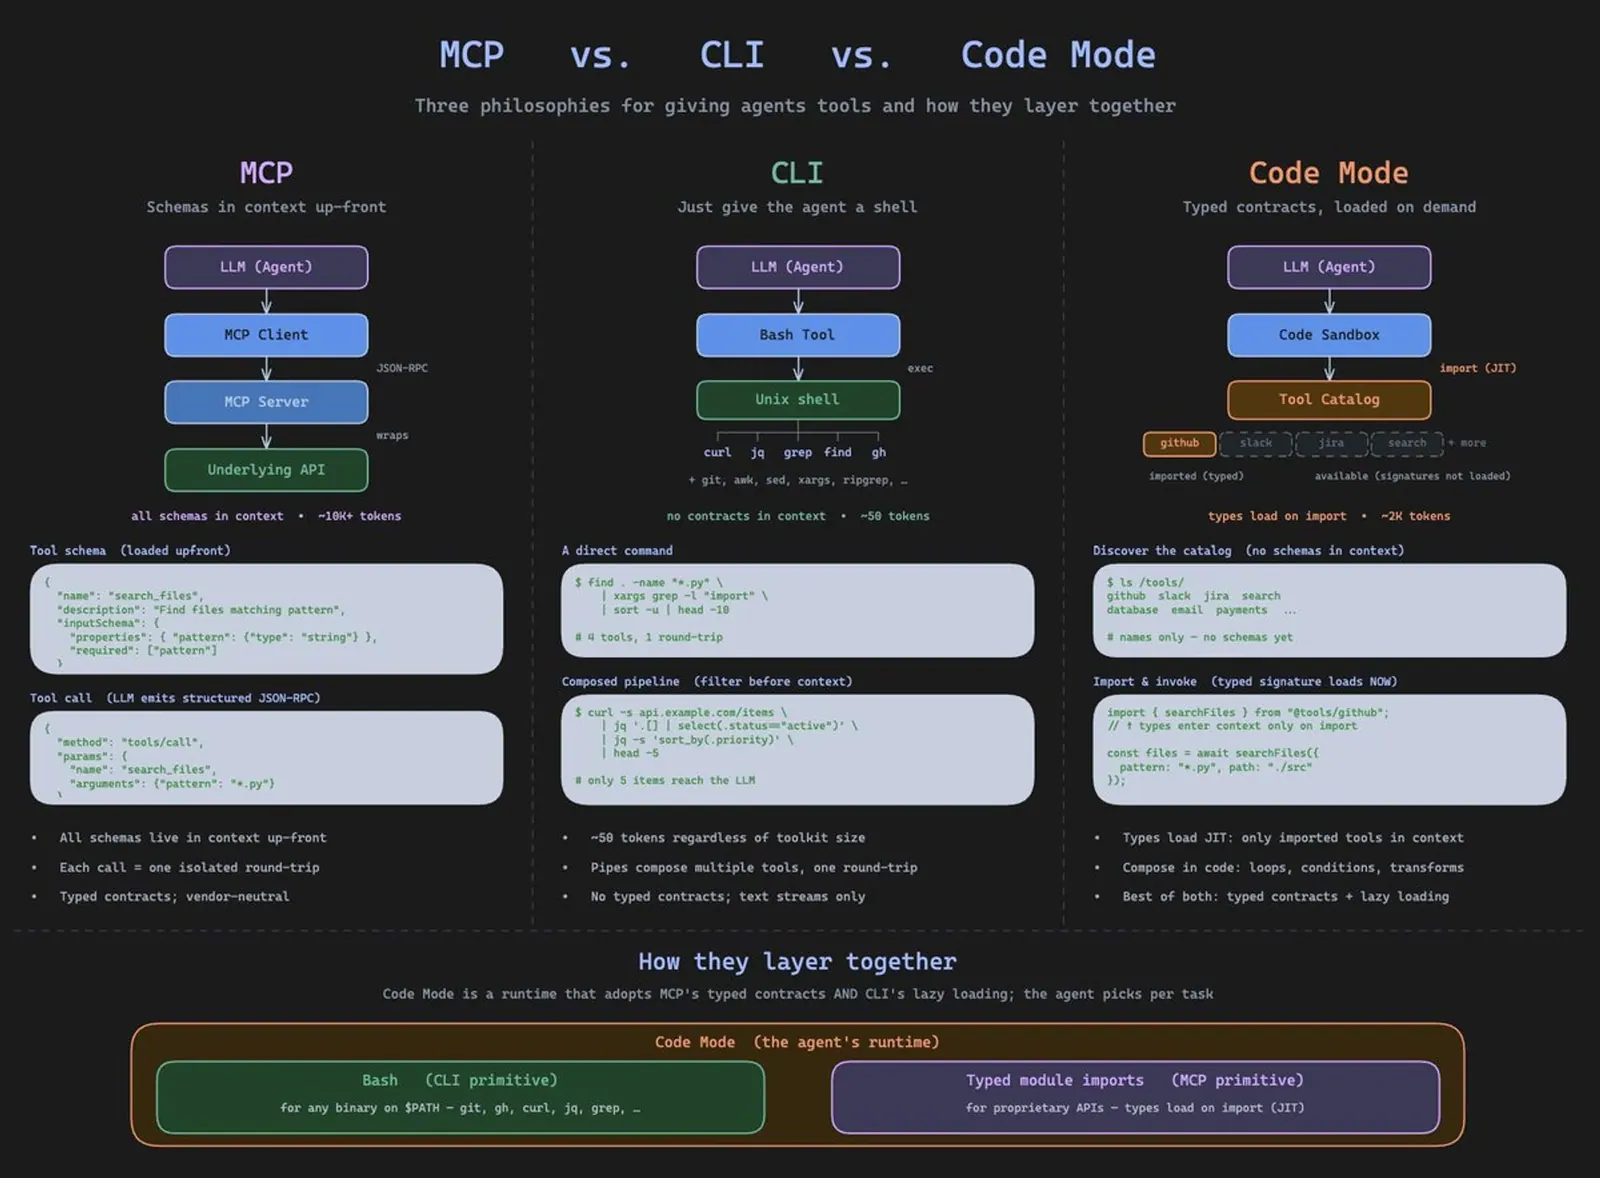
| | MCP | CLI | Code Mode | | --- | --- | --- | --- | | 类型契约 | 有,厂商中立 | 没有,只能传文本 | 有,import 时载入 | | 上下文开销 | 全量 schema 预先加载(配图标注约 10K+ token 起) | 配图标注约 50 token | 配图标注约 2K token | | 加载方式 | 会话开始即全量 | 按需,agent 自己探索 | 按需,import 才载入类型 | | 单次往返 | 一次调用一次独立往返 | 管道里串多个工具,一次往返 | 代码里写循环、条件、变换 | | 主要代价 | 工具描述挤占上下文 | 多租户不安全,无契约,解析文本耗轮次 | 需要一个安全的代码沙箱 | | 适用场景 | 需要稳定契约的多租户服务 | 环境里有 shell、任务涉及的工具有二进制 | 两类混用,按任务挑 |
原文的结论很干脆:Code Mode 不是要替掉谁,它是一个把两者都用起来的运行时。$PATH 上有二进制的用 bash,专有 API 用带类型的模块 import。agent 按任务决定——找文件是 bash 活,更新 Salesforce 是带类型 import 的活,同一个工作流里两种可以混着写。
这也正是「MCP 对 CLI」这个提法错在哪:两种方案都活下来了,只是它们不再充当运行时,变成了运行时去组合的原语。
五、「MCP 已死」是误读
原文专门驳了这个说法。Anthropic 刚公布 MCP SDK 的下载量达到 3 亿次,年初还是 1 亿次。按原文的说法,它是眼下增长最快的 agent 基础设施。
死掉的东西是「把每个工具都预先加载进上下文」。这个做法本来就一直不划算。
原文给 2026 年做 agent 的人留了一句话:工具定义属于代码,不属于上下文。模型写几行代码去调它们,剩下的交给运行时。
六、可以照做的四条
按原文的说法整理成清单:
1. 别再预加载全部工具。 工具描述在会话开头占住的位置,跟这轮任务用不用得上无关。
2. $PATH 上已经有二进制的活,交给 bash。 git、curl、grep 这些模型见得多,组合得出来,不需要额外定义工具。
3. 专有 API 用带类型的模块 import。 类型签名跟着 import 走,用到的有契约,没用的不花 token。
4. 在代码里做过滤和组合,别把中间结果喂回模型。 文件列表、API 响应这类数据,在代码里处理完只返回摘要。
数字来源与口径
- 13.7K / 18K / 55K token:原文引用的社区实测口径,本文未能独立复现。 - 15 万 → 2000 token、降 98.7%:出自 Anthropic《Code execution with MCP》(2025 年 11 月 4 日),已核对原文表述为「reduces the token usage from 150,000 tokens to 2,000 tokens—a time and cost saving of 98.7%」。 - 117 万 token → 约 1000 token、减少 99.9%、2500 多个端点:出自 Cloudflare《Code Mode: give agents an entire API in 1,000 tokens》(2026 年 2 月 20 日,作者 Matt Carey),已核对原文。 - 配图标注的约 10K+ / 约 50 / 约 2K token:出自原文配图上的文字标注,不是独立测评。 - 上表第一行的 200 万 token 与 977%,是 Cloudflare 把原始 OpenAPI 规范直接塞进 prompt 的对照项。
来源与版权
- 原文:《MCP vs CLI was the wrong debate》,作者 Akshay Pachaar(@akshay_pachaar),2026 年 5 月 9 日发布于 X 长文。原文链接:x.com/akshay_pachaar/status/2053166970166772052、长文链接 x.com/i/article/2053097526988058624 - 原文引用的一手材料:Anthropic《Code execution with MCP》(2025-11-04)、Cloudflare《Code Mode: give agents an entire API in 1,000 tokens》(2026-02-20) - 配图:6 张均取自上述 X 长文,版权归原作者。原文未标注授权协议,本文按署名 + 原链接的方式引用,如权利人提出异议将移除。 - 本文:中文整理,非逐字翻译;引用的数字与判断均标注出处,未加入原文没有的结论。