把 Agent 账单砍掉 90%:让 Jev 负责「挑一个答案」,拿不准的交给 Kimi K3
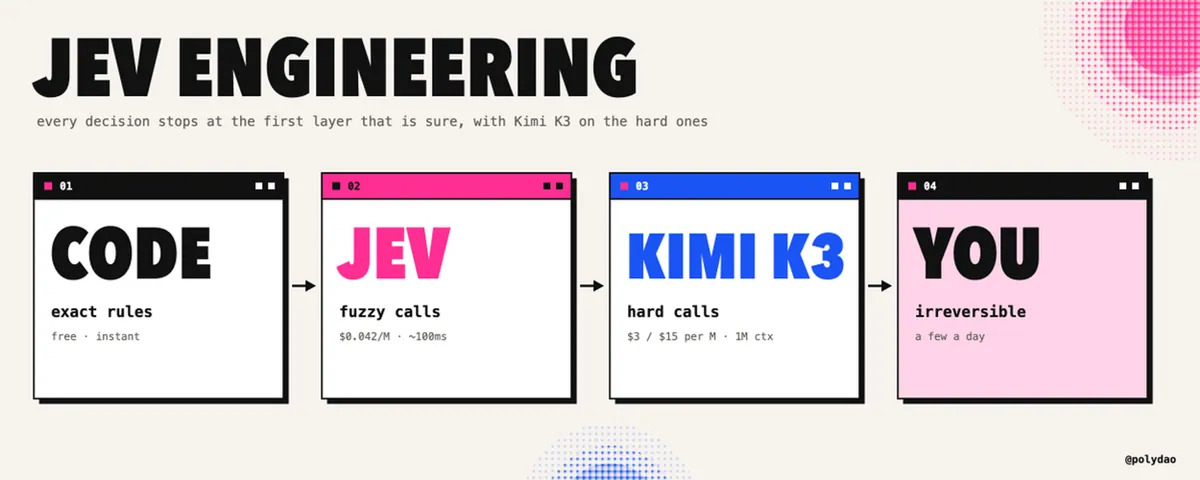
打开任意一段 agent 的运行记录,数一数模型没在创作任何东西的时刻。下一步调哪个工具。这条资料相不相关。测试过没过。这条命令安不安全。任务算不算完成。多数循环里,这类小判断比真正干活还多,而每一次都按前沿模型的整次生成来计费。
2026 年 9 月 15 日,TypeSafe AI 结束隐身,发布了一个只做这类调用的模型。Jev 一个字都不写。
你把状态和带类型的问题交给它,它还你带概率的答案,通常耗时 100 毫秒左右,输入每百万 token 0.042 美元,输出免费。
在 TypeSafe 自己的 workflow 评测里,它比拿来对照的 LLM 快 193.6 倍、便宜 444.6 倍;而公司自己说,这些数字是「能期待的上限」。这两句都写在 TypeSafe 官网首页上,脚注是「基于 System One 任务的 workflow 评测」,旁边给的示例是 TypeSafe AI 单次 0.000081 美元、0.114 秒完成,对照的 LLM 是 0.013880 美元。
所谓 Jev engineering,就是把这件事做对的功夫:找出藏在流程里的判断、把它写成模型答得好的问题、按置信度分流,并且清楚它在哪里会崩。下面是完整打法,Kimi K3 承接 Jev 拿不准的那部分。
一、一个「不会写字」的模型为什么有用
Diogo Almeida 是 InstructGPT 的作者之一,那篇 RLHF 的工作把 GPT-3 变成了 ChatGPT。他为 Jev 写的论证,先批的是自己那套技术:被训练来取悦人类评分者的模型,学会了「看起来对」,它们报出的置信度也就不再有意义。如果一个模型能把某件事做对 95%,却说不出自己做错的是哪 5%,这件事就没法自动化。
Jev 用的是 TypeSafe 称为 RLCD 的训练方式,即面向校准决策的强化学习(reinforcement learning for calibrated decisions)。目标是诚实的概率:报 90% 的答案,在你的数据上应该真的对大约 90%。
单个答案当然还是可能错,这正是置信度这个数字存在的意义。它告诉你的代码,哪些答案可以直接用,哪些该送别处。
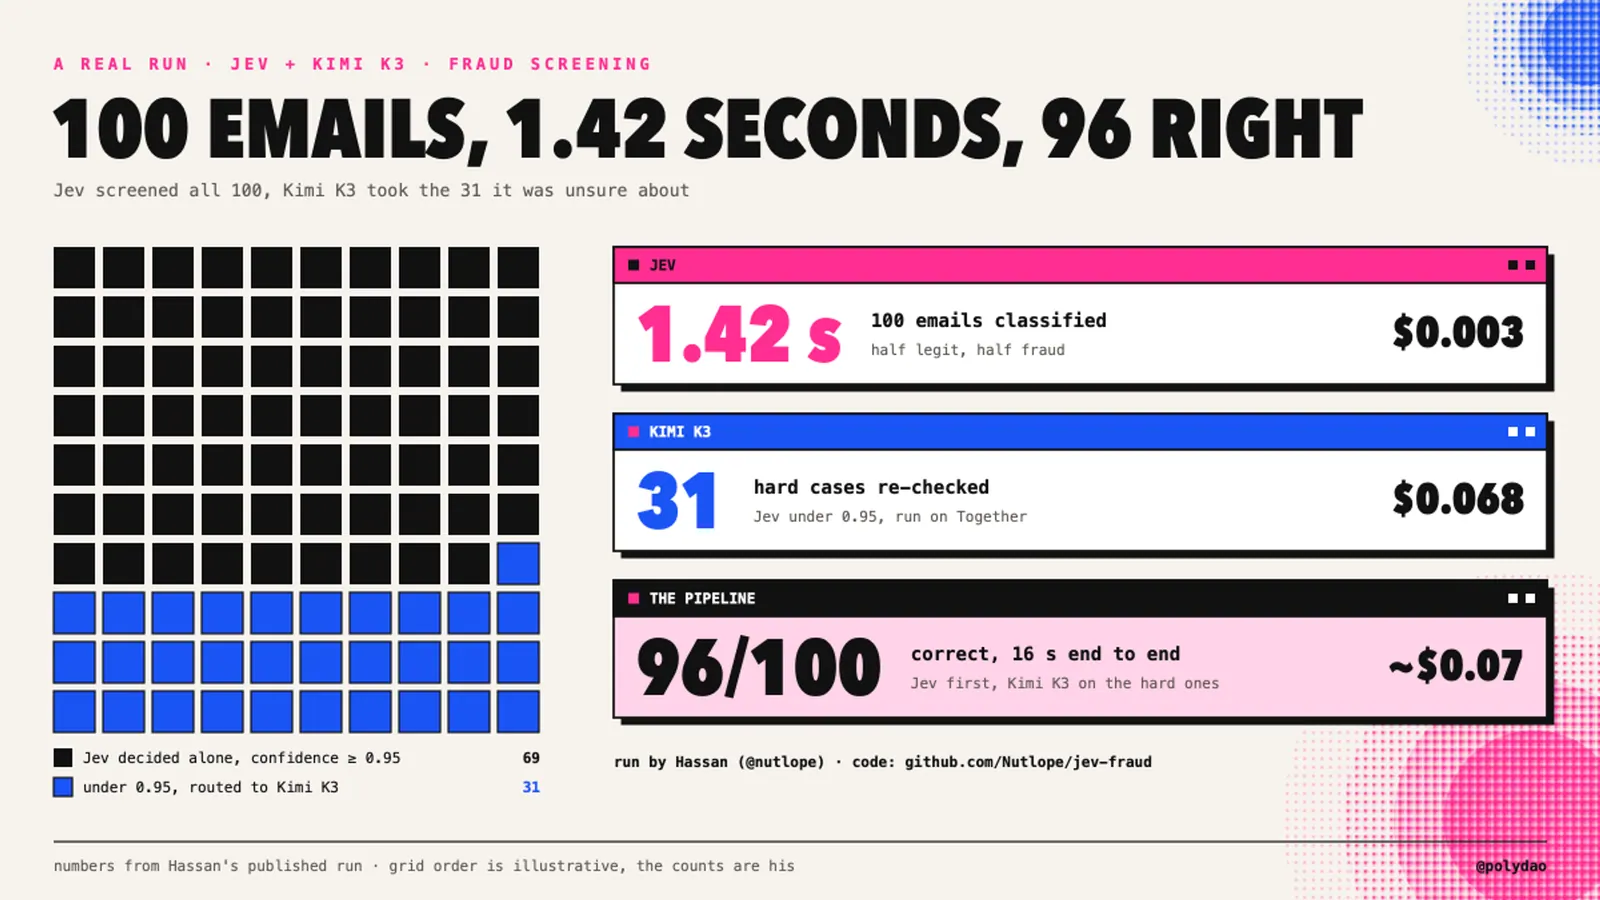
Hassan(@nutlope)筛过 100 封邮件,一半正常、一半欺诈。Jev 用 1.42 秒把 100 封全部分完类。置信度低于 95% 的 31 个答案送去 Kimi K3 做完整阅读。整条流水线 16 秒跑完,100 封里对了 96 封,总花费约 0.07 美元,其中 Jev 那部分花了三分之一美分。他这次运行的代码在 github.com/Nutlope/jev-fraud。
二、第一步:把 agent 的每一步分成四类
拿一段真实的运行记录,把每一步丢进下面四个桶之一。
| 这一步如果…… | 它属于 | 例子 |
|---|---|---|
| 必须创造出文字、代码或计划 | LLM | 初稿、修复、摘要、给人看的理由 |
| 遵循一条精确规则 | 代码 | 重试上限、预算、白名单、日期运算、计数 |
| 从你事先能列出的答案里挑一个 | Jev | 路由、排序、留下还是丢掉、安全与否、完成与否 |
| 做完没法撤销 | 你自己 | 发送、付款、发布、删除、改权限 |
第三个桶永远比人预想的大,而 Jev engineering 挪动的就是这个桶。其余的留在原地。
三、三种问题与 API
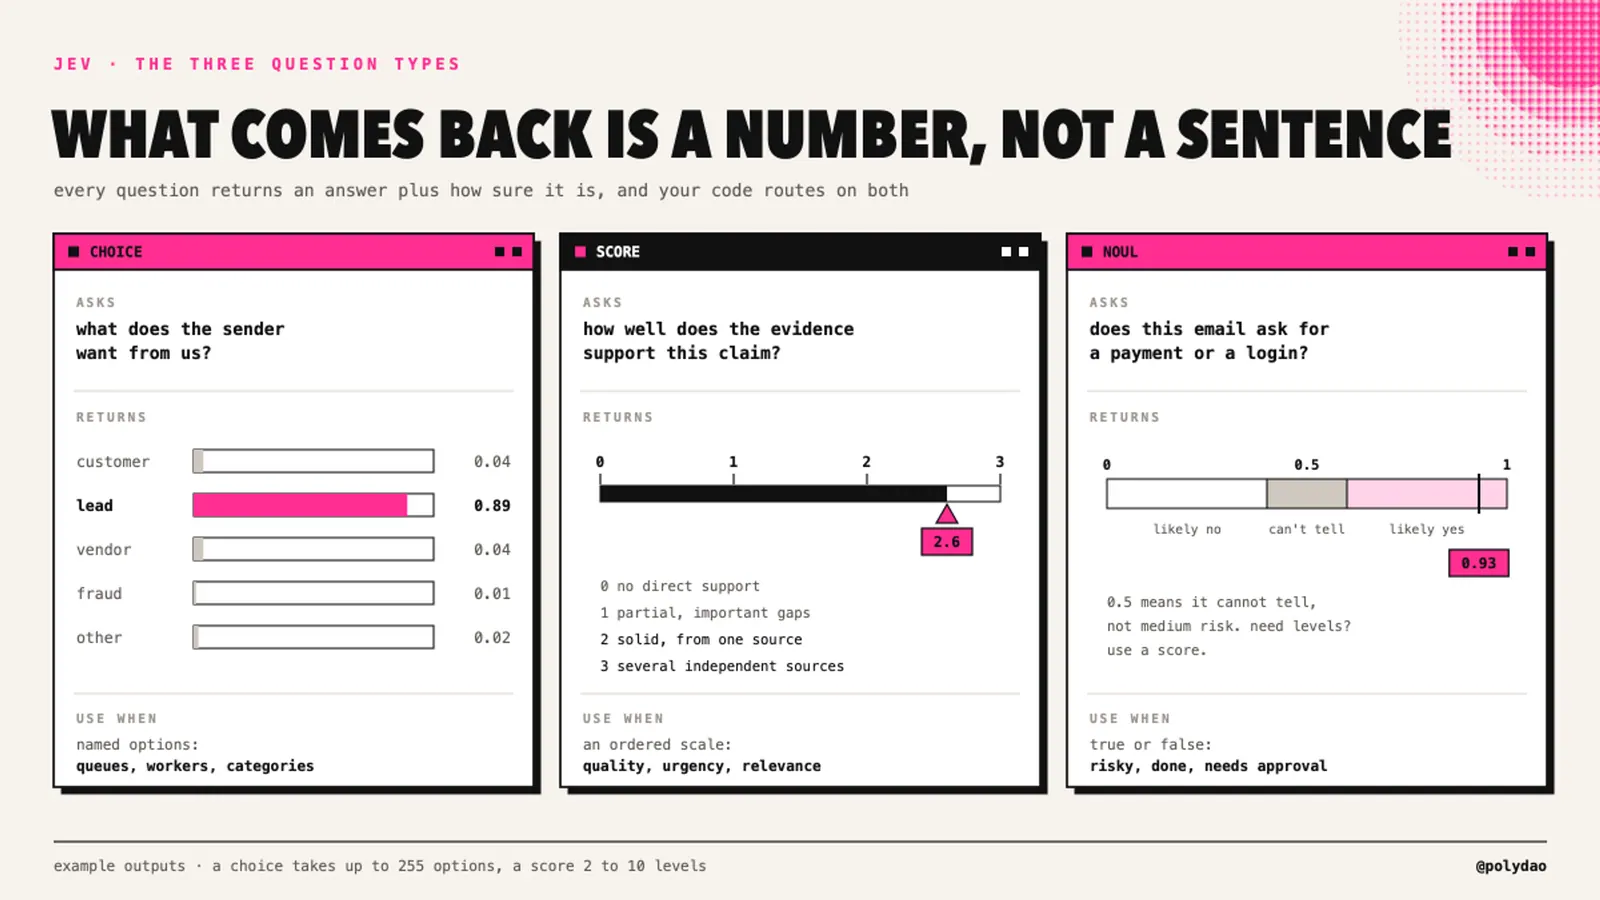
三种问题类型覆盖第三个桶。
| 类型 | 问什么 | 返回什么 | 规则 |
|---|---|---|---|
| Choice | 从你给的选项里挑一个 | 选中项,外加每个选项的概率和置信度 | 最多 255 个选项,概率之和为 1 |
| Score | 放到你的评分标尺上 | 分数,可以落在等级之间,外加分布 | 2 到 10 个有序等级 |
| Noul | 是或否 | noul,即「是」的概率 | 0.5 表示它分不出来,从不返回「中等」 |
搭建时你会用到的事实(这一段已逐条对照 TypeSafe 官方文档 docs.typesafe.ai 核对,差异写在文末):
- 接口:POST [https://api.typesafe.ai/v1/systemone](https://api.typesafe.ai/v1/systemone),请求体带 state、model 和 questions。Python SDK:pip install typesafe-sdk,然后 client.system_one(...)
- 模型:阈值调好之后把版本钉死,用 jev-1.13.0。jev-latest 是会跟着走的别名
- 体积:状态加上所有问题,合计约 64K token;状态加最长的那一个问题,必须在 32K 以内(英文大约 15 万字符)
- 输入:只吃文本。字符串、JSON 对象或数组都行,图片不行
- 速率限制:官方文档当前写的是每秒 100K token 与每秒 80 个请求(原文这里写的是每秒 1,200 个请求、250,000 token,两者对不上,见文末口径说明)
- 速度与价格:端到端 70 到 500 毫秒,输入每百万 token 0.042 美元,输出免费。1 万次判断、每次 1,000 token,合计 0.42 美元
四、一次调用问完所有问题
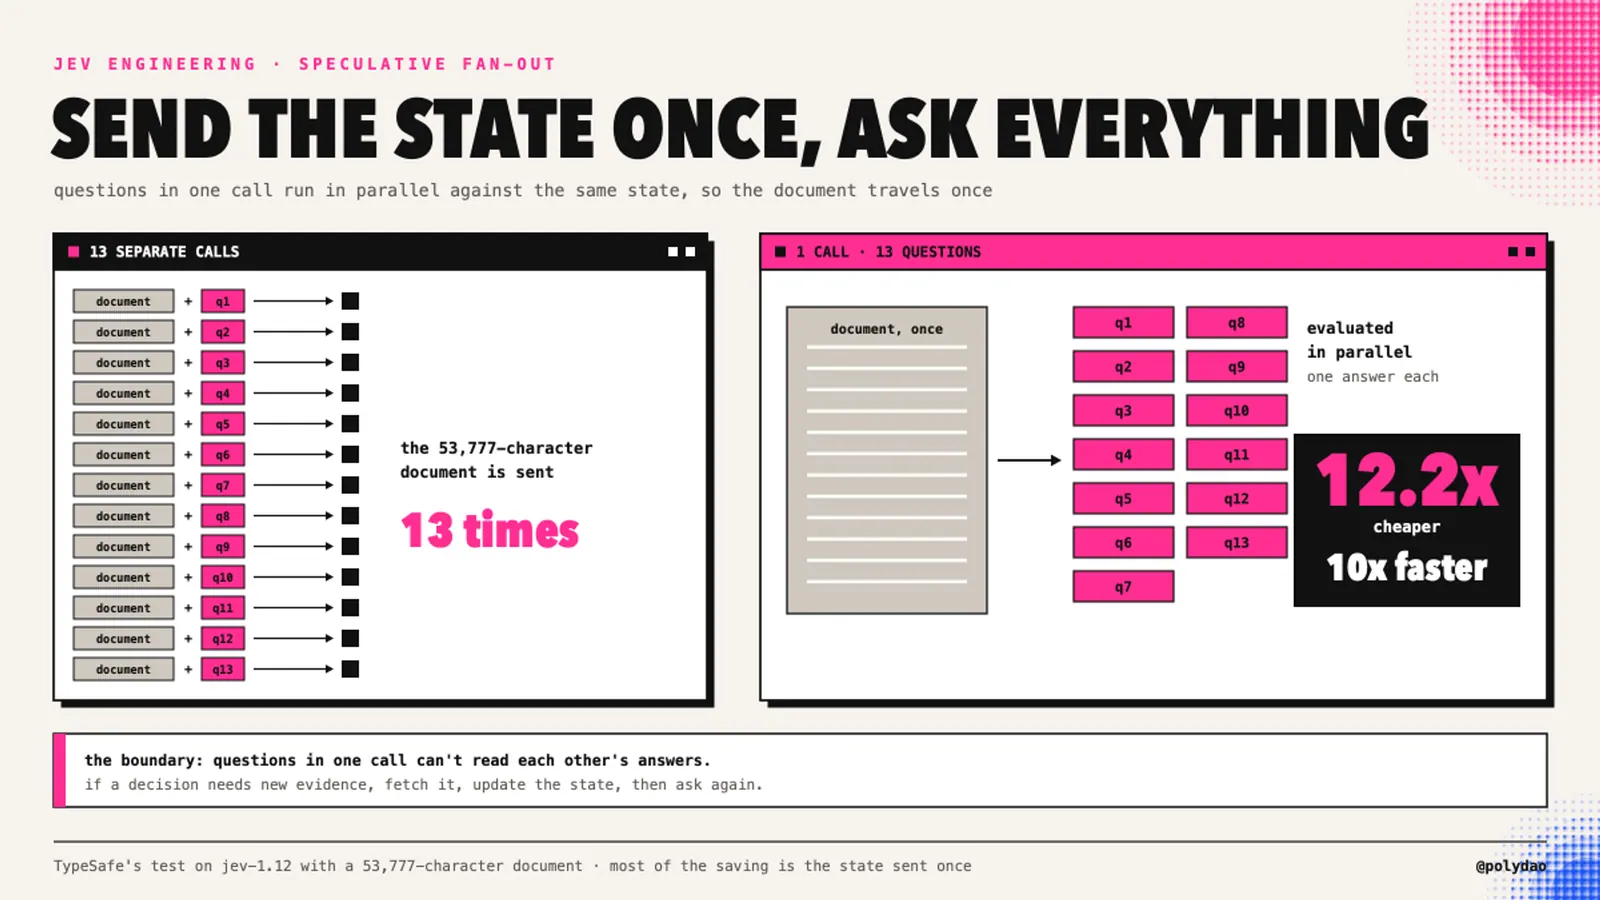
同一个请求里的问题,是对着同一份状态并行求值的。
TypeSafe 把这叫推测式扇出(speculative fan-out),它也是你能控制的最大一笔成本杠杆。在他们的一次测试里,对一份 53,777 字符的文档问 13 个问题,合成一次调用比拆成十三次便宜 12.2 倍、快 10 倍,省下的主要是那份只传了一次的状态。文档站里这篇 cookbook 的说法是:把每个问题都合进一次 TypeSafe 调用,便宜 12.2 倍、快 10.0 倍,答案没有变化。
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
client = TypeSafeClient(model="jev-1.13.0")
r = client.system_one(

    state={"ticket": ticket_text, "customer": {"plan": "pro", "refunds_90d": 0}},

    questions={

        "department": Choice(

            instructions="Which team should own the problem described in `ticket`?",

            criteria={

                "billing": "Charges, invoices, plan changes",

                "bug": "Something in the product does not work as documented",

                "howto": "The customer asks how to do something that already works",

                "other": "None of the above fits",

            }),

        "frustration": Score(

            instructions="How frustrated is the customer, judged from `ticket` only?",

            criteria=[

                "Neutral or positive, no complaint about the experience",

                "Annoyed but polite, describes wasted time",

                "Angry, mentions cancelling, a public review or a chargeback",

            ]),

        "refund_requested": Noul(

            instructions="Does `ticket` ask for money back, a refund or a chargeback?"),

    },
)
dept = r.answers["department"]            # .choice  .probabilities  .confidence
mood = r.answers["frustration"].score     # can land between levels, e.g. 1.3
refund = r.answers["refund_requested"].noul
有两条边界要注意。同一次调用里的问题读不到彼此的答案,所以某个决定如果依赖新证据,得先把证据取回来、更新状态、再问一次。扇出只在问题共享同一份状态时才划算;彼此无关的问题应该分到不同的调用里。
五、真正的手艺是写问题
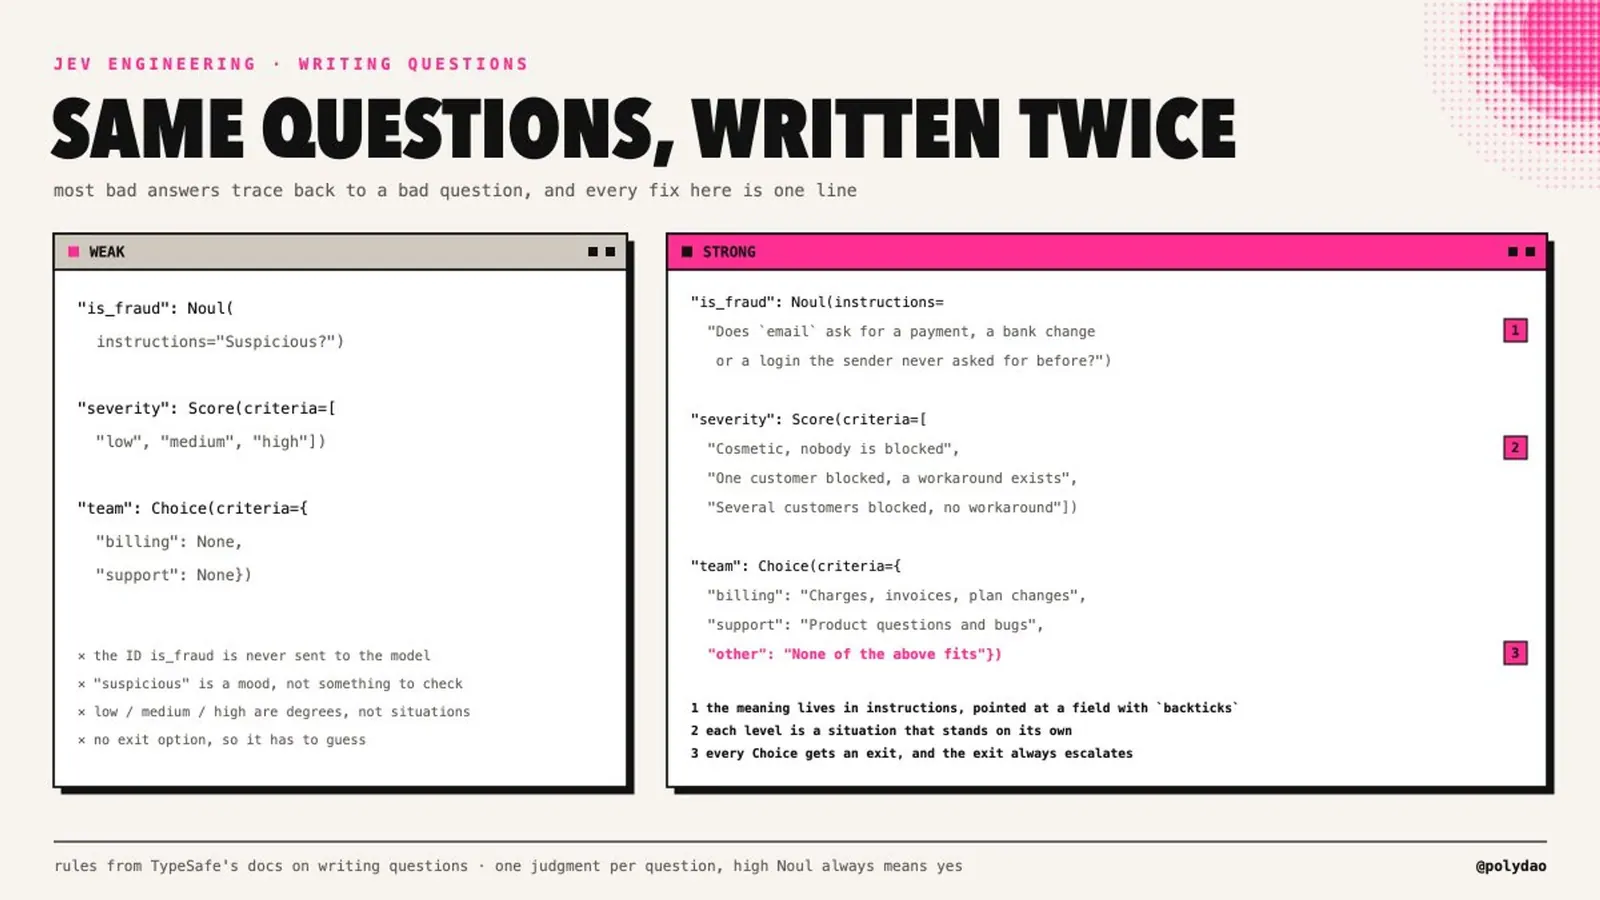
Jev 答得差,多数时候问题出在问题上。下面这些规则来自 TypeSafe 的文档,也来自已经用它上线的人。
- 问题 ID 从不发给模型。 把一个字段命名成 is_fraud,对 Jev 毫无信息量。含义必须活在 instructions 和 criteria 里。
- 一个问题只问一个判断。 「这是不是既紧急又来自付费客户」是两个问题。拆开问,答案在代码里合。
- 描述情形,不要描述程度。 「提到取消或拒付」是可核对的。「非常沮丧」是一种情绪,光秃秃的数字等级也是。
- 每个等级都要能独立成立。 等级是各自独立判断的,「比上一级更糟」对模型没有意义。
- 每个 Noul 都写成「数字高代表是」。 一个「true 表示不安全」的 Noul,就是等着爆的 bug。
- 永远留出口。 每个 Choice 都要有 other 或 none,因为模型必须挑一个,出口给不确定性一个去处。
- 指明具体字段。 像 ` order.charges 这样用反引号标出路径,告诉 Jev 这个问题问的是状态里的哪一块。 - **送证据,并且先在代码里过滤。** 无关状态堆得越多,准确率越低。七个带各自结论的来源,胜过「调研看起来差不多做完了」;把搜索结果裁到相关的那几行,胜过整页丢过去。 - **把「抽取」改造成「选择」。** Jev 产生不了你 schema 里没有的值。要从发票里拽出厂商名,就把已知厂商列表给它,让它挑一个。
六、它在哪里会翻车
TypeSafe 为 jev-1.13 公开了一页「jaggedness」(参差度)。上面每一条,都有一个在调用外层兜住它的办法。
| 弱点 | 会发生什么 | 外层怎么兜 |
|---|---|---|
| 按字面读问题 | 措辞松的问题,得到字面的答案 | 把问题当代码对待:版本化、测试、评审 |
| 不是计算器 | 计数误差随规模增长 | 在代码里数、求和、比较,把结果传进去 |
| 日期是文本 | 「3 月 3 日之后」不是有序比较 | 日期逻辑在代码里算 |
| 上下文腐坏 | 无关状态拉低准确率 | 把状态裁到问题真正需要的部分 |
| 信任状态 | 状态里的对抗性文本能带偏答案 | 确定性检查和权限留在代码里 |
| 文本进、数字出 | 它解释不了自己,也读不了截图 | 需要文字或视觉的活交给 LLM |
| 多跳推理 | 推理链一长就退化 | 把链拆成几次调用,中间更新状态 |
这些的最后一道防线是同一个:类型安全意味着 Jev 返回不了 schema 之外的值,但它仍然可能返回一个「合法但错误」的值。要抓住这类错,靠的是置信度阈值和第二个模型。
七、级联:先 Jev,再 Kimi K3
把上面拼起来,每个判断都会穿过四层,停在其中第一个有把握的地方。
| 层 | 处理什么 | 速度 | 成本 |
|---|---|---|---|
| 代码 | 精确规则 | 即时 | 免费 |
| Jev | 高于你阈值的那些有界调用 | 约 100 毫秒 | 每百万输入 token 0.042 美元 |
| Kimi K3 | 低于阈值的答案,以及任何需要书面理由的活 | 数秒 | 每百万 3 美元输入 / 15 美元输出 |
| 你 | 不可逆操作,以及两个模型都没把握的情况 | 你有空的时候 | 你的时间 |
Kimi K3 放在第二槽位有它的现实理由。升级上来的案例往往需要整条邮件串和历史记录,而 K3 的 100 万 token 上下文在任何长度上都是同一个价。它能读 Jev 读不了的截图和扫描版 PDF。它的权重是开放的,所以同一份代码可以跑在 Moonshot 的 API 上、Together 上(Hassan 的配置)或你自己的机器上。
import json, os
from openai import OpenAI
from typesafe_sdk import Choice, TypeSafeClient
CRITERIA = {

    "customer": "A current customer asking about an order, a bill or their account",

    "lead": "Someone asking about prices, a demo or working together",

    "vendor": "Someone selling a product or service to us",

    "fraud": "Urgent payment request, changed bank details, spoofed sender or a login link",

    "other": "None of the above fits",
}
THRESHOLD = 0.95   # Hassan's setting for fraud, tune it per decision
jev = TypeSafeClient(model="jev-1.13.0")
kimi = OpenAI(api_key=os.environ["KIMI_API_KEY"],

              base_url=os.environ.get("KIMI_BASE_URL", "https://api.moonshot.ai/v1"))
def ask_kimi(email, jev_guess):

    reply = kimi.chat.completions.create(

        model="kimi-k3",

        response_format={"type": "json_object"},

        messages=[{"role": "user", "content":

            f"Classify this email as one of {list(CRITERIA)}. "

            f"A fast classifier guessed '{jev_guess}' with low confidence. "

            'Answer as JSON: {"category": "...", "reason": "...", "sure": true}\n\n' + email}],

    )

    return json.loads(reply.choices[0].message.content)
def route(email):

    r = jev.system_one(

        state={"email": email},

        questions={"category": Choice(

            instructions="What does the sender of `email` want?", criteria=CRITERIA)},

    )

    a = r.answers["category"]

    if a.confidence >= THRESHOLD and a.choice != "other":

        return {"category": a.choice, "by": "jev", "confidence": a.confidence}

    k = ask_kimi(email, a.choice)

    if k.get("sure"):

        return {"category": k["category"], "by": "kimi-k3", "reason": k["reason"]}

    return {"category": "review", "by": "you", "jev": a.choice, "kimi": k["category"]}
other 永远不会自己往下走。K3 会拿到 Jev 的猜测作为上下文。两个都没把握的时候,你拿到的是并排摆着的两份答案,这就是最快的复核方式。
八、接进你已有的框架
不需要换新框架。Jev 已经装进三种最常用的框架里。
LangChain(langchain-typesafe)给两个中间件。ModelRouterMiddleware 让 Jev 按你写的标准,挑出能处理这个请求的最便宜的模型。AutoModeMiddleware 则在每次工具调用执行前检查风险——这类危险操作分类器,此前一直是编码类 agent 藏着不开源的东西:
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware
agent = create_agent(YOUR_MODEL, middleware=[AutoModeMiddleware(tools=["bash"])])
Pydantic AI(pydantic-ai-slim[typesafe])直接把你的输出类型翻译成问题:Agent(“typesafe:jev-latest”, output_type=Triage)。bool 变成是非题,Literal 变成 Choice,带 docstring 的 IntEnum 成员变成 Score,X | None 会多出一个「以上都不是」的选项。它的 FallbackModel 套路把没把握的答案交给 LLM——也就是上面那套级联,两行搞定。
Vercel AI SDK 通过 experimental_evaluate 暴露 Jev,provider 是 @ai-sdk/typesafe-ai;也能走 AI Gateway 的 typesafe-ai/jev,价格一样。
九、已经有人在跑什么
| 项目 | Jev 判断什么 | 结果 |
|---|---|---|
| Browser Use jev-ultrafast | 下一步动作,以及该点页面上哪个元素(每一步都重建选项清单) | 苏黎世到伦敦的航班 7.1 秒找到,花 0.0039 美元 |
| 欺诈筛查(Hassan) | 正常还是欺诈,没把握的 31 封送 Kimi K3 | 100 封对 96 封,16 秒,约 0.07 美元 |
| 1kpapers.com | 每篇论文属于 24 个主题中的哪一个 | 1,018 篇论文花 0.08 美元,中位 256 毫秒;用 LLM 做摘要则是 3.99 美元 |
| 收件箱分类(Riley Brown) | 每封邮件要做什么 | 500 封邮件 3.5 美分 |
| 电脑操作(awlevin) | 一项桌面任务的每一步 | 每个决策 0.0002 美元,对照 Opus 5 的 0.032 美元;0.13 到 0.38 秒,对照 5.2 秒 |
| 即时压缩(tamara) | 一轮会话里哪些工具调用还有用 | 一个 Claude 会话从接近 100 万 token 压到 86K,约一秒(Alex Volkov 的测试) |
| jev-trader(Jarrod Watts) | 每个区块做一个交易决策 | 模型延迟约 81 毫秒 |
规律是重复的:选项清单每一步都从实时状态重建,Jev 挑,剩下的交给代码或小模型。
十、用 Jev 指挥 Kimi K3 的 swarm
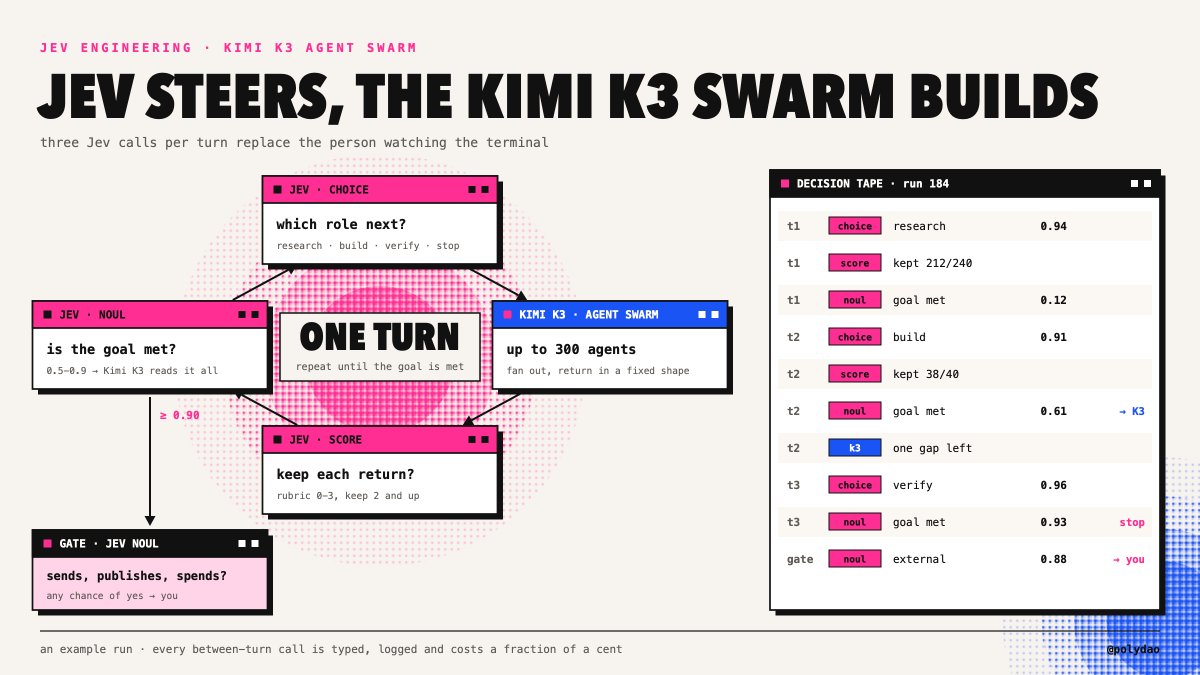
同一套思路可以放大。活大的时候,Kimi K3 的 Agent Swarm 负责施工,最多 300 个子 agent,而 Jev 管轮次之间的那些调用:下一个跑哪个角色、哪些返回结果留下、目标算不算达成。
每轮三个 Jev 调用只花不到一美分,所以循环可以在每一轮之后都问一次「干完了吗」,然后自己停下。当这个「完成检查」落进中间地带时,一次带完整状态的 K3 调用来做决定。
十一、阈值与上线
阈值按动作设,不按模型设。TypeSafe 文档里用 0.5 作为转人工的下限、0.9 作为任何破坏性操作前的要求,并且明确说这是例子而不是默认值。把一封 newsletter 归档,可以比标记欺诈低得多就自动放行。
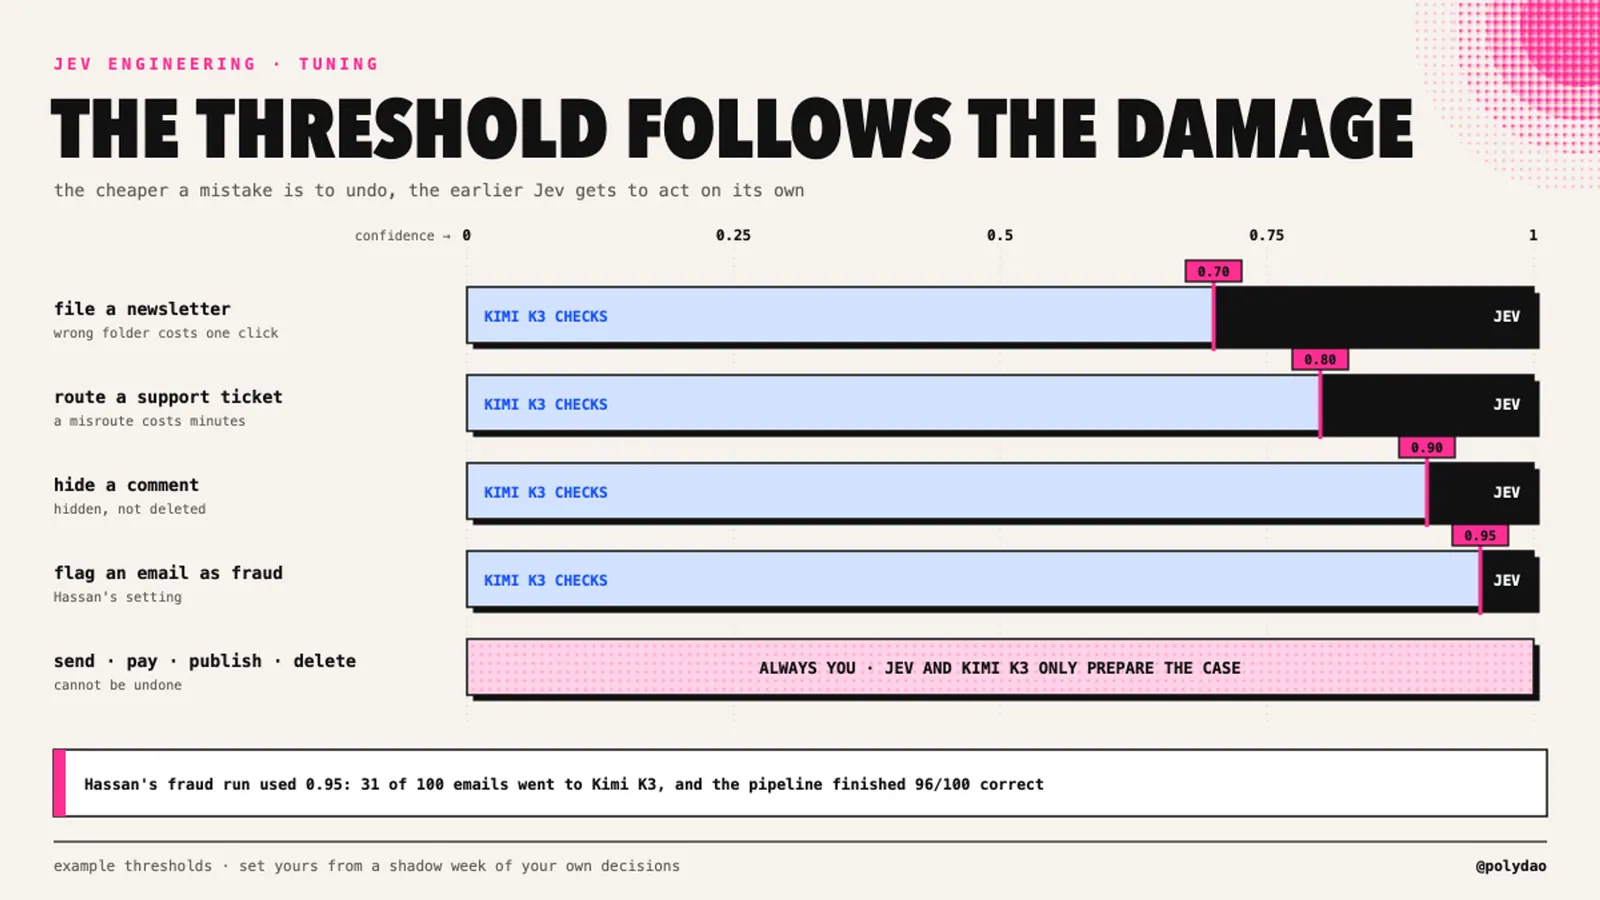
先跑一周影子模式。 让 Jev 打标签,同时仍由老路径做决定。然后按置信度分档对比:如果 0.9 以上那档几乎每次都和你一致,这一档先转自动。
钉住版本,并且全部记日志。 模型 ID、完整概率分布、阈值、是哪一层答的、接下来发生了什么。日志就是你的评测集;钉住版本,意味着你的阈值下个月还是同样的意思。
把问题当代码对待。 改一句 criteria,就是改线上行为。给它版本、在有标注的集合上测、跑偏了就回滚。
十二、算一笔账
每月 1 万封邮件。假设:Jev 每封约 1,000 输入 token,整次模型调用 1,500 输入 + 300 输出,其中 10% 升级。
| 方案 | 价格 | 每月成本 |
|---|---|---|
| 前沿模型读每一封邮件 | 每百万 10 美元输入 / 50 美元输出 | 300 美元 |
| Kimi K3 读每一封邮件 | 每百万 3 美元输入 / 15 美元输出 | 90 美元 |
| Jev 全量 + 它拿不准的 10% 交给 Kimi K3 | Jev 0.42 美元 + K3 9.00 美元 | 9.42 美元 |
TypeSafe 自己的级联估算放大到那个量级也是同一个结果:100 万张支持工单,约 6,480 美元,而不是 30,400 美元。
十三、这套东西怎么挣钱
| 方向 | 怎么收钱 | 先要有什么 |
|---|---|---|
| 给小企业做分类分流 | 一笔搭建费,加每月维护费(级联、复核队列、阈值复查) | 先在自己的收件箱上跑一套级联,攒一个月日志 |
| 给财务团队做欺诈与发票筛查 | 按邮箱收费;拦下一次打给仿冒供应商的付款,就抵得上好几年 | 在他们真实邮件上的影子模式结果 |
| 做 agent 成本审计 | 一笔固定费用,梳理某个团队的 agent 循环,把它的判断类调用搬到 Jev | 用第二节那四个桶,把你自己 agent 的每一步分好类 |
第三个是最快能卖出去的。每个跑 agent 的团队都在为「判断」付前沿模型的价格,而审计能直接指给他们看:哪些调用该搬走。
最短版
把 agent 的每一步分成四类:创作、精确规则、从已知答案里挑、不可逆。把第三类搬到 Jev,相关的问题合成一次调用,criteria 写成情形并留出口,按动作分别设置信度阈值。Jev 拿不准的交给 Kimi K3,不可逆的步骤留给自己。
从一个你的 agent 每天要做五十次的决定开始。
技术栈
📁 Jev by TypeSafe AI ↳ https://typesafe.ai
📁 Jev API 文档 ↳ https://docs.typesafe.ai/api
📁 Kimi K3 API ↳ https://platform.kimi.ai
📁 Hassan 的 Jev + Kimi K3 欺诈流水线 ↳ https://github.com/Nutlope/jev-fraud
原文作者的其它入口
- 收藏原文:链接会变、新仓库每周都在冒出来,留着当参考 - 每周 AI 架构、量化交易与 agent 经济的深度长文:@polydao,那里放他未加工的 prompt、自定义技能和还没到发推火候的东西 - Telegram 频道 Buzzoni Notes:t.me/+Wf8q84QkpyJhNjIy
数字来源与口径
对 TypeSafe 官方页面逐条回查的结果如下:
- 0.042 美元 / 百万 token、64K/32K token 上限、模型 jev-1.13.0、纯文本输入:与 docs.typesafe.ai/models 一致。
- 193.6 倍快、444.6 倍便宜:typesafe.ai 首页原文为「193.6x Faster, 444.6x Cheaper. *based on workflows for System One tasks (proof)」,旁边示例是 TypeSafe AI 0.000081 美元 / 0.114 秒,对照 LLM 0.013880 美元。这是厂商自己的评测,公司自己称其为「能期待的上限」。
- 12.2 倍便宜、10 倍快:文档站的 cookbook「Parallel questions」里写着,把 13 个问题合成一次 TypeSafe 调用「便宜 12.2 倍、快 10.0 倍,答案没有变化」;原文配图脚注注明该测试基于 jev-1.12、文档 53,777 字符。
- 0.5 转人工下限、0.9 破坏性操作前的要求:与文档站 Confidence 页一致(低于 0.5 走 route_to_human,高风险动作且置信度大于 0.9 才 confirm_then_execute)。 - **速率限制对不上**:原文写的是 jev-1.13 上每秒 1,200 个请求、250,000 token;官方文档当前写的是每秒 80 个请求、每秒 100K token。两处数量级不同,且文档说「限制会随容量调整」,请以调用时的文档为准。 - **Hassan 的 100 封邮件运行(1.42 秒、31 封升级、96/100、约 0.07 美元)**:出自他公开的运行结果与原文配图,本文未能独立复现。 - **Browser Use、1kpapers.com、Riley Brown、awlevin、tamara、Jarrod Watts 等案例数字**:均转述自原文,未独立核实。
来源与版权
- 原文:《How to Cut Your Agent Bill by 90% With Jev Engineering and Kimi K3》,作者 Mr. Buzzoni(@polydao),2026 年 9 月 29 日发布于 X 长文。原文链接:x.com/polydao/status/2104783226833186920
- 原文提到的一手材料:TypeSafe AI 官网、Jev API 文档、Kimi K3 API、Hassan 的开源欺诈流水线
- 配图:9 张均取自上述 X 长文,版权归原作者及原权利人(其中两张为影视/动画画面,仅随原文引用,不代表授权)。如权利人提出异议将移除。
- 取回路径说明:x.com 在本机网络不可达(直连超时),正文经第三方镜像 API api.fxtwitter.com 取回,配图经图片代理 wsrv.nl(多数)与 i0.wp.com`(兜底)下载;其中 7 张为原始尺寸,2 张为代理封顶的 1200 像素宽。正文与数字未做改写,翻译与整理过程中未加入原文没有的结论。