Dream-RSI 拆解:把探索历史当模拟器,让 agent 自己改搜索策略
arXiv 2609.14858,标题 Dream-RSI: Recursive Self-Improvement through Evolving Worlds。2026 年 9 月 14 日提交,10 月 6 日更新到 v2,11 页,归类在 cs.CL。作者 17 人,署名包括 Google、Google DeepMind,以及马里兰大学和弗吉尼亚大学的研究者。代码在 github.com/zhengkid/Dream-RSI,项目页 dream-rsi.com。
一、它要解决的问题:策略比候选更难改
递归自我改进(RSI)的常见形态是:agent 提候选方案,评测器打分,反馈回下一轮,几千个循环之后收敛出一个好结果。AlphaEvolve、OpenEvolve、ShinkaEvolve、PACEvolve 都属于这条线。
论文的判断是,真正卡住效率的不是”生成候选”,而是决定往哪挖、并行几条、什么时候停的那套探索策略。
现有做法两头堵:手写一套固定策略,搜索空间一大就不适配;在线优化策略,反馈又太慢太贵——评估一个策略好不好,得让它跑完许多轮提议-评测才知道,而元级策略空间本身巨大,试一轮就是一次长回合。
二、核心洞察:跑完的那棵树,本身就是模拟器
一次完整探索留下的不只是文本日志,而是一棵结构化的树:每个节点是一次尝试,带完整的文件系统快照、累积观测和评测分数。
换一个探索策略,在这棵树里只是走法不同——挑别的分支、换顺序、改并行分组、提前停。因为每个节点的结果都已经存着,评估新走法只要”读”已经发生过的结果,不必再启动一次 agent 和评测器。
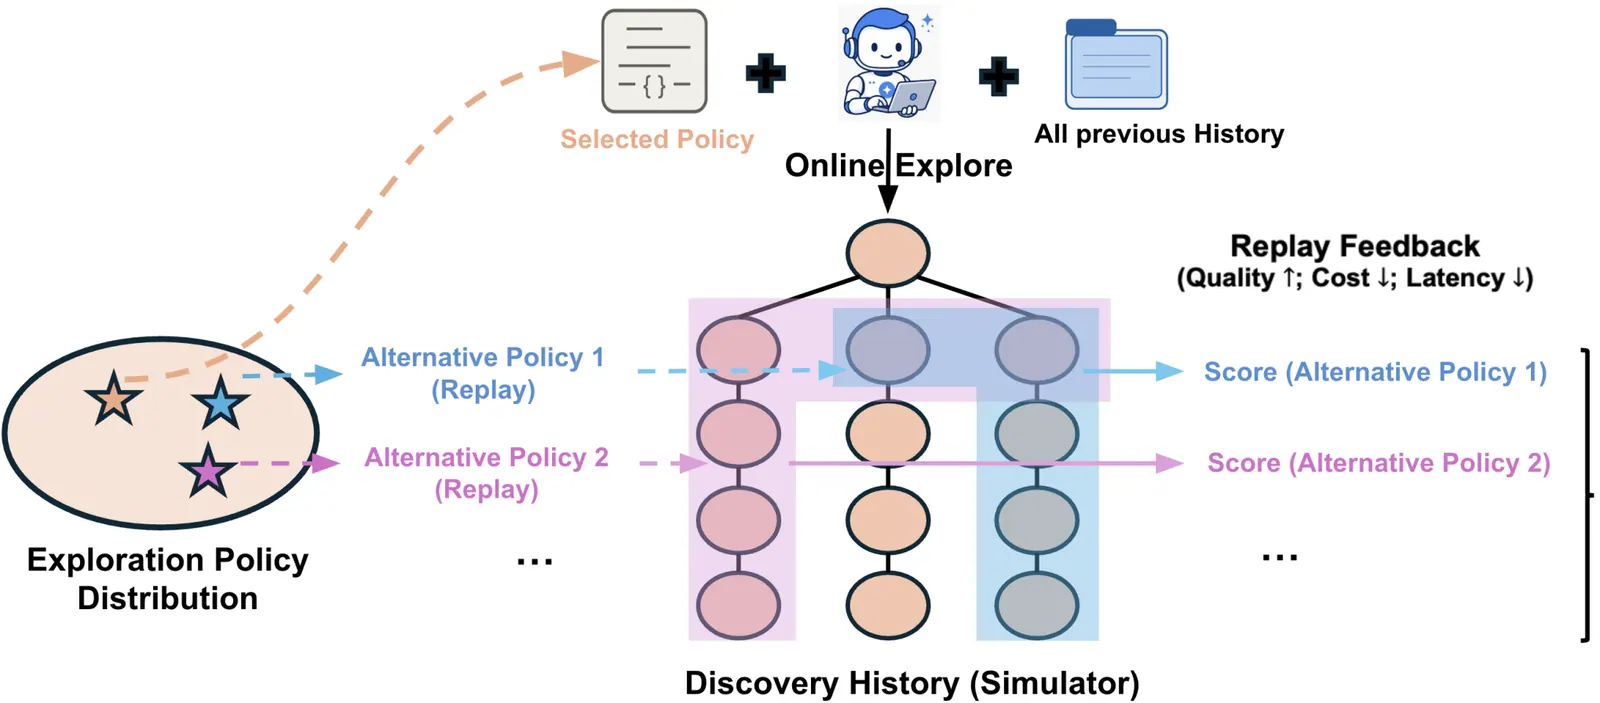
作者把这个和基于模型的强化学习、Dreamer 系列做类比:先有环境模型,再在模型里想象轨迹来改策略。区别在于,这里的世界模型不是学出来的,是已经付过费的真实探索记录。
三、三层循环怎么跑
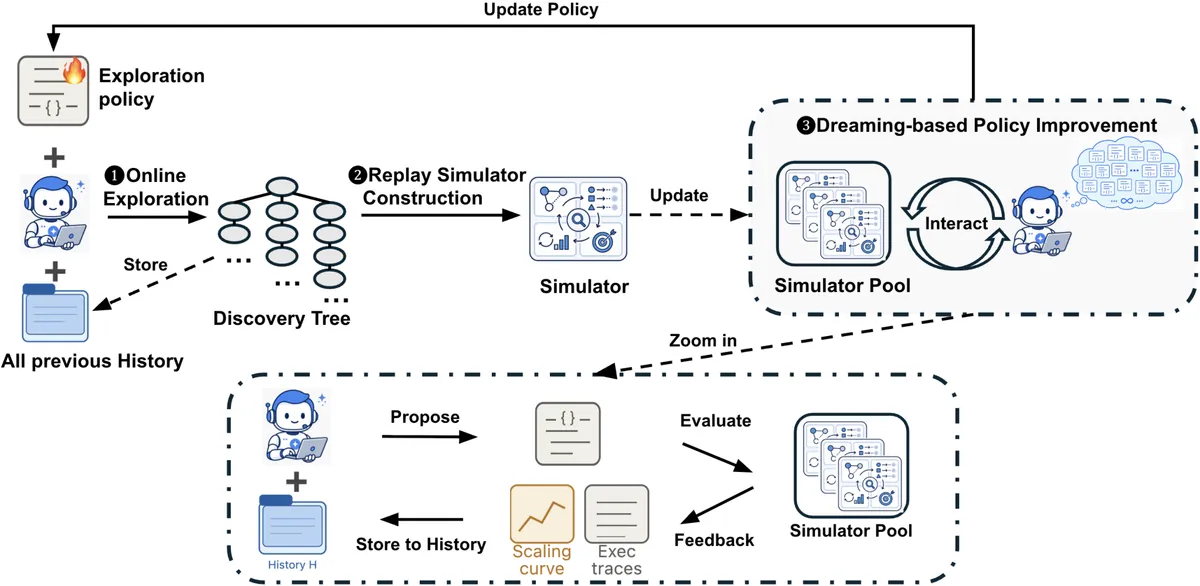
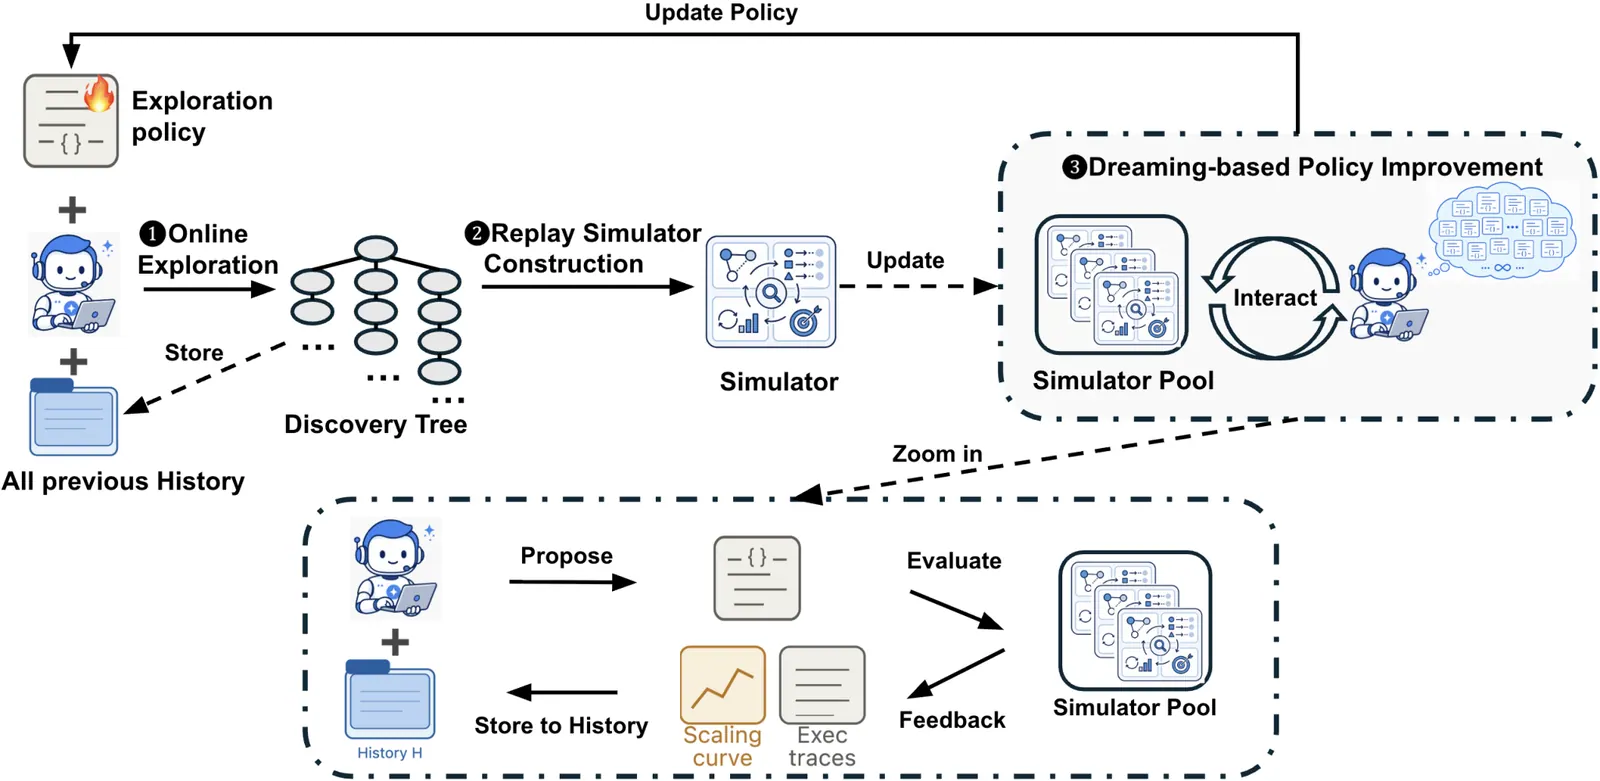
- 在线探索:当前策略驱动一个固定的 coding agent 长树,每次尝试都记录结果,评测器按固定协议打分。
- 回放模拟器构建:这棵树被整理成可复用的模拟器池,跨轮累积。
- dreaming 改策略:同一个 agent 读回放轨迹和分数,把策略代码改写成新版本。每个离线阶段评估当前版本加 3 个新版本(M=4),在同一批树上算平均回放分,取最高分上线。
回放不只是”重放”,它要算一个预算曲线上的归一化超体积(质量-成本前沿),再减一个并行度惩罚项,鼓励”用更少调用、更多并行拿到更高分”。因为当前策略本身也在候选里,新策略的平均回放分不会低于旧策略。
整套机制只改策略代码,模型、评测器、执行接口都不动。这是它和”改权重、改提示词”路线最大的不同。
四、四组实验的数字
九个任务,四个领域。
| 领域 | 任务 | 关键结果 |
|---|---|---|
| GPU kernel(KernelBench) | VGG16 / LayerNorm / ConvDiv / ConvMax | 前两个在同等性能下少用 2.43× 和 1.79× 的 generation;后两个在相近预算下性能高 2.09× 和 1.44×;超过 PACEvolve |
| 算法工程(Lasso 正则化路径) | 6 个 held-out 数据集(含生物与非生物) | Gemini-3.1-Pro:平均运行时间 3587.1 ms → 2931.0 ms,调用 550 → 317;Gemini-3.7-Flash:2516.7 ms → 2350.6 ms,3200 → 1879 |
| 数学优化 | Sum-Difference / Circle Packing / Autocorrelation | Sum-Diff 1.145427,高于固定探索的 1.144047 和 SimpleTES 的 1.143975;Circle Packing 2.635983,与最强结果持平;Autocorrelation 1.456375 |
| Harness 优化 | Terminal-Bench 2.1(Claude Opus 4.8 + Claude Code) | 全量分 0.7247 → 0.8090,涨了 8 个点以上;同期 Claude Code 0.75、Meta-Harness 0.79 |
Lasso 那组的对比最值得看:SimpleTES 报的是 51,200 次生成,Dream-RSI 在 Pro 与 Flash 上分别只用约 162× 和 27× 更少的 agent 调用,下游平均运行时间还更低;六个 held-out 数据集上也都优于 sklearn 和 glmnet。
五、消融与行为分析
历史要不要累积? ConvDiv 上,用全部历史得 1.90(786 次调用),只用当前轮是 1.59(430 次调用)。多花算力换来更高分,作者的解释是累积的模拟器能学到更通用的策略,避免过拟合单一世界。
策略会自己调节探索力度。 ConvDiv 上,分数往上走时它先省算力,把每轮尝试从 110 次压到 50 次;卡住之后又加大探索,随后出现新的性能提升。
六、和已有工作的关系
- 进化式发现系统(AlphaEvolve、OpenEvolve、CodeEvolve、ShinkaEvolve、PACEvolve、DeltaEvolve、MLEvolve)改的是候选解;EvoX 开始显式优化搜索策略,但受限于在线评估的延迟。
- 自进化 agent 改权重、harness、上下文、技能、评分规则;Dream-RSI 改的是元层的探索策略。
- 记忆与经验复用类工作,把历史当上下文、当微调数据、当技能库;这篇把历史当成能被反复查询的模拟器。
七、我的判断:哪些数字能直接用,哪些要打折
能用的是机制。 “把已经付过费的在线回合变成离线评估器”这个接口很干净,而且不绑定模型,换成任何 coding agent 都能接。它解决的是 RSI 里最贵的一环——给策略打分的成本。
要打折的地方有四处:
- 162× 和 27× 跨了 backbone。 SimpleTES 用的是 gpt-oss-120b,Dream-RSI 用 Gemini-3.1-Pro / 3.7-Flash,论文自己也注明”不同模型骨架”。这个倍数不能当成同条件对比。
- Lasso 的平均改善主要由 RCV1 一个数据集拉动。 Pro 版本在其余五个数据集上反而更慢(比如 DNA 从 41.5 ms 升到 49.9 ms),均值好看不等于全面变好。
- 数学任务是毫厘之争。 Sum-Diff 提升约 0.1%,Circle Packing 所有方法都贴在 2.635983 上,说明这个任务已经撞到上限,看不出区分度。
- 模拟器只覆盖”已经走到的世界”。 回放只能在记录过的树里换走法,走不到的分支、没出现过的新方向,模拟器给不了信号。它优化的是”怎么走”,不是”去哪个新世界”——论文标题里的 “Evolving Worlds” 实际是模拟器池在变大,不是环境在生成。
另外,harness 那组没有配固定策略的对照组,作者的理由是再跑一遍完整搜索估计要超过 10 万美元。这个解释合理,但也意味着 +8 点里有多少来自策略改进、有多少来自其他因素,读者没法自己拆。
一句话总结: 这篇论文真正值钱的不是某个 SOTA 分数,而是把”历史”从上下文材料升级成评估基础设施。RSI 的瓶颈从生成能力挪到评估成本之后,这类”用旧账本来评估新策略”的思路,比再训一个更大的模型更省。