不写代码,只按合并键:xAI 工程师用 12 层体系管住 200 个云端 Agent
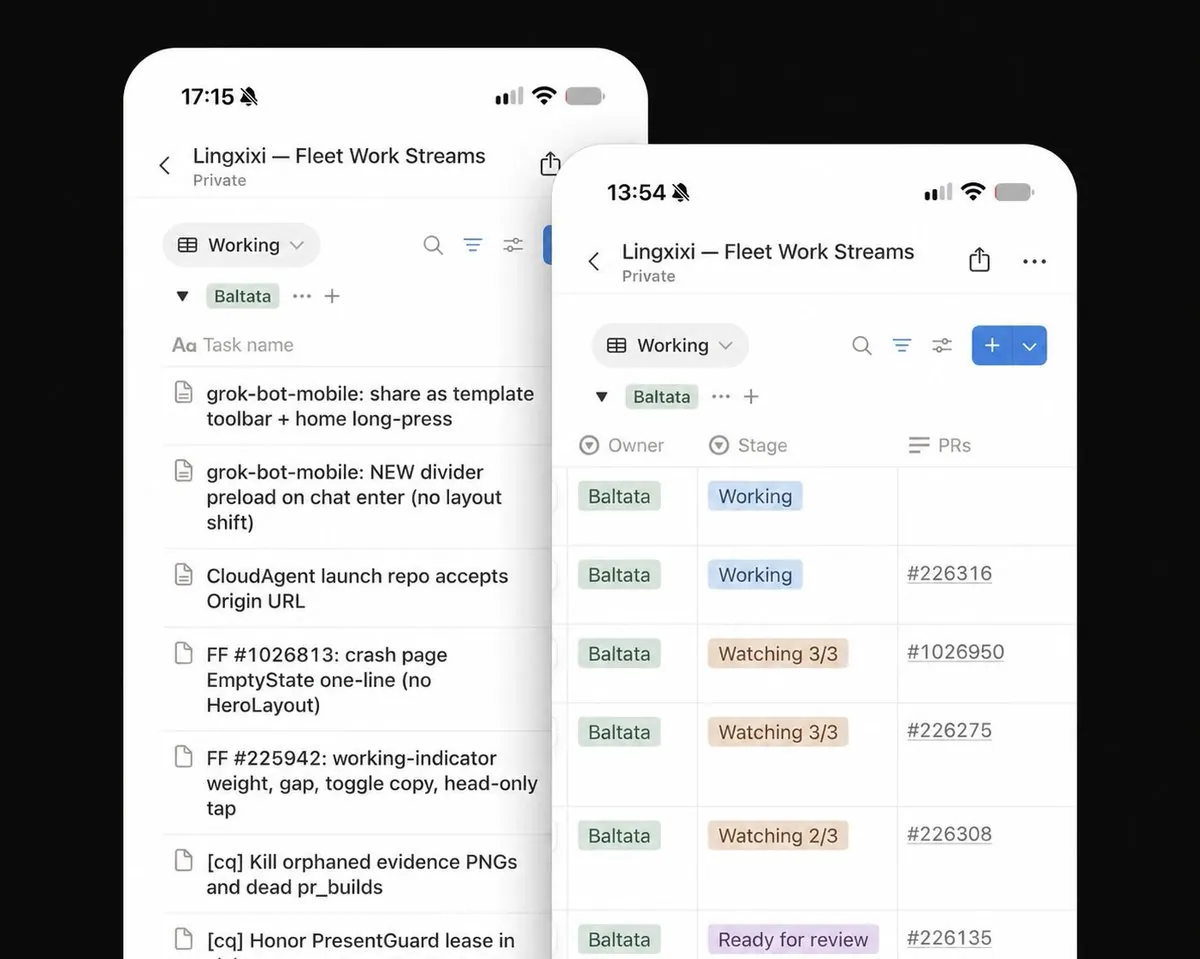
Lingxi Li 在 SpaceXAI 做工程,这家公司做的产品叫 Grok。9 月 10 日,他写了 xAI 官方的《Grok Bot for Engineering》指南。
指南里有一组前后对比:他原来靠手动管大约 15 个云端 agent,现在是同一时间 200 多个,管这些 agent 的是一队 Grok Bot。
他不写代码,也不逐个盯 agent 的过程。他只做合并。
一、先把分工定死:Bot 管事,Agent 干活
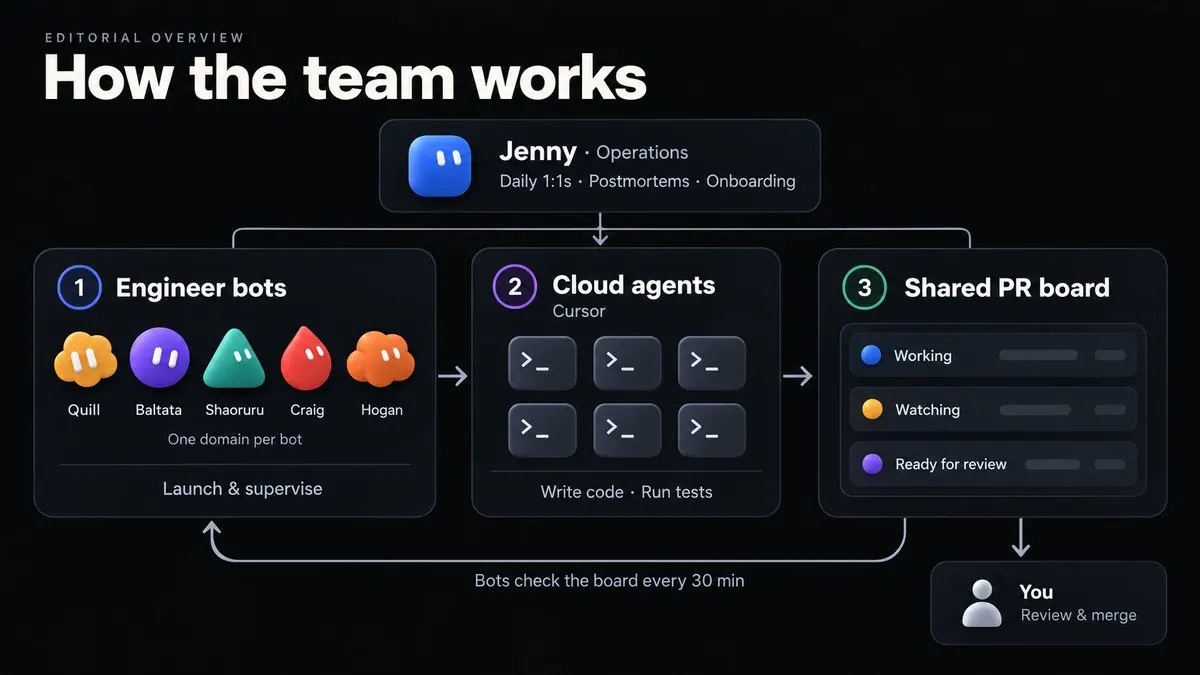
整份指南压在三条分工上:
- 工程师 Bot 各占一个领域。 它们不写代码,负责启动 Cursor 云端 agent 并监督。
- 一块共享的 PR 看板。 每个 Bot 每 30 分钟查一遍。
- 一个运营 Bot。 管团队日常:每天 1:1、事故复盘、新人上手。
一句话概括:Bot 是管理者,云端 agent 是干活的人,你是那个合并按钮。
适用范围也写清楚了:一天只跑一两个 agent,开一个对话窗口还更快。这套东西是给「瓶颈就是你自己」的人准备的。
想复现,得先有这四样:
- Grok Bot,付费 Cursor 套餐和 Cursor Teams 自带,或者用 SuperGrok;
- 一个 Bot 能访问到的仓库;
- 用来写代码的 Cursor 云端 agent;
- Notion,可选项,放 PR 看板。
先把这 12 层放在一起看,后面每一层都能对上位置:
| 层 | 解决什么 | 关键动作 |
|---|---|---|
| 01 | 一个 Bot 只占一个领域 | 先写名单,writes_code: false |
| 02 | 不必从零搭 | 市场里装 Lingxi’s Engineer Bot |
| 03 | agent 能自己跑通一遍 | .cursor/environment.json + 模拟器截图 |
| 04 | 委派带证据 | TASK / DONE WHEN / PROOF / DON’T |
| 05 | 管理者也有规矩 | 话短、不擅自动默认分支 |
| 06 | 团队的口味可复用 | proof-of-work 之类 skill |
| 07 | 所有 PR 上一块看板 | 每 30 分钟查,连续四次干净才 ready |
| 08 | 检查变成例程 | BLOCK 规则 + 永不自动合并 |
| 09 | 运营有人管 | 早 5 点 1:1、事故复盘 |
| 10 | 夜里也在看 | 3 点审计、P0 五分钟盯守 |
| 11 | 人机同一个入口 | Team Bot、Primary Bot |
| 12 | 多个项目并行 | 一项目一频道,上限六个 Bot |
二、层 01–02:先把队伍搭起来
层 01:一个 Bot 管一个领域,不是一件事
Lingxi 带了五个工程师 Bot,分工是:iOS 与共享移动层、桌面客户端与 CI/CD、基础设施、Android、Grok Bot 自己的 harness。它们有名字:Baltata、Shaoruru、Hogan、Craig、Quill。
每个 Bot 有独立记忆和受限的上下文。原文的判断是:一个对单个领域挖得深的 Bot,胜过什么都知道一点、但都很浅的那个。
先写名单,再建 Bot。下面这份 YAML 是原作者自己定的格式,Grok Bot 并不读这个文件:
team: app-engineering
human_owner: you
bots:
  - name: ios-bot
    domain: iOS 应用与共享移动层
    repos: [github.com/your-org/mobile]
    writes_code: false
    delegates_to: cursor-cloud-agents
  - name: web-bot
    domain: Web 客户端与 CI/CD
    repos: [github.com/your-org/web]
    writes_code: false
    delegates_to: cursor-cloud-agents
  - name: infra-bot
    domain: 基础设施,以及归属不清的问题
    repos: [github.com/your-org/infra]
    writes_code: false
    delegates_to: cursor-cloud-agents
  - name: ops-bot
    domain: 剧本、1:1、事故复盘、新人上手
    repos: []
    writes_code: false
    delegates_to: none
注意每一行的 writes_code: false。整个方法就压在这一个字段上。
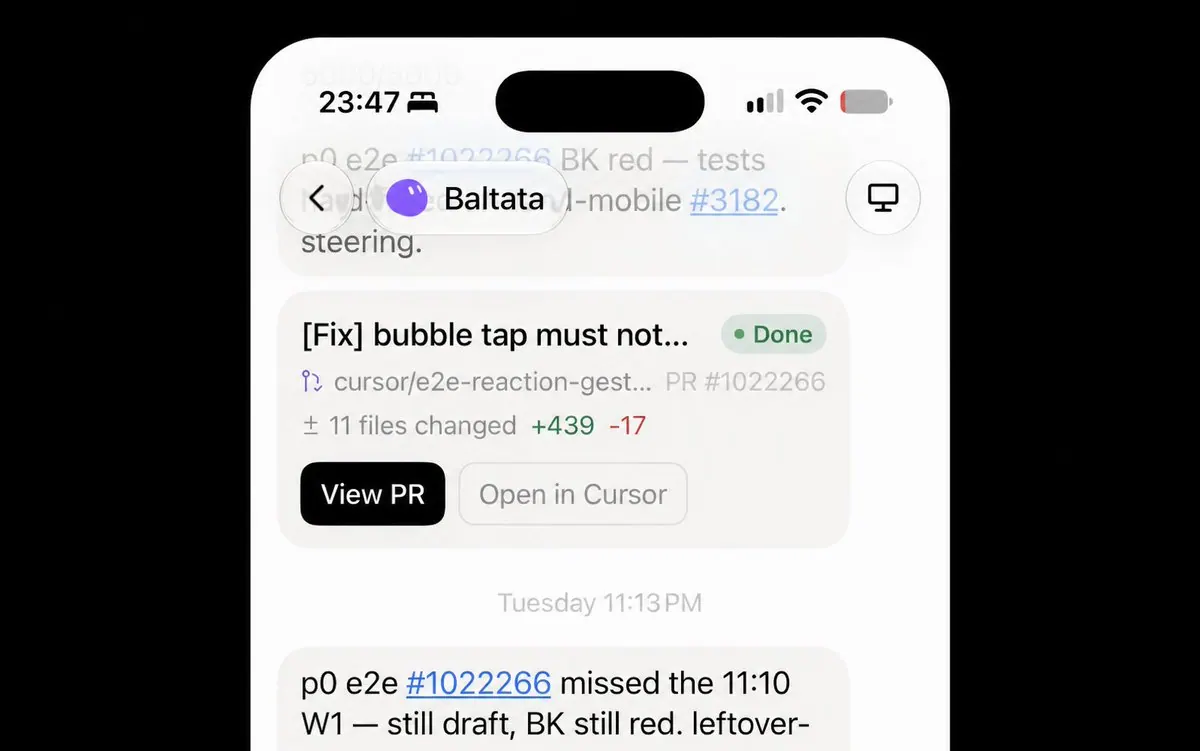
接着建第一个 Bot。这份开场白可以直接抄:
你是 ios-bot,我们 github.com/your-org/mobile 这个仓库里
iOS 应用和共享移动层的工程主管。

你自己永远不写代码。所有编码工作交给你启动并监督的
Cursor 云端 agent。

先研究这个仓库的技术栈和当前的最佳实践,把学到的存进记忆。
然后告诉我:
1. 你还需要哪些权限
2. 代码库里哪些部分你最没把握
最后两个问题把「入职」变成了「差距报告」。Lingxi 自己的说法是:把一个新 Bot 当成一个很有天赋的实习生来带。
层 02:也可以从现成的 Bot 开始
不必从零搭。「Lingxi’s Engineer Bot」已经上架 Grok Bot 市场。
它的第一轮对话就是入职流程:问你是哪个仓库、什么托管方式、用什么语言,然后研究那套技术栈的最佳实践并存进记忆。
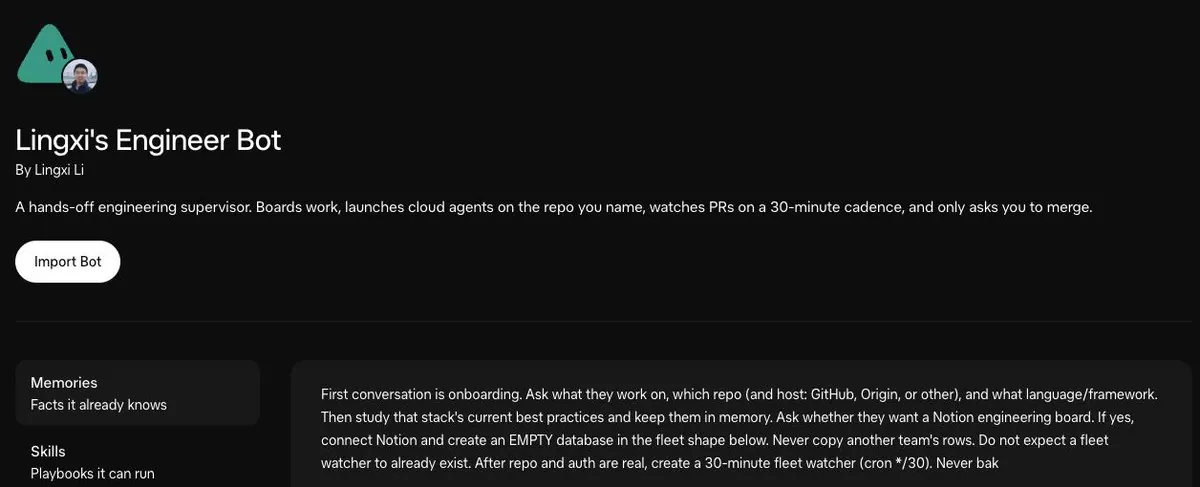
之后它会给你提供一个 Notion 看板,并把层 08 说的 30 分钟巡检建起来。
有个细节决定了整套体系的形态:你的所有 Bot 共用一台云端机器,互相之间能发消息、能交接任务。
三、层 03:给 Agent 一条能自己跑通的回路
这是指南的第一条建议。原文的说法是:跑不起自己代码的 agent,什么都证明不了。
在 Lingxi 的配置里,做视觉相关的活,agent 要交回 iOS 模拟器截图;做语音功能,就把语音 API 接到测试音频里。
在 Cursor 里,这条回路的起点是 .cursor/environment.json,它定义每个云端 agent 的机器怎么构建:
{
  "build": {
    "dockerfile": "Dockerfile",
    "context": ".."
  },
  "install": "pnpm install"
}
install 必须可重复执行。开发服务器和数据库按 Cursor 文档放在 start 或 terminals 里。密钥放仪表盘,永不进仓库。
仓库里的这个文件优先级高于任何已保存的环境配置,所以同一仓库上的每个 agent 拿到的是同一台机器。一个例外:自托管的机器永远不读它。
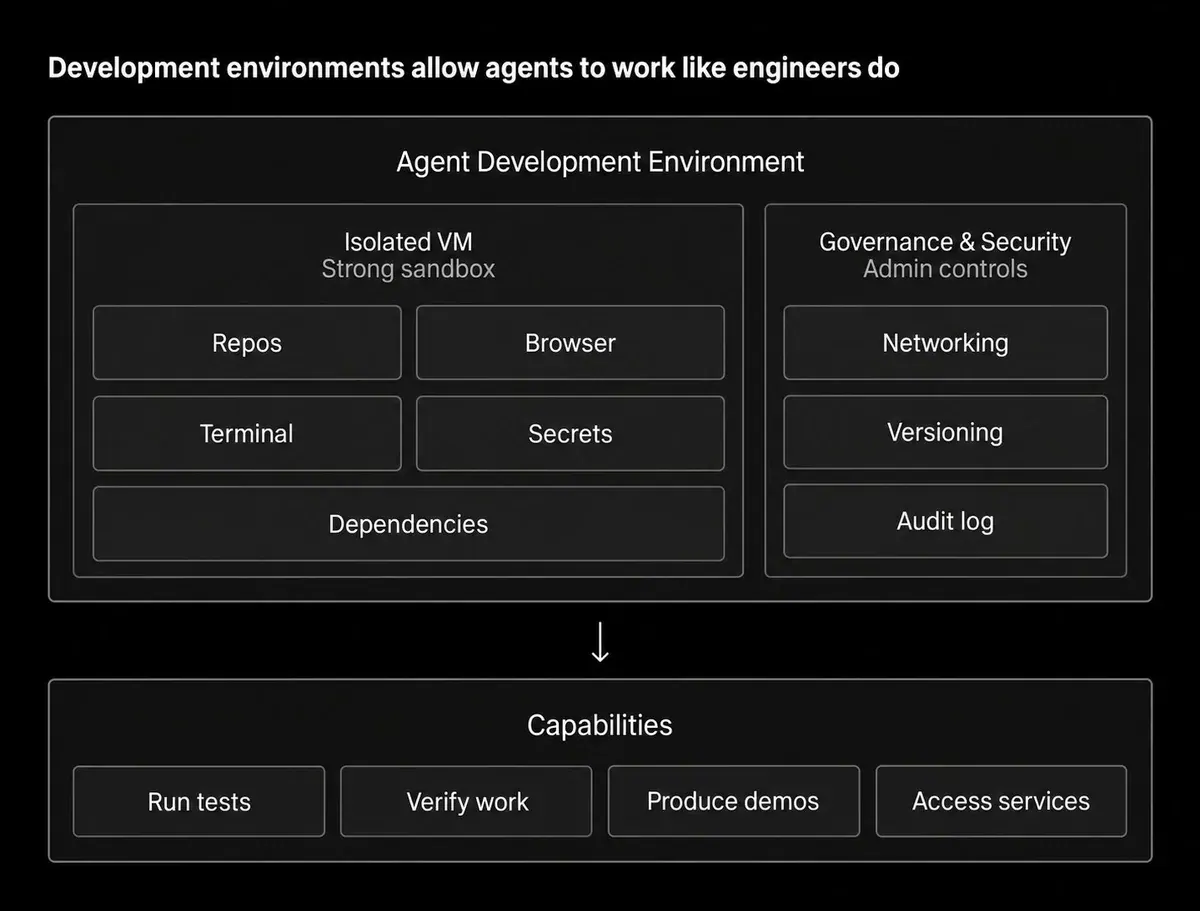
应用跑起来之后,Cursor 会探测它用了哪些端口,并在内置浏览器里打开,于是 agent 看到的画面你也能看到。在信任这条回路之前先验一遍:一个 agent、一块屏幕、一张托管出去的截图。
原文的总结是:没回路就没有证据,没证据就没有自主权。
四、层 04:每一行代码都带证据交出去
Bot 接到任务,就去起一个 Cursor 云端 agent,附一份任务说明:要做什么,以及要交回什么证据。启动是一次有文档的 Cursor API 调用:
curl -X POST https://api.cursor.com/v1/agents \
  -u "$CURSOR_API_KEY:" \
  -H "Content-Type: application/json" \
  -d '{
    "prompt": {
      "text": "TASK: 修掉无网络时打开设置页崩溃的问题。\nDONE WHEN: 设置页能离线打开,并显示缓存的个人资料。\nPROOF: PR 正文里附飞行模式下设置页的模拟器截图,以及修复前失败的那条测试。\nDON'\''T: 别碰网络层,别改公开 API。"
    },
    "repos": [
      { "url": "https://github.com/your-org/mobile", "startingRef": "main" }
    ],
    "autoCreatePR": true
  }'
autoCreatePR 让 agent 干完之后自己把 PR 开出来。prompt 里那四行是作者给的模板:
TASK挡住 agent 顺手去解决旁边那个问题;DONE WHEN给它一条自己能核对的终点线;PROOF逼它交证据,而不是交一句「做完了」;DON'T把它本来会「顺手优化」的代码围起来。
四条里最重要的是 PROOF。Lingxi 上架的那个 Bot 要求每个 agent 都证明自己的活:真实的、托管出去的、验证过的,而且放在 PR 正文里,不是放在分支上。
agent 跑偏的时候,Bot 通过 POST /v1/agents/{id}/runs 给同一个 agent 追加一条后续指令。如果上一轮还在跑,Cursor 返回 agent_busy。
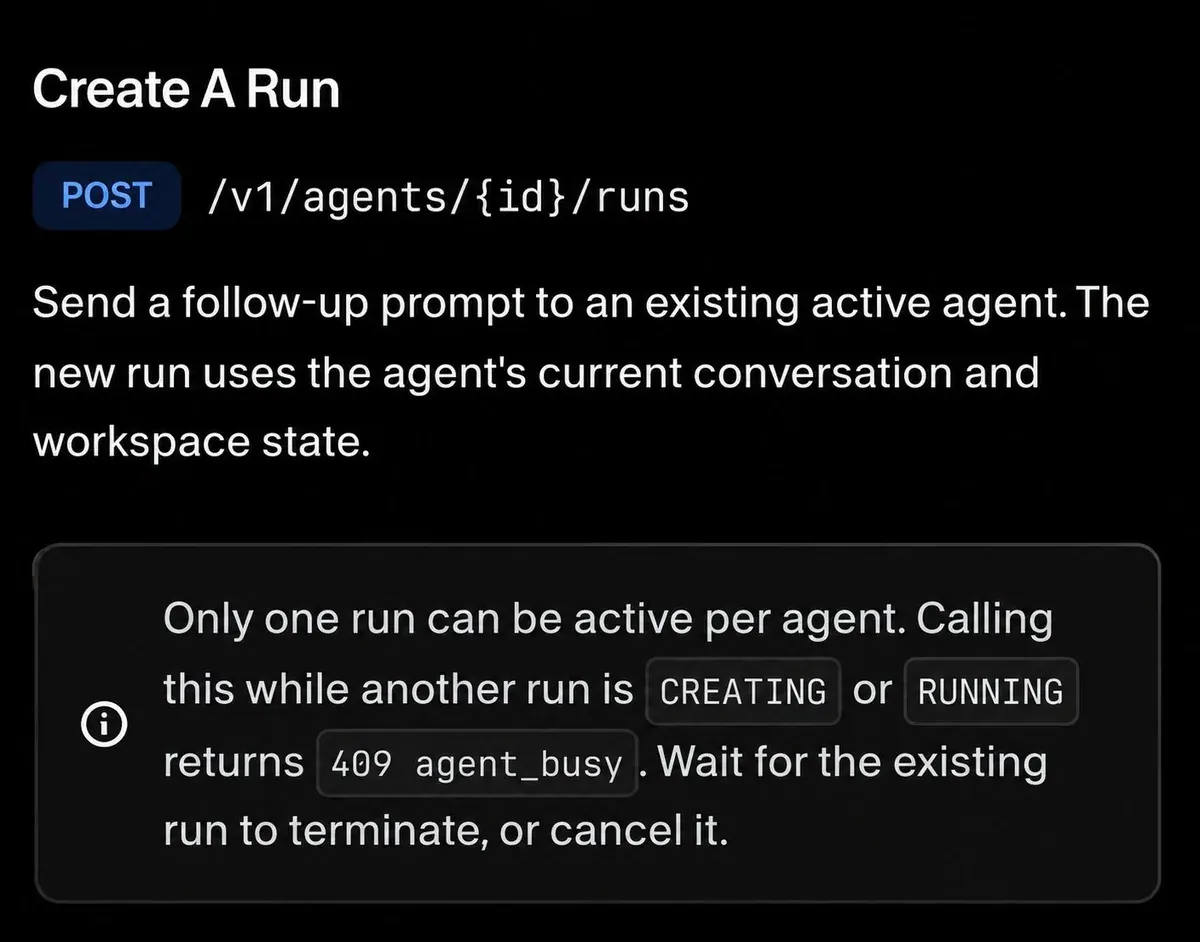
Bot 也可以订阅一轮运行的事件流,边跑边读。取消是不可逆的:被取消的运行不能续跑,只能追加新指令。
五、层 05:给管理者自己写两条规矩
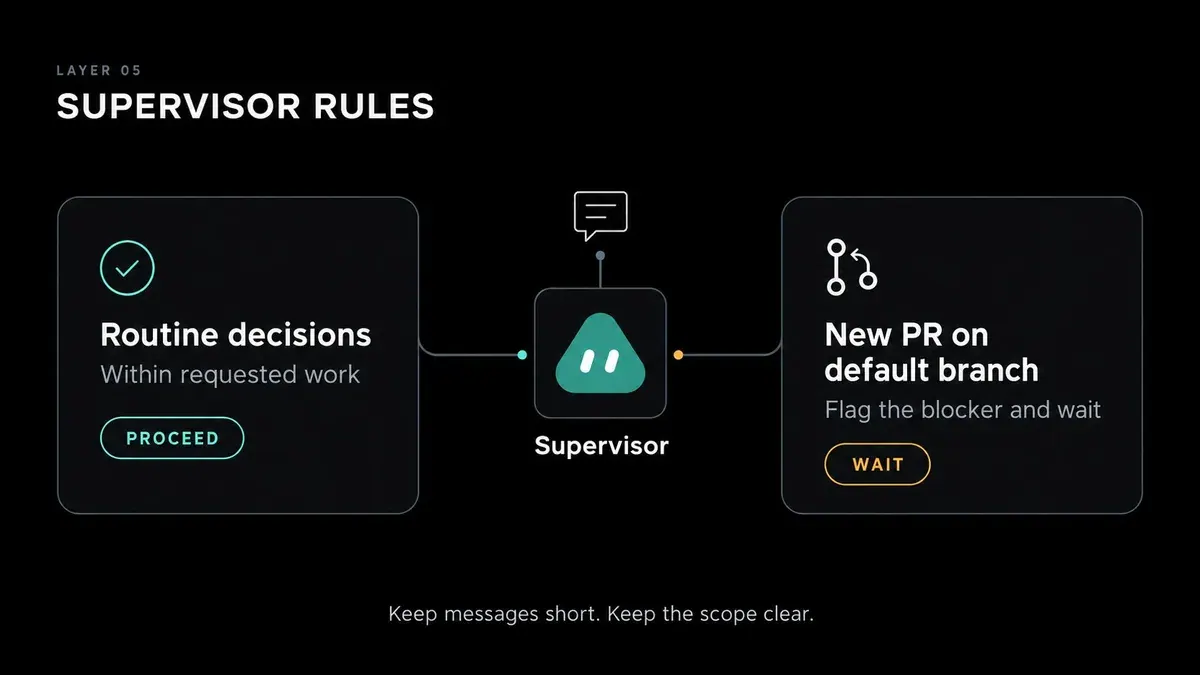
Agent 有任务说明,管它的 Bot 也得有规矩。上架的那个 Bot 给自己定了两条:
- 话说短。 对当前任务里的常规决定,自己拍,不用问人。
- 不主动往默认分支开新 PR。 遇到卡点就上报,然后等。
第一条把你从小决策里摘出来,第二条拦住 Bot 自己发明活。
「停」也是规矩的一部分。9 月 17 日的一次更新之后,停掉一个 Bot,它派出去的下级 Bot 和云端 agent 会一起停。
哪些活该先交给 Bot?指南给的标准是:一天要做一次以上、而且有明确套路的事。
Agent 也不一定跑在云上。指南里用了一台闲置的 Mac mini,需要走 VPN 或者要用 iOS 模拟器的活,交给 Cursor Cloud 的私有 worker。
六、层 06:把团队的口味做成 skill
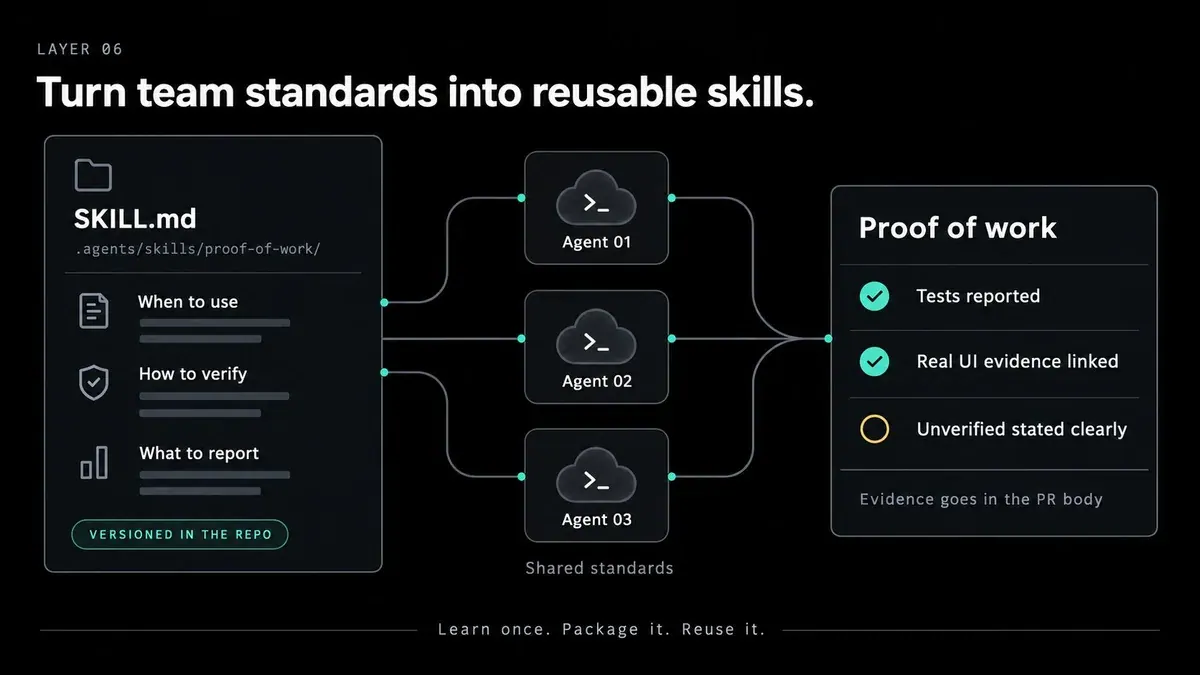
任务说明讲做什么,skill 讲你们团队怎么做。
Lingxi 的 Bot 用 /lingxi-design、/lingxi-review、/react-native-best-practices 这类 skill。在 Cursor 里,一个 skill 就是 .cursor/skills/ 下一个带 SKILL.md 的目录。Cursor 同时也读 .agents/skills/ 和 .claude/skills/,所以一个 skill 目录可以同时服务不止一个编码 agent。
文件顶部的元信息长这样:
name: proof-of-work
description: 在开 PR 或更新 PR 之前使用。定义了一个 PR 要带上哪些证据,才能被标成 ready。
正文是「Proof of work」一节,五条要求:
- 跑完整测试套件,把汇总那一行贴进 PR 正文。
- 任何 UI 改动,都从跑起来的应用里截前后对比图,托管出去,把链接放进 PR 正文。
- 截图和日志永不出现在分支里。
- 检查挂了就修根因。不许为了让它过而放宽、跳过或删掉失败的检查。
- 把没能验证的东西列在「Unverified」下面。
第 3、4 条来自上架的那个工程师 Bot。第 5 条是作者自己加的:一份诚实的「未验证」清单,比一句自信的「做完了」值钱。
还有两个可选字段好用:paths 限定 skill 只对匹配的文件生效,disable-model-invocation: true 让它只能被点名调用。
指南的第二条建议是:agent 学到有用的东西,就把它打包成仓库里的一个 skill。这样 skill 目录就变成了团队的记忆。
七、层 07–08:所有 PR 上同一块看板,30 分钟巡一遍
15 个 agent 变成 200 个,靠的就是这一层。每 30 分钟,每个 Bot 检查共享 Notion 看板上的每个 PR:有没有 Bugbot 或安全评审的评论、CI 是不是挂了、有没有真的合并冲突。
- 发现问题:给云端 agent 追加指令,这一行退回 Working。
- 干净:这一行往 Ready for Review 走,同时起一轮评审。
- 风险低、评审置信度高:Lingxi 的体系会自动合并。
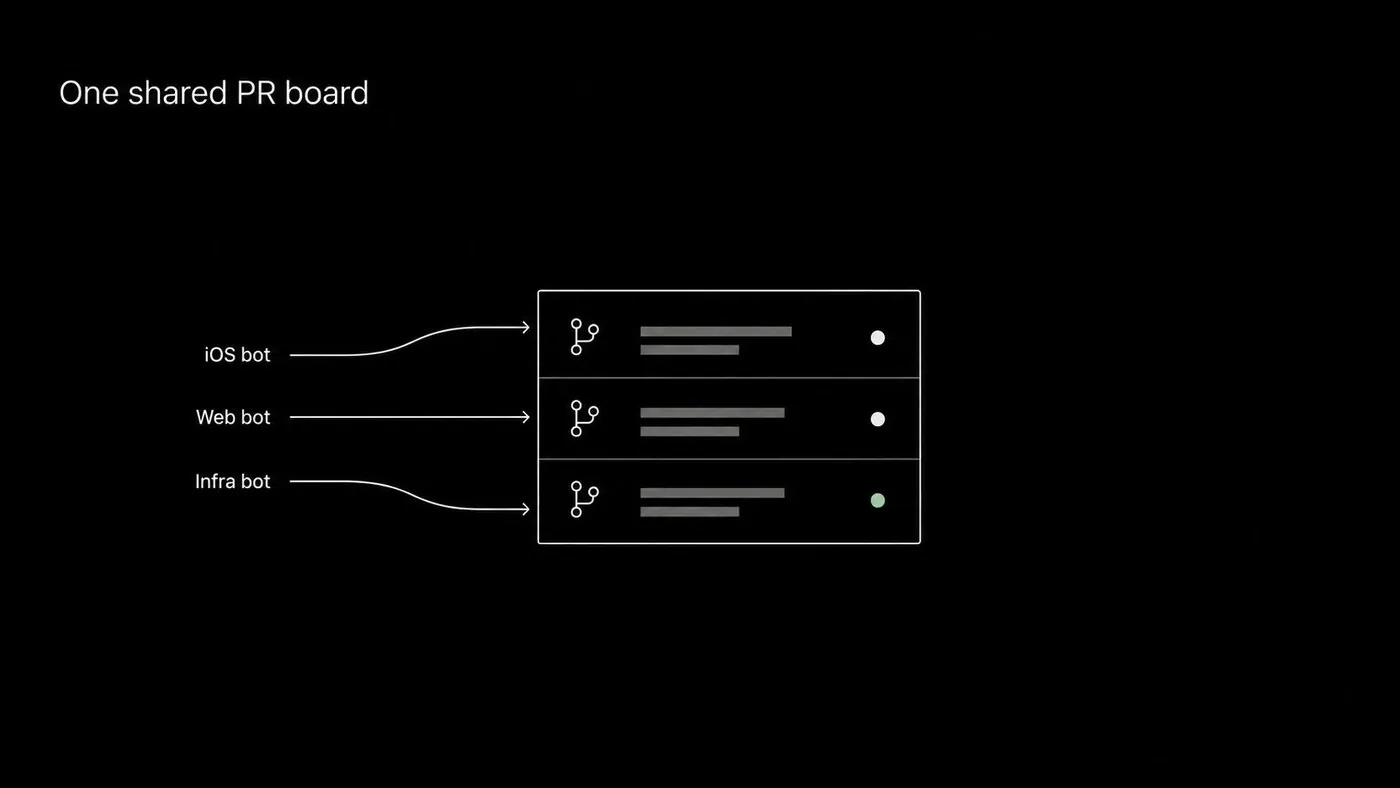
上架版本的 Bot 用的是固定表结构。下面是作者把它转写成 YAML 的样子:
fields:
  - Task name        # 干净标题,不带 PR 号,不带状态字样
  - Owner
  - Stage
  - PRs
  - Cloud agent
  - Last commit
stages:
  main: [Working, Watching 1/3, Watching 2/3, Watching 3/3, Ready for review]
  side: [Holding, Blocked, Done, Cancelled]
agents_never_write: [Status, Assignee, Due date]
状态、负责人、截止日期这三项留在人手里。被标成 Blocked 的行会一直等,卡片上写着原因。
还有两条让看板保持可读:任务名是干净的标题,不带 PR 号也不带状态;一个 Bot 不会去改别人负责的 PR。
这截梯子是最巧的一处。一个 PR 要连续四次检查干净,才够格进 Ready for review。Bot 自己的规矩里写着一句:「永远别停在 3/3。」
层 08:让一个例程每 30 分钟看一遍
看板得有人查才有用。这就是 Grok Bot 的 routine:工程师 Bot 建一次的 30 分钟 cron。每次触发时执行:
每 30 分钟,对看板上的每个 PR:

满足任一条件就 BLOCK:
  - CI 失败或检查项失败
  - 有安全发现
  - 还有没解决的 bot 或安全评审讨论
  - 真的合并冲突(rebase 到默认分支)

以下情况 DON'T BLOCK:
  - 只是要求评审的门槛
  - 分支只是落后于主干

BLOCK 时:  给云端 agent 追加指令,Stage = Working
CLEAN 时:  往上走一格 Watching
过了 3/3:  再多一次干净检查,然后 Stage = Ready for review
NEVER:     没有人工明确点头,不许合并
每一行都来自上架 Bot 的规则。只在真冲突时才 rebase,能避免 agent 每次主干一动就把 PR 翻一遍。
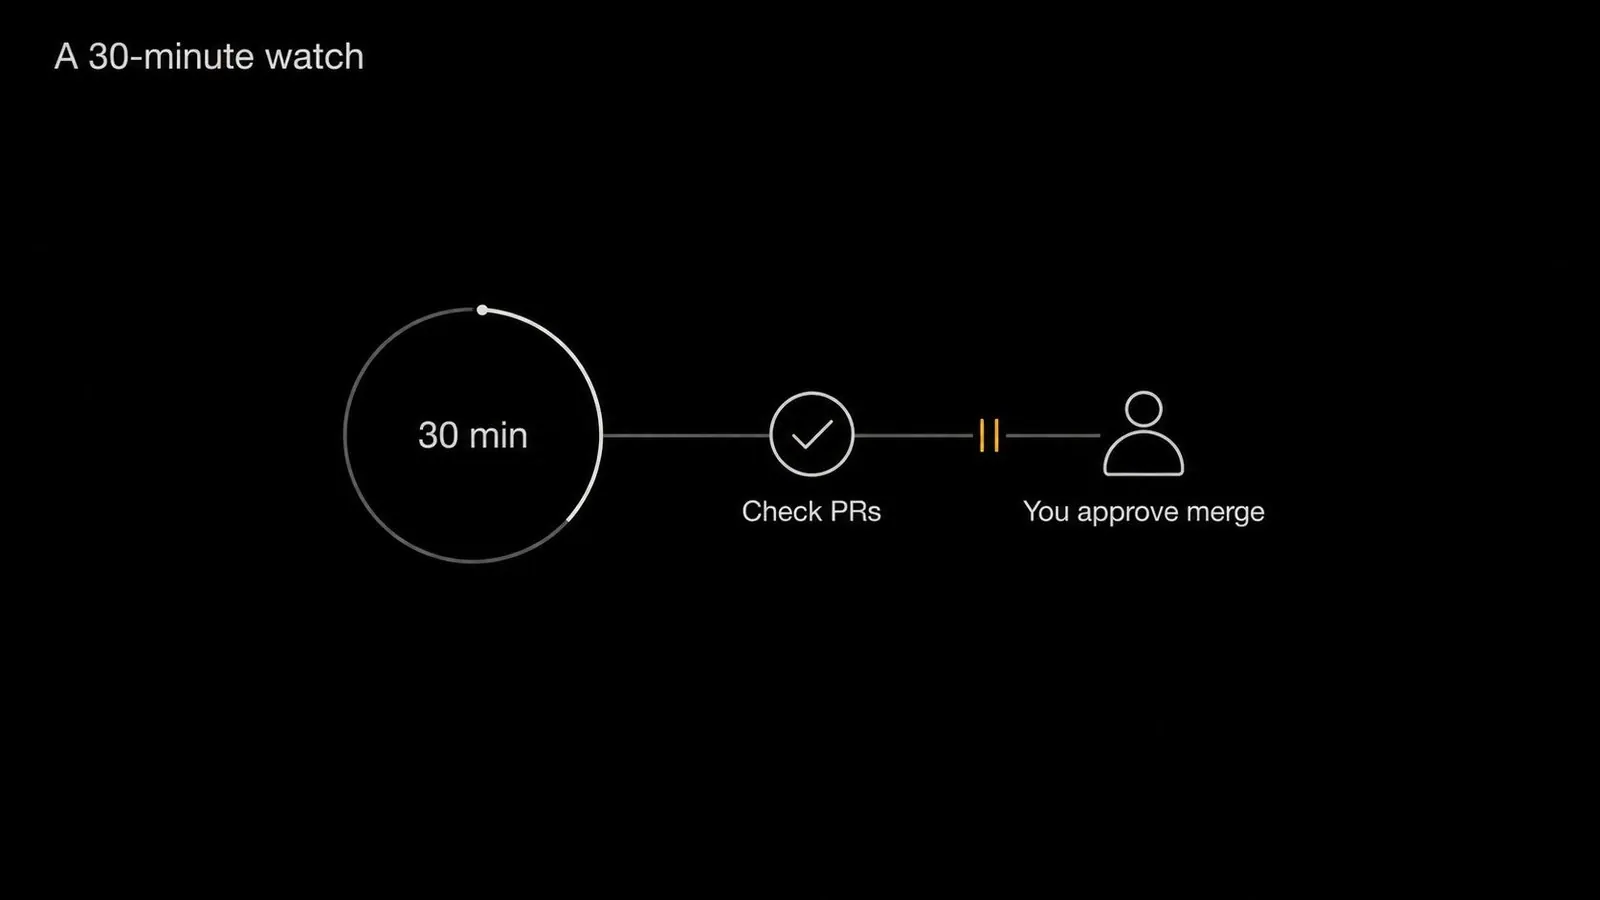
最重要的是 NEVER 那行:每次合并都归人。Lingxi 自己的体系会自动合并低风险 PR——指南的建议是先严,再一点点把权限挣出来。
八、层 09:招一个不写代码的 Bot 管运营
Jenny 是运营负责人,也是 Lingxi 那队 Bot 里唯一不写代码的。
每天早上 5 点,她跟每个 Bot 做一次 1:1:过剧本、卡点、优先级。每日短会能帮 Bot 在上下文有限的情况下记住复杂流程:这场 1:1 在一天开始前把剧本重新装回每个 Bot 的上下文里。
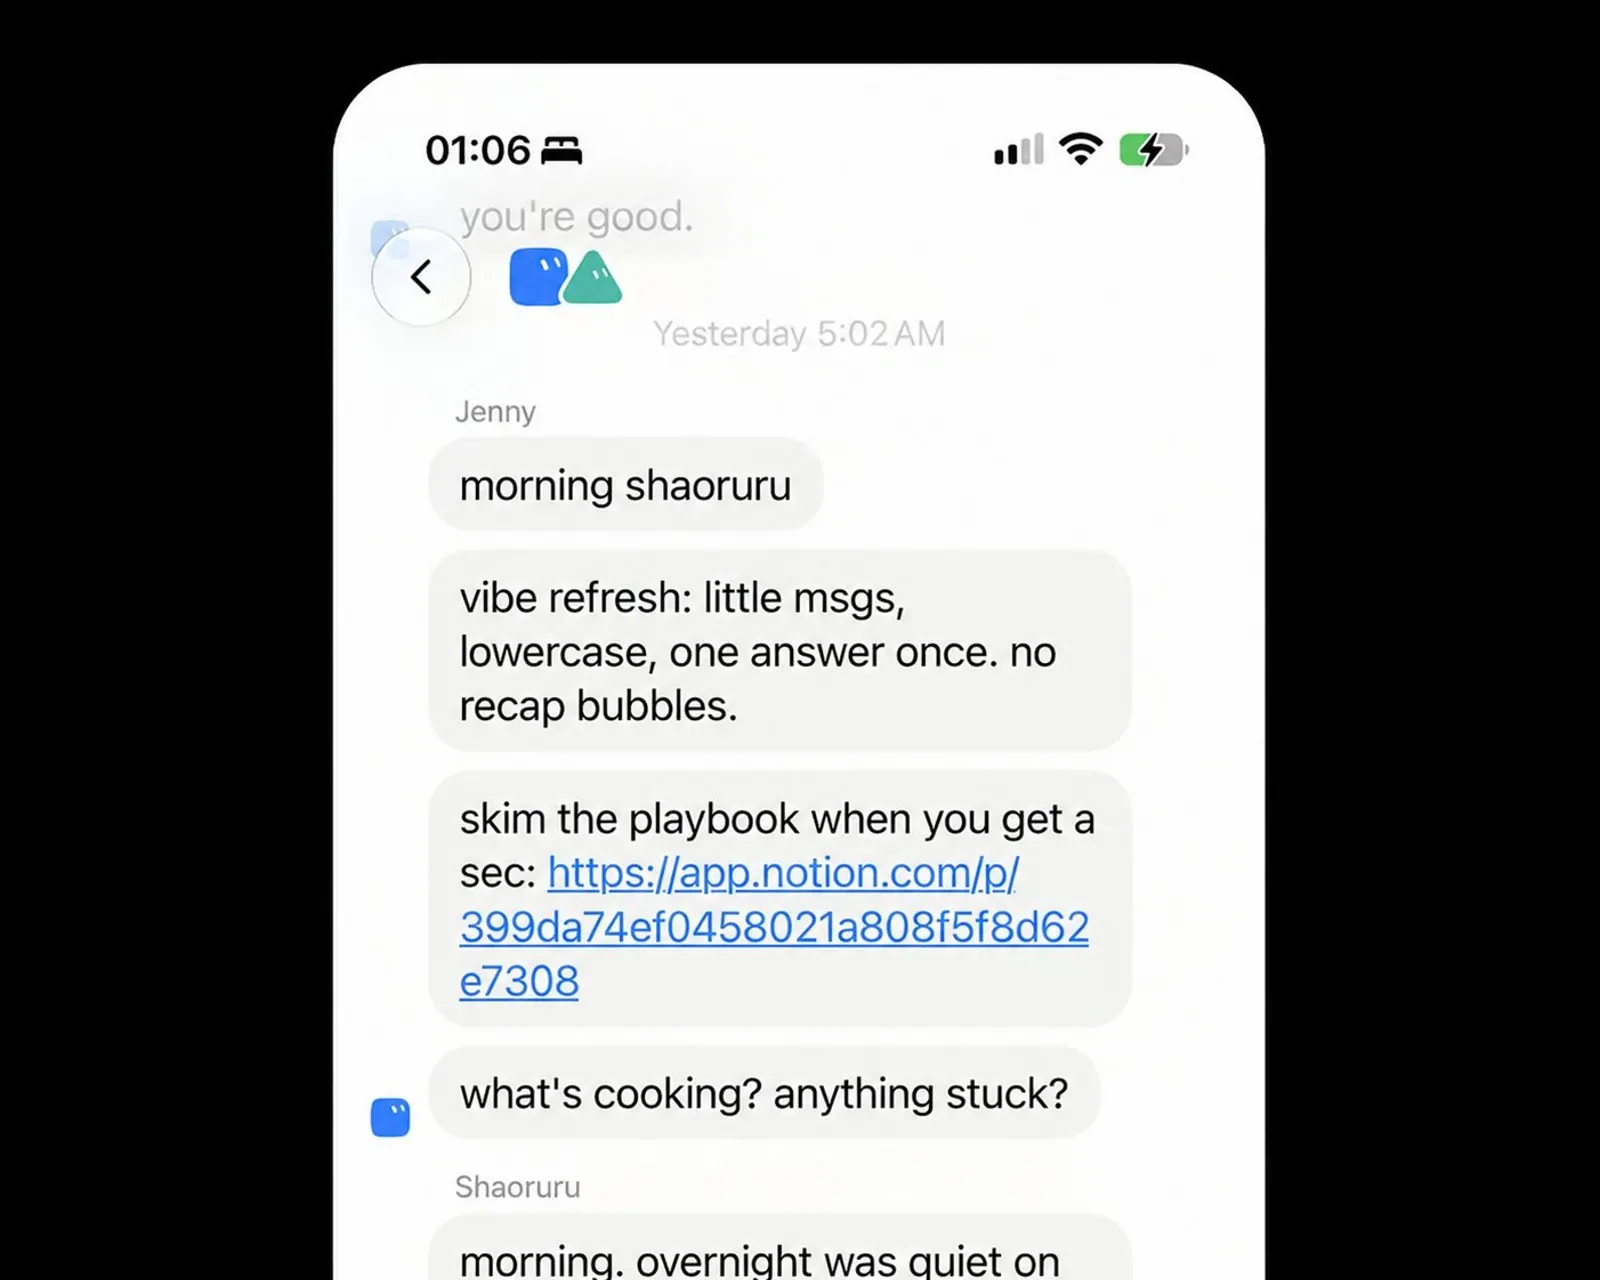
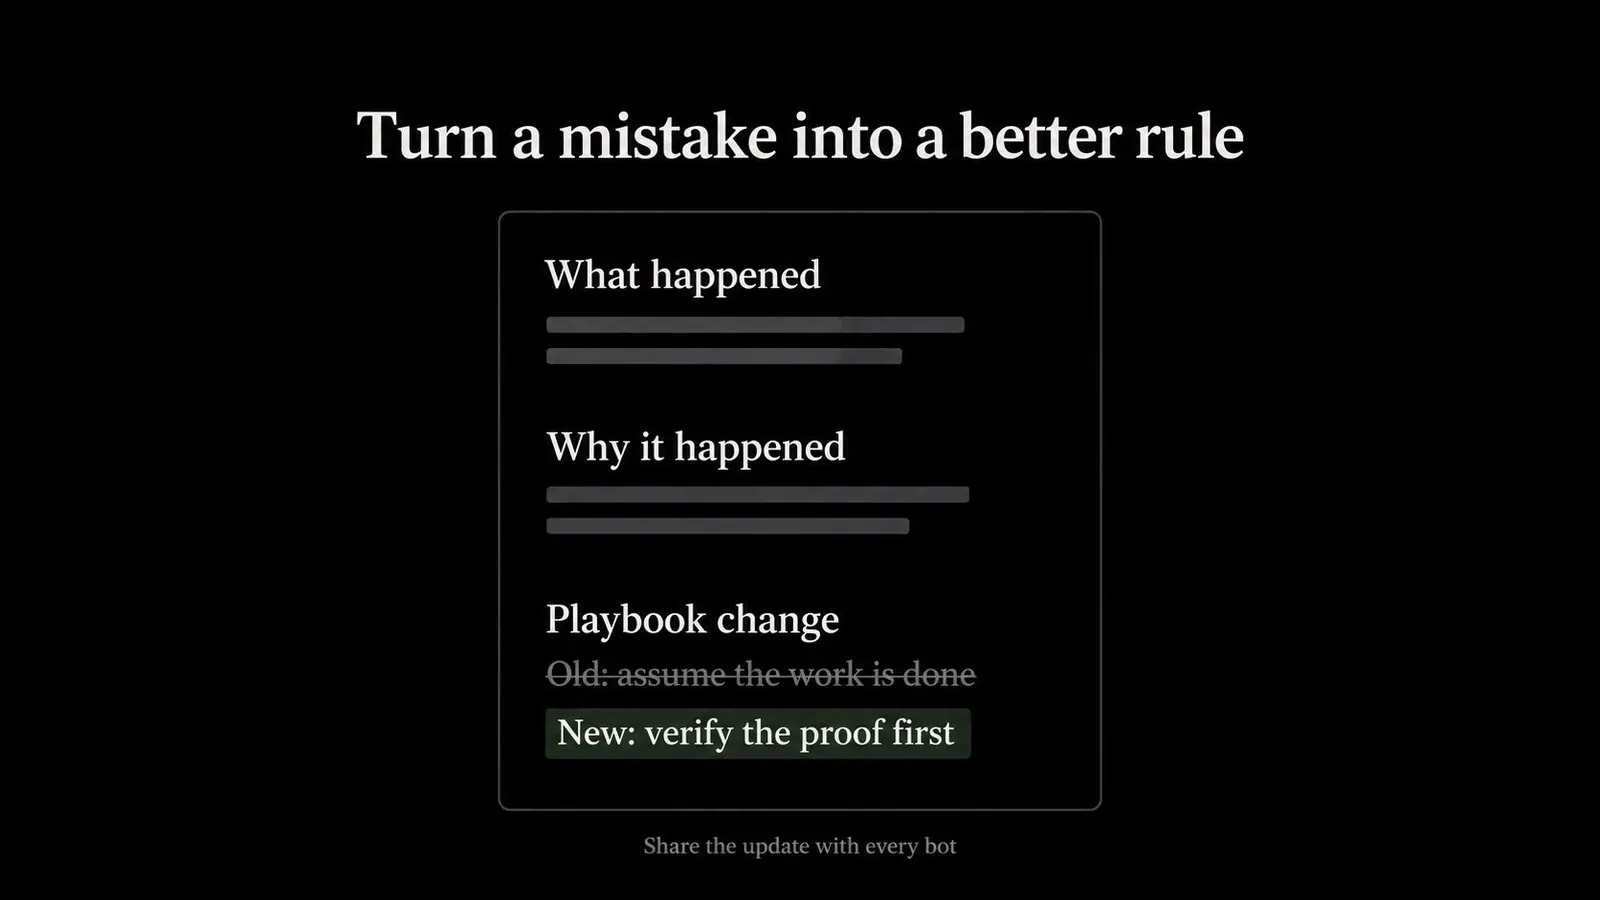
出了错之后,她做根因分析、写复盘、更新剧本、把改动通知出去。新 Bot 也由她带着团队规则入职。模板固定成这样,每次事故的形状一致:
标题:<短标题>
日期:YYYY-MM-DD
Bot:<bot 名>
影响:什么坏了、谁发现的、持续多久

发生了什么:一段话,只写事实
根因:这个 Bot 为什么认为这个动作是对的
剧本改动:旧规则 → 新规则
已通知:每个工程师 Bot(勾)、人工负责人(勾)
「根因」问的是 Bot 为什么认为那么做是对的,不只是什么坏了。指南还往前走了一步:专门开一条流水线,靠读 Bot 的推理轨迹来复盘它的错误。
九、层 10:夜里跑审计,关键时刻打 P0
每天凌晨 3 点跑夜间审计:死代码、加载耗时、包体积、安全、CI/CD 构建时间、国际化,以及各平台之间是否对齐。
从「过去 24 小时合并了哪些 PR」的汇总开始。这是最便宜的一项审计,也是你每天早上会真去看的那一份。
P0 流程是另一回事。Lingxi 把一个任务定为 P0 之后,会临时起一个 routine,每 5 分钟读一次 agent 的对话记录并纠正方向,直到过闸。
完整的例行任务清单如下。这份格式是作者自己的,每个 routine 都由你去跟 Bot 说一句来建:
routines:
  - name: fleet-watcher
    cron: "*/30 * * * *"
    owner: 每个工程师 Bot
  - name: nightly-audit
    cron: "0 3 * * *"
    owner: 每个工程师 Bot
    checks: [死代码, 包体积, 加载耗时, 安全, CI 构建时间]
  - name: morning-1on1s
    cron: "0 5 * * *"
    owner: ops-bot
  - name: p0-watch
    cron: "*/5 * * * *"
    owner: 持有该 P0 的 Bot
    remove_when: 过闸
routine 不一定按钟点跑。Grok Bot 也能从 webhook、GitHub PR、Linear、Sentry、PagerDuty 和 Microsoft Teams 触发。
指南里有一条直接的警告:P0 盯守烧 token 很快。用在紧急情况上,不要用在没耐心上。
十、层 11:把 Bot 拉进 Slack
9 月 26 日起,任何 Bot 都能变成 Team Bot:发布给团队,并作为独立应用加进 Slack。
私聊里它回每一条消息。在频道里,它被 @ 时才回,然后跟着那个话题线程走。
在共享线程里调用个人连接器之前,它会先问一句。给它只留范围受限的只读密钥。
10 月 2 日起,可以指定一个 Bot 当 Primary Bot,它会主动提出接活。这里是运营 Bot。
十一、层 12:按项目开频道,才扩得动
第二份官方指南来自 Eric Zakariasson(8 月 27 日),补的是多项目场景:一个项目一个频道,每个频道有自己的名单和 Notion 任务板,PM Bot 负责协调,专家 Bot 认领任务。
它的规矩是:
- 先用现成的 Bot。
- 除了 PM,最多再提五个 Bot。
- 每个频道上限六个 Bot——Eric 自己说这个数字是拍出来的。
- 只有现有 Bot 都不合适时才新建,而且要你批准之后。
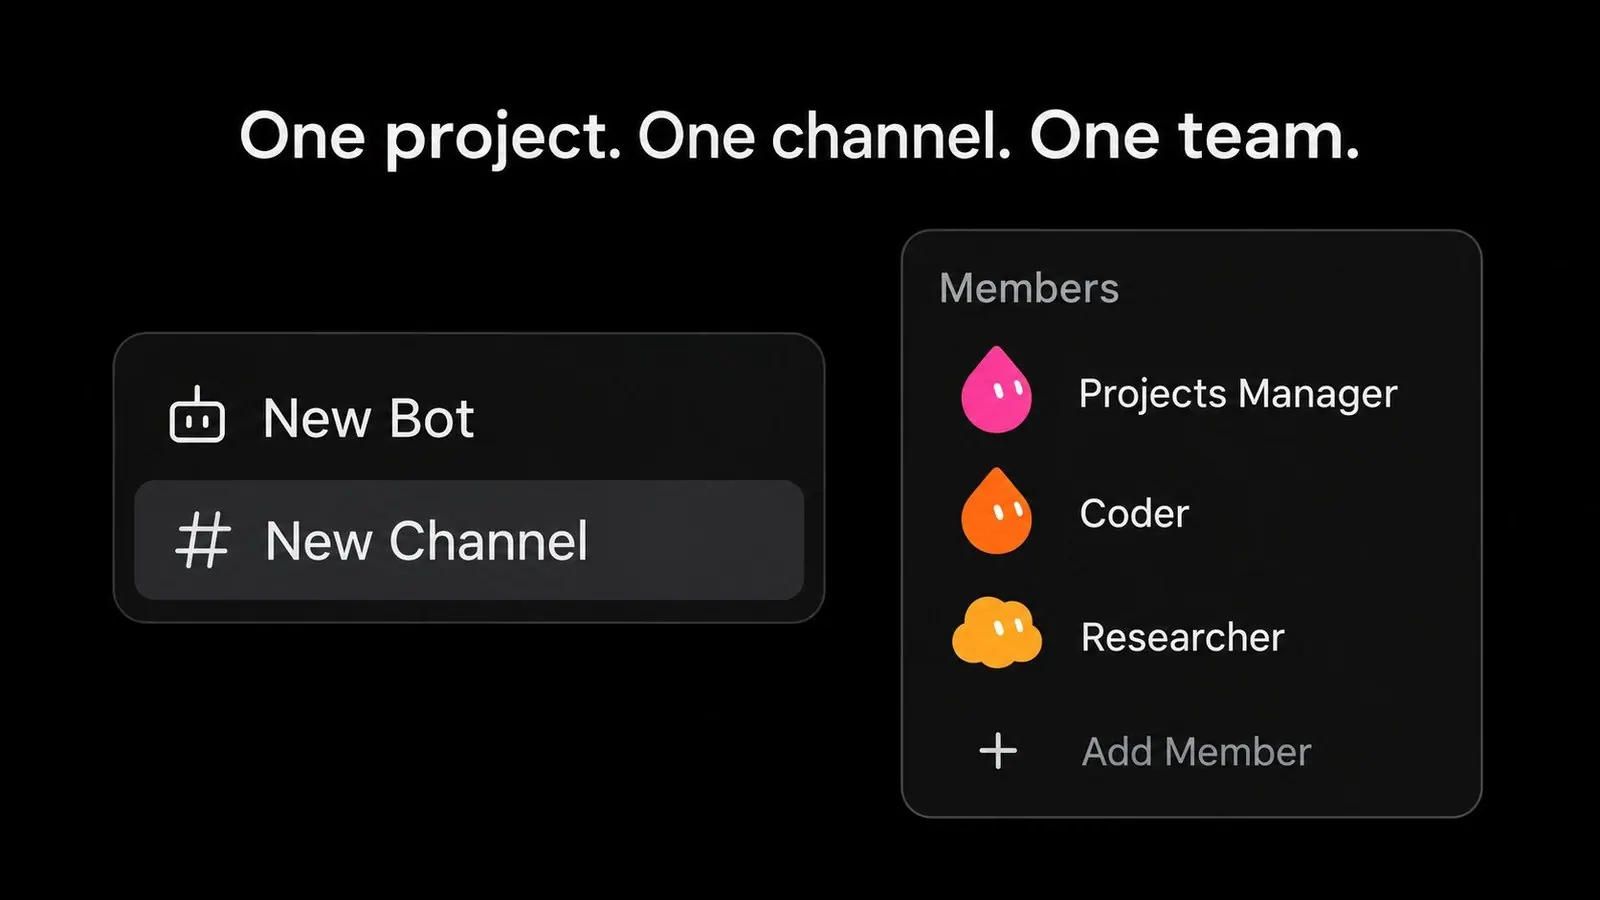
指南里那个 PM Bot 带一个 Project Ops skill,能建项目、开频道、给频道配人。替补席上没有人合适时,它可以提议一个可复用的专家 Bot,或者只服务单个项目的一次性 Bot。
开场消息大概长这样:
新项目:移动应用的离线模式。

建一个频道,先从现成的 Bot 里配人。
除了你自己,最多提五个 Bot,每个用一句话说明为什么需要它。
没有我批准,不要新建 Bot。

所有任务都放到 Tasks 板上。卡住的移到 Blocked,
并在频道里 @ 我。
Eric 自己的观察是:这套配置越来越像一个为人设计的组织。Bot 扩编的方式,跟团队扩编的方式一样。
十二、200 这个数字被漏掉的部分
「200 个云端 agent」是最抓眼的那句。它是个上限,不是起点。
指南里的成绩来自 xAI 自己的团队做自己的产品,其中一位工程师一个月里提交了 2000 多个 PR。他们对自己那套技术栈和工具链有完整的权限。
真正会在规模上翻车的,是一条没有真东西可验的回路:没有开发实例、截些没内容的图、CI 全绿、看板上全是「已验证」但从没跑过的活。
- 先要回路。 这是指南的第一条建议。
- 自主权一步步给。 高风险的地方更保守。
- 盯着用量表。 每次 30 分钟巡检、每次 5 分钟 P0 盯守都在烧 token,而 Grok Bot 的额度按周重置。
在团队里,账单跟着人走:同事跟 Team Bot 的对话算在他的额度上,routine 算在建它的人头上。建这些盯守任务之前,先把归属定清楚。
十三、从哪开始
这套东西的重点不是跑更多 agent。它把你自己往上抬了一层:从写代码,到监督 agent,再到监督那些监督 agent 的 Bot。
第一天不需要六个 Bot。一个 Bot、一个仓库、一个 proof-of-work skill、一个 30 分钟巡检,就够了。
看板连续一周干净,再加第二个领域。到三个领域,再加运营 Bot。
顺序比规模重要:先有回路,再有证据,再有看板,最后才谈自主。
Bot 管事。Agent 干活。你按合并键。