苹果开源 HALO:在 1000 个不存在的家里练出来的 G1 自主系统,实机 360 次跑出 91%
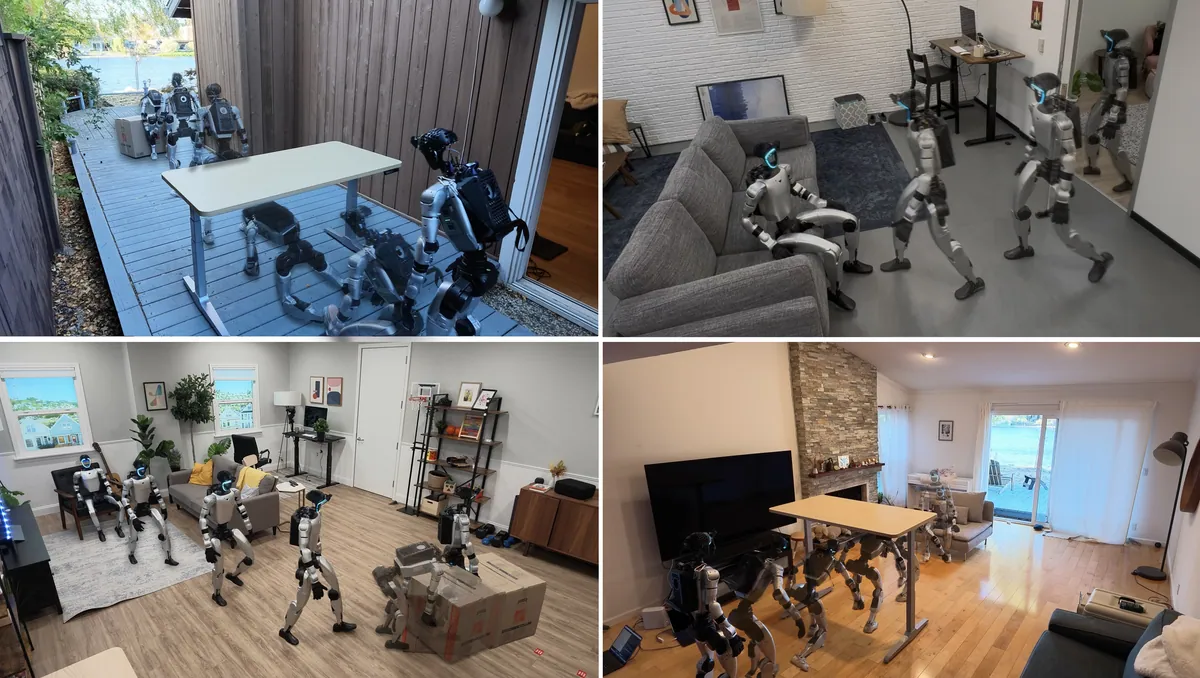
人形机器人会后空翻、会跳舞、会跑步。但你没法把一个后空翻冠军领进陌生的客厅,说一句”坐下”,然后指望它找到椅子、绕开茶几、稳稳坐上去。
后空翻是提前编好的动作,对着一段已知的几何执行;它不需要知道椅子在哪。而”坐下”需要知道两件事:哪把椅子是椅子(语义),以及坐面究竟在多高多远的地方(物理)。前者靠看图理解,后者靠身体感知。现成的数据两件事都不够用:文字和视频遍地都是,但”第一人称画面 + 一句人话 + 精确的全身动作轨迹”这种三元组,得一条一条拍出来。
苹果研究团队的 HALO 换了个思路:这些数据不用拍,全部在仿真里合成。1000 个程序化生成的家、300 小时配对数据,训练出来的策略跑在实机上,在 6 个没扫过、没建过图、训练时也没见过的真实家庭里做了 360 次试验,平均成功率 91%。
| 项目 | 信息 |
|---|---|
| 系统全称 | HALO(Humanoid Autonomy, Learned in simulation, running Onboard) |
| 论文 | Perceptive Humanoid Motion from Simulation,arXiv:2611.06908 |
| 作者 | Siyuan Hu、Abulikemu Abuduweili、Yue Meng、Shipeng Liu、Quentin Leboutet、Chen Chen、Matthias Müller、Vladlen Koltun |
| 单位 | Apple |
| 机器人 | Unitree G1(29 个关节驱动) |
| 机载算力 | 背包里一台 Mac mini M4 Pro(64 GB)+ 机身原厂 Jetson Orin NX |
| 训练数据 | 1000 个程序化生成的家,300 小时第一人称视语动作数据 |
| 实机成绩 | 6 个未建图家庭,360 次试验,成功率 91% |
| 代码 | 已放出:github.com/apple-aiml-research/ml-halo(Apple 自有许可,不含跟踪器预训练权重) |
一、它会哪六件事
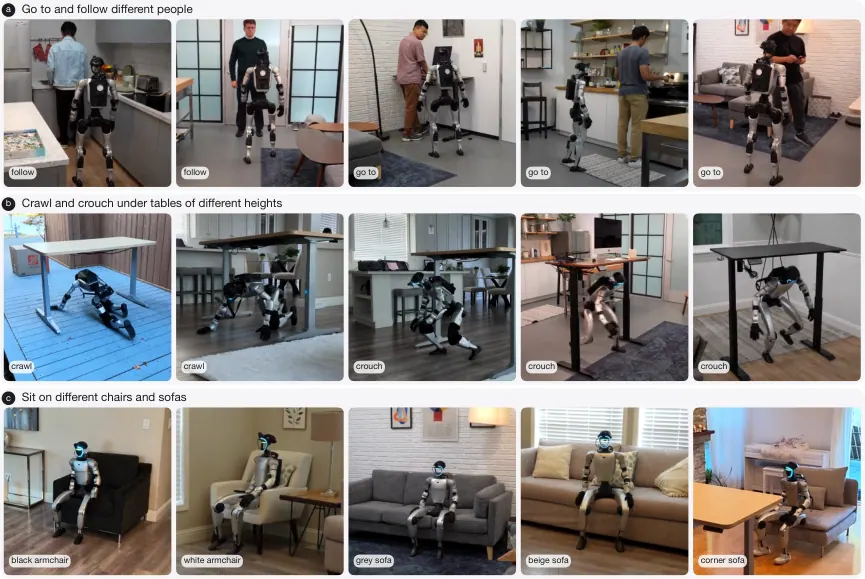
论文选了六个能代表”进家门干活”的技能,全部在 100 个仿真环境和 6 个真实家庭里各跑 10 次:
| 技能 | 内容 | 仿真成功率 | 实机成功率 |
|---|---|---|---|
| Go-To | 走到被点名的物体旁 | 98% | 92% |
| Sit | 坐上椅子 | 84% | 85% |
| Door | 侧身穿过半开的门 | 91% | 93% |
| Crouch | 蹲下钻过低矮障碍 | 95% | 100% |
| Crawl | 爬过桌子底下 | 84% | 90% |
| Push | 把箱子推开 | 93% | 88% |
| 均值 | — | 91% | 91% |
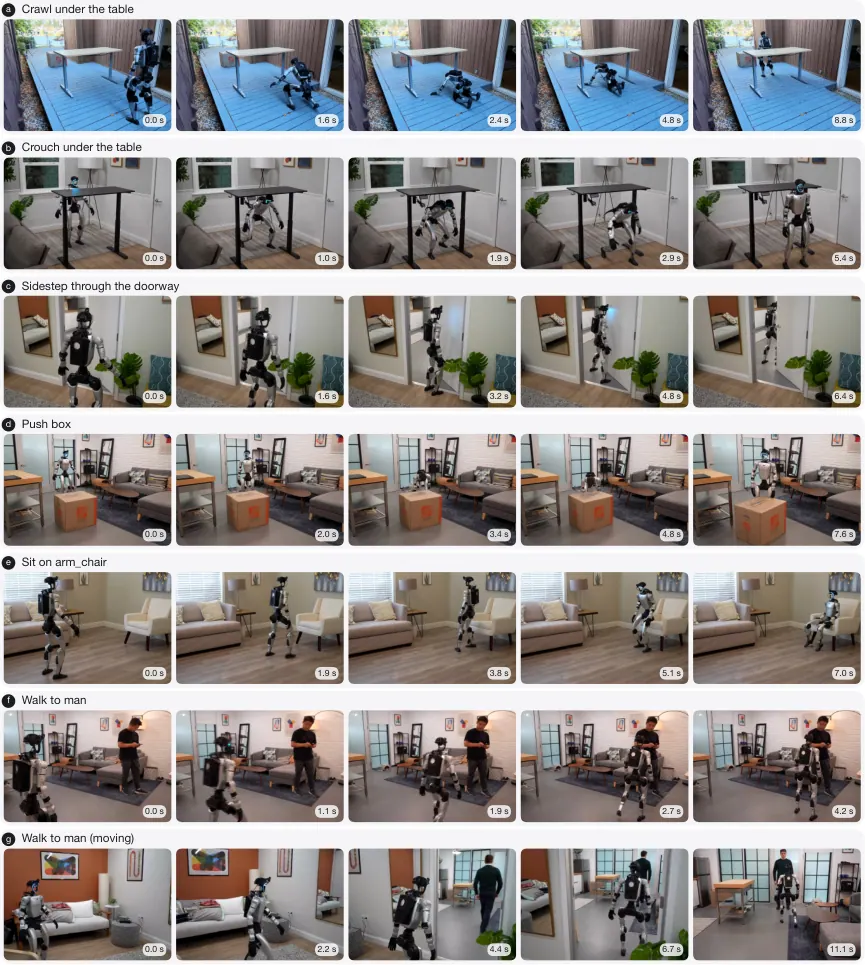
除了单个技能,系统还能接一句开放式指令,自己拆成”先蹲下、再走过去、然后推箱子”这种多步序列。三个多任务序列的平均成功率:仿真 69%,实机 70%。
测试条件是硬约束:这 6 个家庭没被扫描、没被重建,训练时也没见过,机器人能用的只有自己头上那台相机。
二、三层结构:0.5 Hz 决定做什么,3 Hz 决定怎么走,50 Hz 决定怎么落地
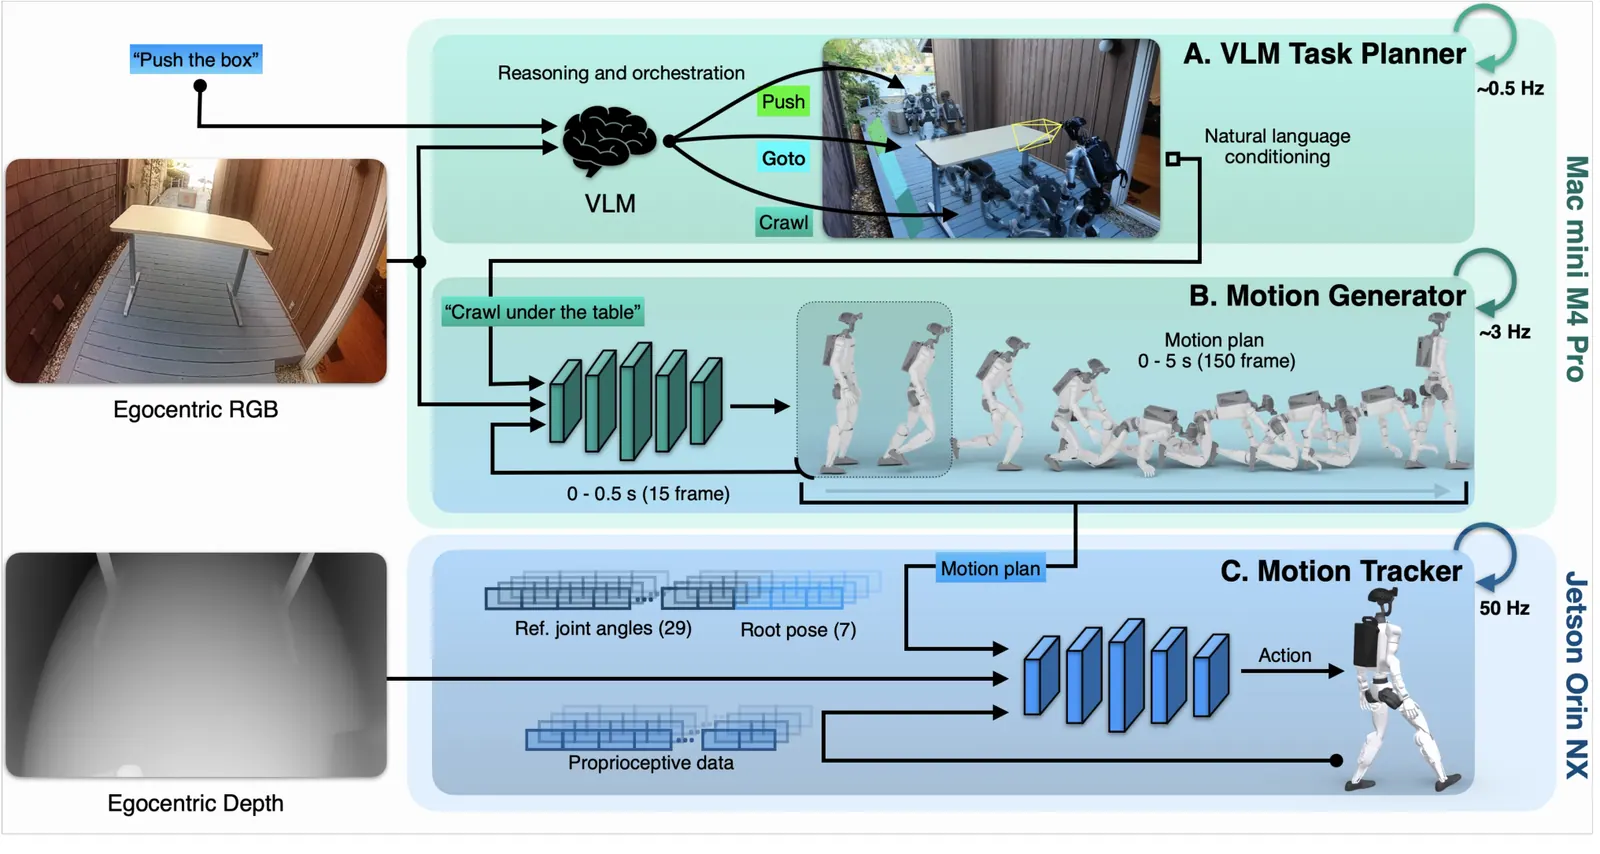
整套系统挂在三个不同的时间尺度上:
| 层 | 频率 | 输入 | 输出 | 跑在哪 |
|---|---|---|---|---|
| 编排器(VLM) | 约 0.5 Hz(每 2 秒一次) | 第一人称 RGB + 操作者的自由语言 | 一串子任务(技能 + 目标物体) | Mac mini |
| 动作生成器 | 约 3 Hz | 当前子任务 + 第一人称 RGB | 5 秒全身运动计划 | Mac mini |
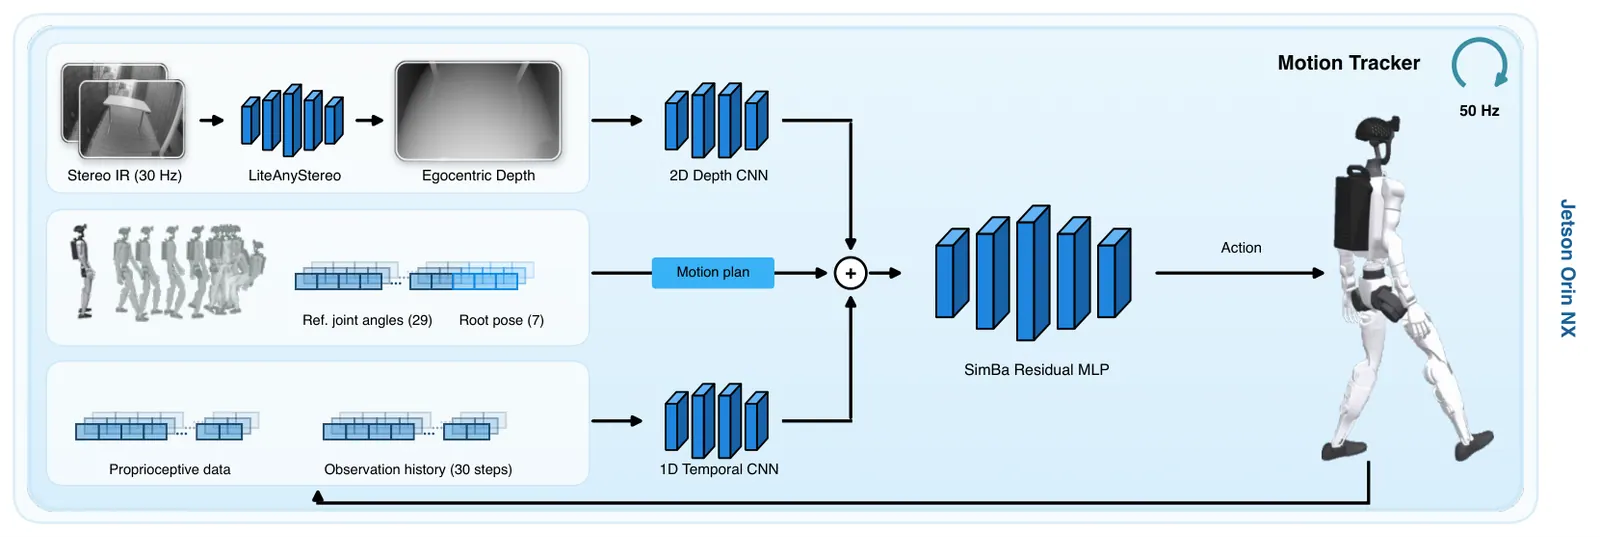
| 动作跟踪器 | 50 Hz | 运动计划 + 深度 + 本体感知 + IMU | 29 个关节的位置目标 | Jetson Orin NX |
运动计划长这样:5 秒、30 Hz、150 帧,每帧 36 个数——29 个关节角,加上相对骨盆的 3 维平移和 4 元数旋转。用相对量表达,输出就跟机器人在房间里的绝对位置无关。
编排器用的是 Qwen3.6-35B-A3B 的 4 bit MLX 版本,跑在 Mac mini 上,跟生成器共用一个推理引擎,断网也能工作;想要更强的规划能力,也可以把请求转到云端模型。它手里有 11 个子任务可选:去椅子、去箱子、去人身边、跟人走、坐下、蹲到桌下、从书桌下爬过、侧身挤过窄缝、推箱、站立、保持姿势。后两个不经过生成器,直接给跟踪器一段站立或保持的参考。
论文里有个细节挺有意思:三层的延迟是被认真量化过的,不是”能跑就行”。
| 环节 | 延迟 |
|---|---|
| 生成器单独推理 | 约 152 ms |
| 生成器与编排器切换共服务 | 约 155 ms |
| 编排器单次切换决策 | 约 0.72 s |
| 编排器与生成器共服务 | 约 1.46 s |
Mac mini 的 GPU 由同一个调度器串行分配:运动计划的优先级更高,有 333 ms 的硬截止时间,可以打断编排器的推理(在模型层与层之间暂停);但编排器至少保留 60% 的 GPU 时间,保证它不被饿死。
论文对这套结构的说法是:此前的系统没有把感知型底层控制器与“完全跑在机载硬件上生成”的全身运动计划配在一起。这句话是否成立另说,但至少它把“语义—运动—物理”三件事的频率和责任分得很清楚。
三、数据不用人拍:1000 个不存在的家
这是整篇论文里最有价值的部分。人形机器人数据贵,原因很直接:遥控操作或者穿戴动捕设备采集,产出一小时数据至少要花一小时人力。HALO 的做法是把这一小时换成显卡。
论文里把已有的几条路线排了队:
| 路线 | 代表 | 卡在哪 |
|---|---|---|
| 遥控操作 / 穿戴动捕 | ALOHA、TWIST、UMI | 一小时数据至少一小时人力 |
| 先重建再训练 | VLK | 训练和评测都困在事先扫过的房间里 |
| 程序化生成但范围窄 | GRAIL、FetchMan | GRAIL 只变地形,物体交互限于手工模板;FetchMan 生成了 15 万个场景,只为单一的伸手抓取任务 |
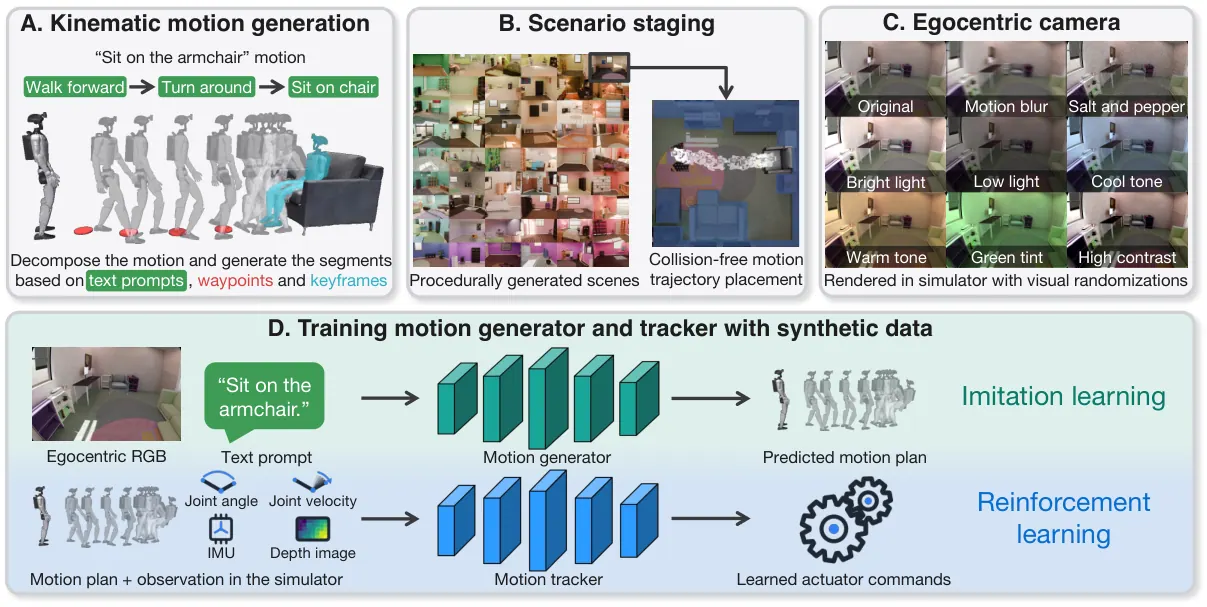
四步走完一集训练数据:
第一步,生成动作。 每个任务拆成若干动作段,每段由一句文本提示、可选的路点、以及一个终点关键帧定义。比如”坐上这把扶手椅”拆成”往前走 → 转身 → 坐下”,前一段的路点把机器人带到椅子正前方,最后一段强制一个锚定在椅子上的人形关键帧。这套拆解每个任务只写一次,复用到全部 1000 个环境里。
真正生成动作的是 Kimodo,一个运动学层面的扩散模型。它只懂运动学,输出可能脚打滑、陷进地板、或者整个人跳一下。所以每一段要采样 N 个候选,用前向运动学做 33 项几何检查(脚滑、穿地、腾空相、关节限位),留下分数最高的那个。
第二步,把动作塞进房间。 环境由 Infinigen 程序化生成,1000 个房间分三类:客厅、办公室、卧室,尺寸和家具各不相同。系统先从布局里抽出 2D 占据栅格,再采样 SE(2) 位姿,取第一个”轨迹、目标物体、周围家具都不碰撞”的配置。每一集由种子加一条轻量放置记录唯一确定,动作生成和渲染因此解耦——想换分辨率、换相机内参、甚至换物理引擎重渲染,都不用重新生成动作。
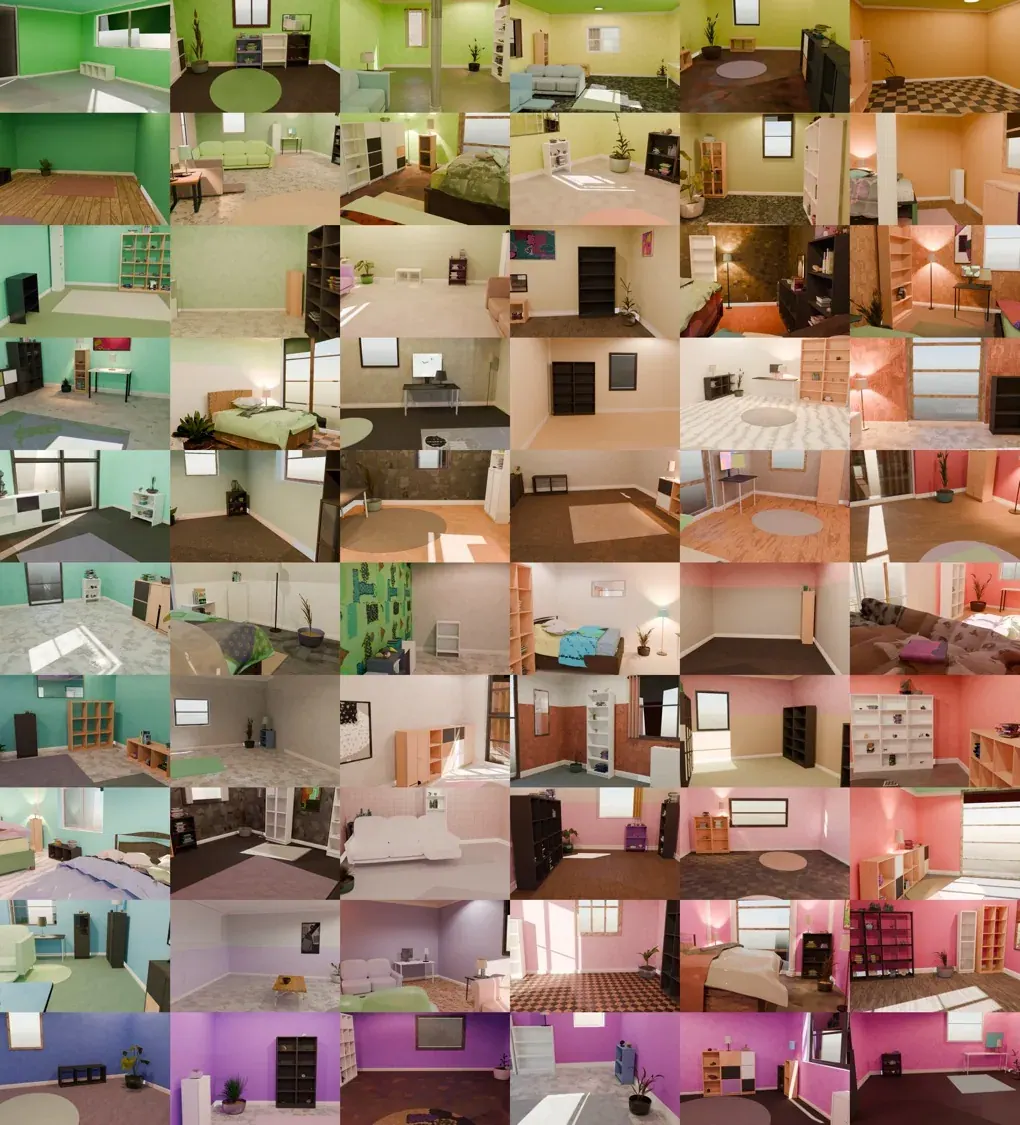
第三步,渲染第一人称画面。 相机按硬件建模成鱼眼,画面对齐 OAK-1W 的实际视场。为了缩小视觉 sim2real 差距,做了大量域随机化:色温、曝光、对比度、运动模糊、传感器噪声。原生路径追踪在这个量级上算不起,于是把全局光照和着色烘焙进每个物体的自发光贴图,一次性预处理后任何标准光栅化器都能实时渲染,整条流水线因此不绑定某个模拟器。
第四步,训练。 生成的数据集交给模仿学习(动作生成器)和强化学习(动作跟踪器)。
算力账单也公开了:合成这 300 小时数据,250 张 H100 跑 48 小时,全程无人干预;生成器在 64 张 B200 上训练,跟踪器用 4 张 H100。想做复现的同学先看一眼这三个数字。
四、机器人眼睛里的世界
生成器唯一能看到的就是这张图:头顶鱼眼相机拍到的第一人称画面。深度则只给跟踪器用。
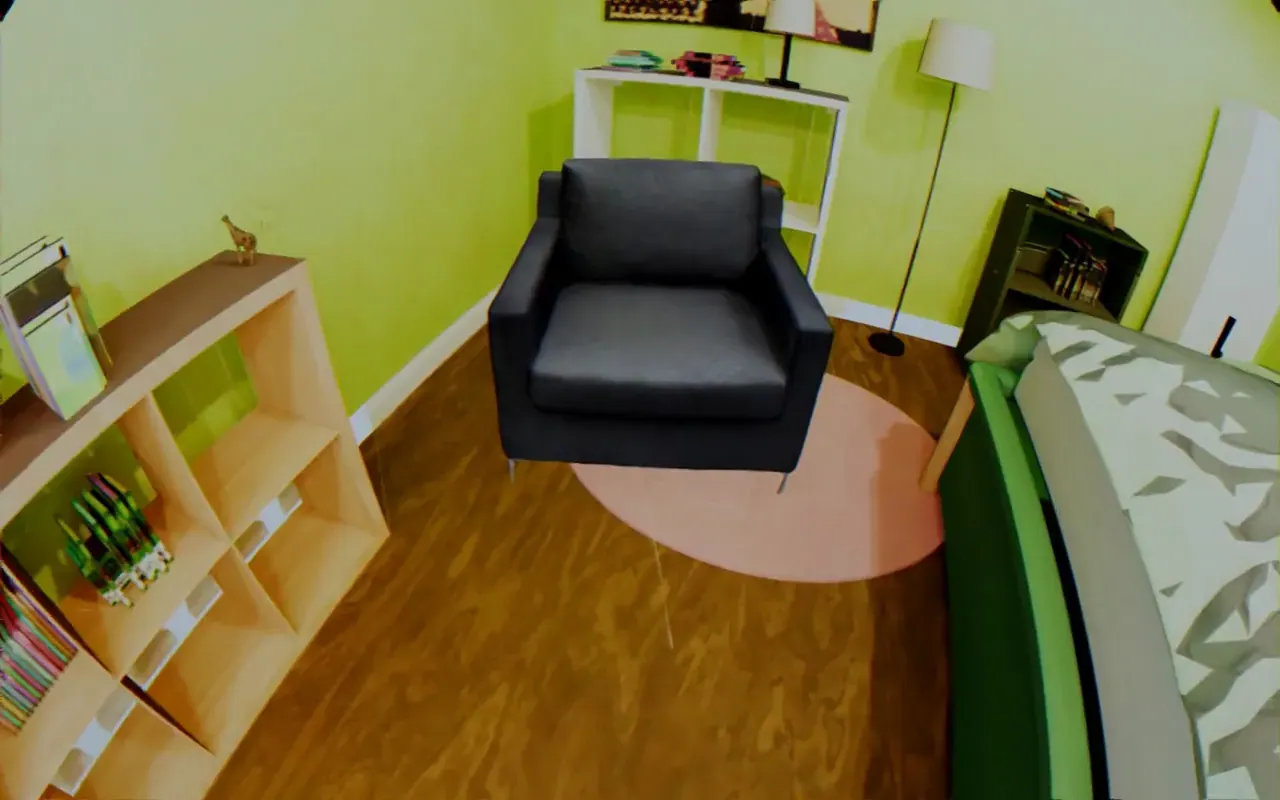
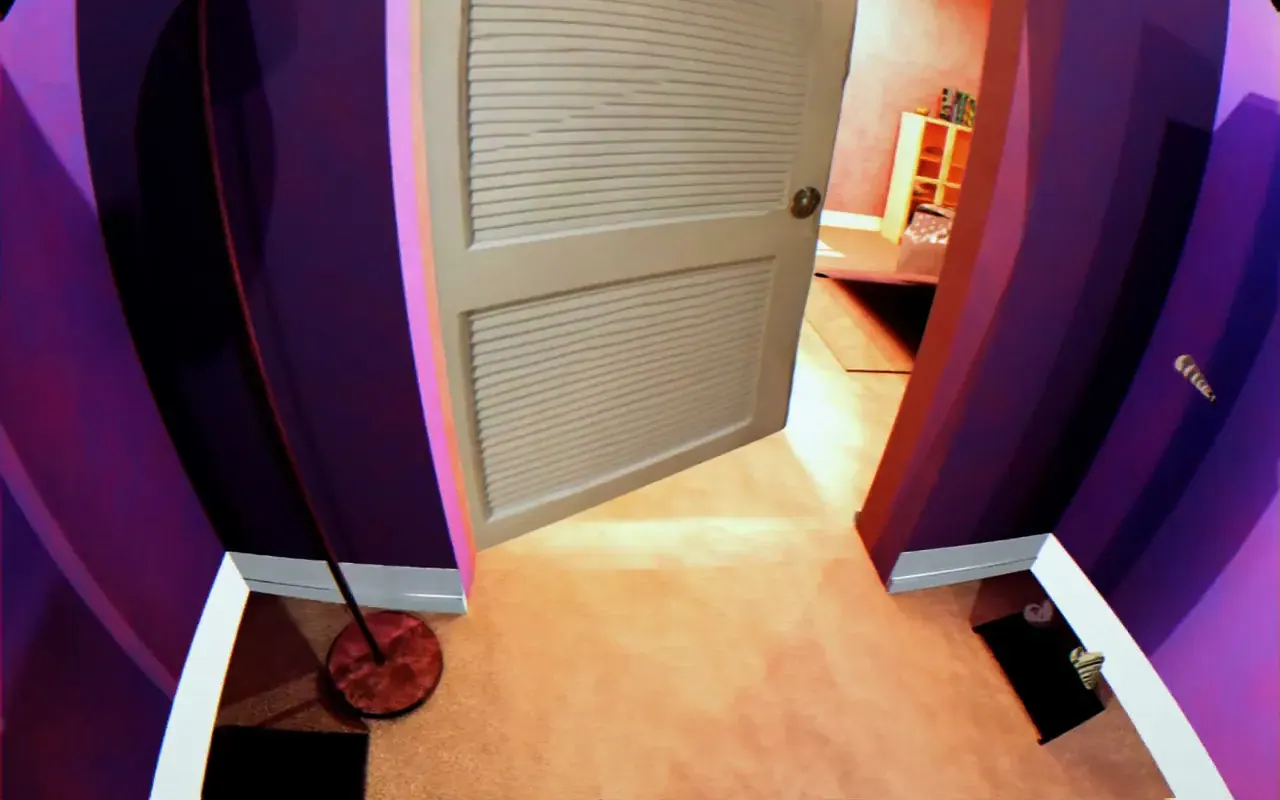
论文里的分工很清楚:生成器解决”哪把椅子”(语义),跟踪器解决”坐面到底在哪、重心怎么倒过去”(物理)。跟踪器拿不到物体坐标,也拿不到地形高度图,只能从深度图里自己推断几何——消融实验里把深度去掉、只剩本体感知,成功率从 84% 掉到 74%,说明这条深度通道不是装饰。
五、模型怎么训
动作生成器是个不对称编解码器。 编码器是冻结的 Qwen3.5-2B 视觉语言模型,把第一人称图和语言指令压成一个联合特征。冻结的理由写在论文里:预训练 VLM 本身就有很强的图文语义对齐,一个前向就够,20 亿参数连优化器状态都不用存。解码器是 8 个 block、宽度 512、8 个头的扩散 Transformer,从零训练,用 flow matching,推理走 15 步 Euler。
异步生成是这套系统的关键工程。 如果按同步方式跑,生成器推理的那几百毫秒里机器人没有控制信号,只能保持上一个姿势——动作会碎成一段一段,而且在动态动作里根本不安全。所以生成新计划的同时,跟踪器还在执行旧计划。难点在切换点:新轨迹必须接上机器人第 T+d 帧真正会到的状态。
常见做法是推理时的 real-time chunking(RTC),用重叠帧做修补目标,但连续性没有数学保证,每步去噪还要多算一次梯度。HALO 换成训练时条件:把机器人已经承诺执行的 15 帧(0.5 秒)当作干净 token 直接喂进去,模型只去噪剩下的 135 帧(4.5 秒)。连续性变成网络的固有属性,而不是推理时的补丁。消融数据对得很干脆——训练时条件 84%,推理时 RTC 66%,完全不用只有 24%。
跟踪器分三阶段训练。 第一阶段给每个技能单独训一个 PPO 专家,专家能看特权信息:本体感知、未来 10 帧计划、以及真值高度图,输出 50 Hz 的关节位置目标交给底层 PD 控制器。涉及操作的技能还要额外加奖励——手离物体近、物体真的被推动了。论文里那句话说得挺实在:摆出一个完美的姿势但物体纹丝不动,纯运动学奖励是发现不了的。
第二阶段把这些专家蒸馏成一个只吃机载输入的单一学生模型:运动计划、深度、本体感知、IMU。蒸馏时每个仿真实例由对应专家监督,学生不会把不同专家的冲突动作平均掉。做法是行为克隆加 DAgger 的混合。
第三阶段直接在学生身上做强化学习,用多 critic PPO——共享 actor,每个技能一个独立 critic,各自归一化优势,避免高量级回报把策略梯度带偏。
sim2real 靠建模,不只靠随机化。 按电机转子惯量解析推导各关节 PD 增益,保证全部关节的固有频率和阻尼比一致,动作按扭矩上限缩放;随机 15–40 ms 指令延迟;深蹲时直接惩罚膝盖的负机械功率,防止策略依赖仿真里被静默裁剪、真机根本给不出的扭矩。
附录里还有一段系统辨识的结果,做真机的会关心:原厂仿真模型漏掉了内部电池、低估了髋部转子惯量、把 PD 驱动当成理想无延迟,实测电机只给出指令刚度的 78–90%,端到端回路延迟 25–30 ms,踝和腰的并联连杆惯性与摩擦都比串联关节大。用开环轨迹拟合这些参数后,留出动作上的关节跟踪误差从 26.9% 降到 10.1%,行走时短时预测误差降了约三分之一。参数准了,第三阶段的域随机化才能收在真实动力学附近的窄区间,而不是撒一大把宽范围把策略训得畏手畏脚。
地面也单列了一条:只在刚性地面训出来的策略换到硬质地面(木地板、瓷砖、水泥)能扛住,遇到厚地毯就不行——脚陷进去 1–2 cm,被当成倾斜扰动,机器人会不停挪脚或者原地转身时踢到脚尖。反过来不做低摩擦随机化,在打滑的木地板和亮面复合地板上减速、转弯时会滑。把摩擦和地面接触的刚度、阻尼一起随机化,再加第三阶段的支撑脚打滑惩罚,两个场景才都能站稳。
六、硬件:给 G1 背一台 Mac mini
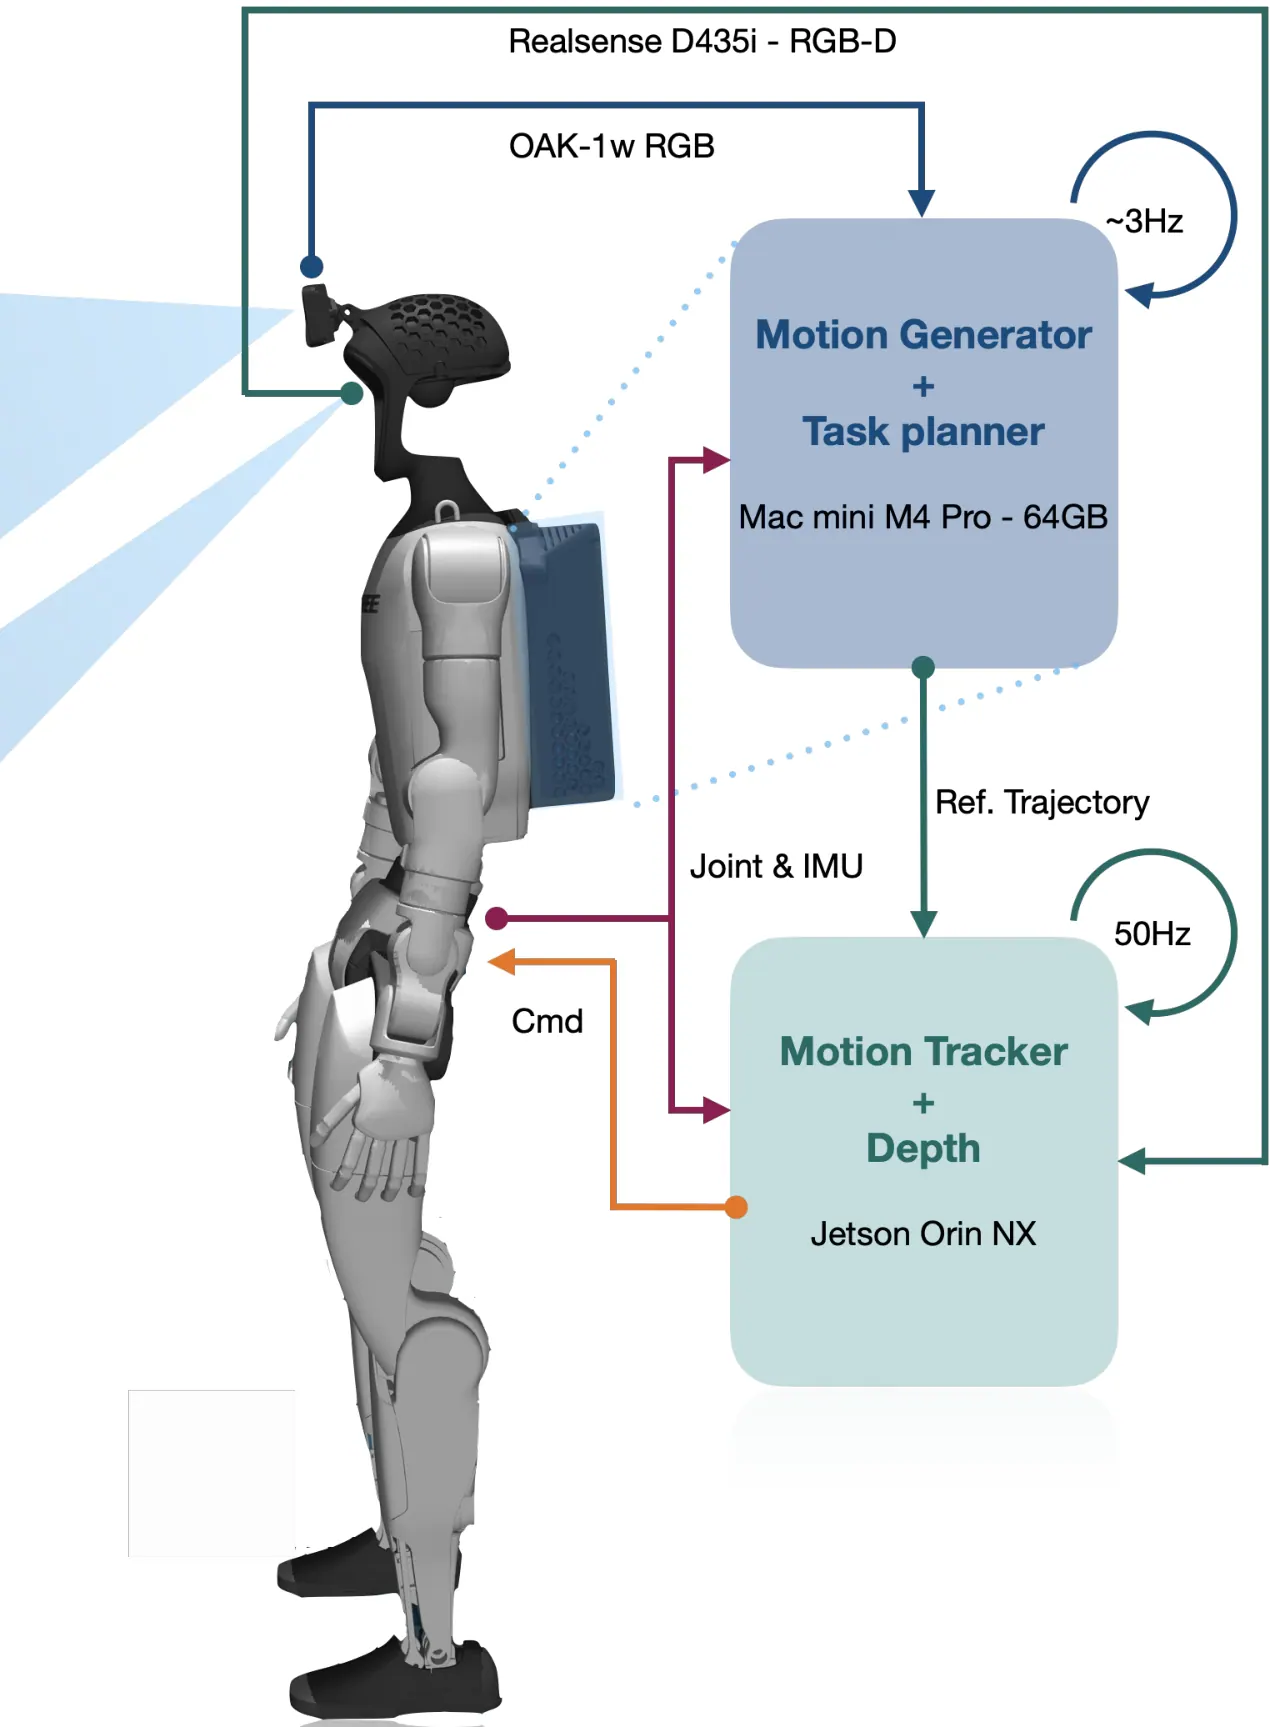
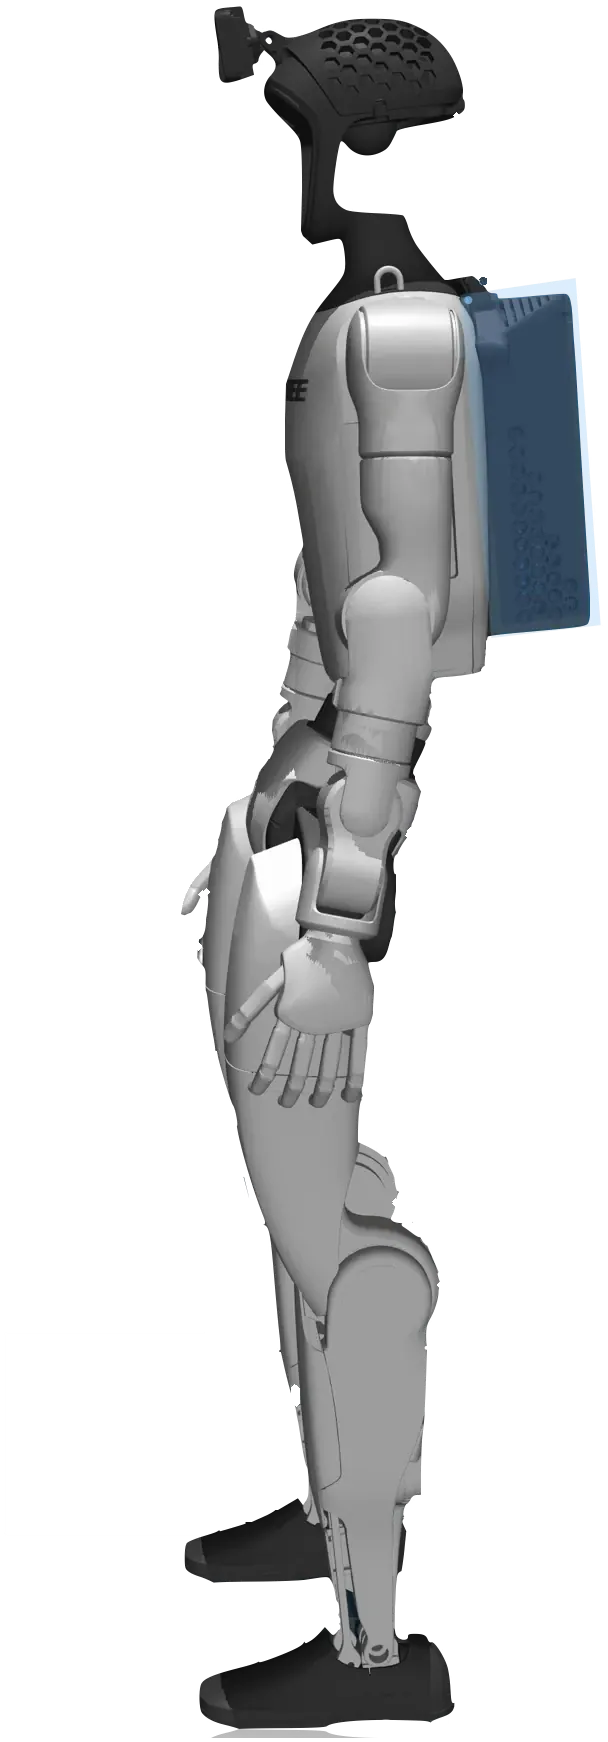
平台是 Unitree G1,两处物理改装:头顶加一个刚性支架装 OAK-1W 广角相机,背后加一个保护壳装 Mac mini M4 Pro(64 GB 统一内存)。电从机器人内部电池总线取,通过千兆以太网连原厂 Jetson Orin NX。双算力单元把”重规划”和”时间敏感的电机控制”隔开,形成一条 ZeroMQ 上的双速率异步级联。
| 部件 | 参数 | 用途 |
|---|---|---|
| OAK-1W | 120° 视场,1280×800,30 fps | 给编排器和生成器看的 RGB |
| Intel RealSense D435i | 55° 俯视,424×240,30 fps | 给跟踪器的近场深度 |
| Mac mini M4 Pro | 64 GB 统一内存 | 编排器 + 运动生成器 |
| Jetson Orin NX | 原厂随机身 | 跟踪器,C++ 实时进程 |
两处工程细节值得抄:
- 深度不信任原厂输出。 D435i 自带的深度处理有遮挡阴影和散斑噪声,团队干脆关掉主动红外投影,把原始双目 IR 直接送进 TensorRT 加速的 LiteAnyStereo 模型,在 Orin NX 上以 30 Hz 拿到干净深度,方便真实传感器跟仿真里的深度对齐。
- 控制环按实时系统做。 跟踪器是 PREEMPT_RT 内核上的 C++ 进程,与硬件接口之间用无锁三缓冲通信,控制环永不阻塞。
七、91% 是怎么算出来的,以及剩下 9% 栽在哪
评测口径:单任务在 100 个仿真环境 + 6 个真实家庭,每个环境每个任务跑 10 次,合计 6000 次仿真试验和 360 次实机试验。成功要求是不摔倒、不卡住、完成该任务;多任务要求每个子任务按顺序全部完成。
| 序列 | 仿真 | 实机 |
|---|---|---|
| Door → Go-To | 71% | 100% |
| Crouch → Sit | 73% | 60% |
| Crouch → Go-To → Push | 64% | 50% |
| 均值 | 69% | 70% |
多任务成功率低于单任务连乘(Door→Go-To 是 71%,而单任务连乘应该是 89%),说明子任务之间不独立。论文把原因追到了”上一个动作结束时机器人的姿态”:真实环境的 Crouch→Go-To→Push 里,5 次失败有 3 次蹲完头是背对箱子的,箱子压根没进视野,机器人被别的物体带跑了;Crouch→Sit 有两次蹲完想去坐右边的沙发而不是椅子。仿真里 Door→Go-To 同一个毛病——过门本身 85% 成功,但出门朝向随门的位置变化,目标物体可能直接离开视野,条件成功率降到 83%,整体 71%。
这些失败共用一个原因:下一个子任务开始时目标没被看到。论文建议的补法很朴素:加搜索、原地转身这类恢复行为。
八、消融:哪些设计真的在起作用
| 变量 | 配置 | Sit 成功率 | 相对变化 |
|---|---|---|---|
| 训练场景数 | 1000(HALO 设置) | 84% | — |
| 100 | 81% | −3 | |
| 10 | 64% | −20 | |
| 1 | 43% | −41 | |
| 生成衔接 | 训练时条件(HALO 设置) | 84% | — |
| 推理时 RTC | 66% | −18 | |
| 不用 | 24% | −60 | |
| 生成器解码器 | flow matching(HALO 设置) | 84% | — |
| 回归 | 19% | −65 | |
| 跟踪器输入 | 含深度(HALO 设置) | 84% | — |
| 不含深度 | 74% | −10 |
环境数量从 1 涨到 100,成功率从 43% 跳到 81%;再从 100 加到 1000,只多 3 个点。这条曲线说明”多样性”有个饱和点,前 100 个房间买到的是绝大部分收益。
回归解码器掉到 19% 这一点也挺有信息量:它没有扩散过程,异步生成时无衔接可用,而且容易过拟合——出了训练分布,计划只剩粗糙的根轨迹,关节细节全丢,脚开始打滑。
九、想把代码跑起来,先看这几件事
仓库按模块拆得很清楚:
| 目录 | 内容 |
|---|---|
datagen/ | 合成数据流水线:Infinigen 场景、Kimodo 动作、Isaac / MuJoCo 渲染 |
generator/ | 运动生成器,训练与开环评测 |
tracker/ | G1 动作跟踪策略,Isaac Lab 训练 + Python / C++ 实时部署 |
orchestrator/ | halo_orchestrator,语言请求 + 第一人称图 → 子任务计划 |
system/ | 闭环系统:run_sim.py / run_real.py、各节点、实时 web 查看器、通信与推理调度 |
assets/ | G1 的 MJCF / URDF / USD 描述、场景物体与场景 |
git clone https://github.com/apple-aiml-research/ml-halo.git
cd ml-halo
四个提醒,避免白折腾:
- 仓库不带跟踪器权重。 README 写明 tracker 权重不随仓库发布,本体感知和深度的学生模型要用
tracker/training自己训。想直接拿来做 demo 的,先得接受重跑训练这一步。 - 数据合成的成本不低。 论文口径是 250 张 H100 跑 48 小时出 300 小时数据,生成器 64 张 B200,跟踪器 4 张 H100。个人设备只能跑缩小规模。
- 许可证不是 OSI 意义上的开源。 仓库用的是 Apple 自家的示例代码许可(Apple Sample Code License):允许使用、修改、再分发,整包再分发时必须保留声明,也不得用 Apple 的名称或商标替衍生产品背书。按 OSI 的判定标准这不算开源许可,写”源码公开”更准确。
- 硬件门槛在”双算力 + 双相机”。 光有 G1 不够,还得有背包算力、头顶广角相机、以及能在 PREEMPT_RT 上跑实时控制环的工程能力。
十、论文自己承认的局限
- 数据自动化只到数据为止。 增加一个新任务,仍然要人来写提示词、标关键帧。技能库的增长速度取决于人能写多快。
- 纯视觉,没有触觉。 物体一离开视野或被遮挡,策略就失去了”它还在那”的信号,接触密集的任务因此变差。
- 生成器和跟踪器之间的接口太窄。 跟踪器只是跟随运动学计划,不知道这个计划是为了什么。把”意图中的未来世界状态”传下去,是作者列出的下一步。
- 编排层比较简单。 任务库再大,就需要更 agentic 的调度系统。
- 另外我自己的观察:多次试验里”头转开了就找不到目标”这种失败,本质是缺一个最基础的搜索行为。加个原地转身扫描,可能比换更大的 VLM 更划算。
相关链接
- 官方项目页(含演示视频与全部实拍片段): https://apple-aiml-research.github.io/ml-halo/
- 开源仓库: https://github.com/apple-aiml-research/ml-halo
- 论文(arXiv:2611.06908): https://arxiv.org/abs/2611.06908
- 论文 PDF: https://arxiv.org/pdf/2611.06908
引用格式(BibTeX):
@article{halo2026,
  title   = {Perceptive Humanoid Motion from Simulation},
  author  = {Hu, Siyuan and Abuduweili, Abulikemu and Meng, Yue and Liu, Shipeng and
             Leboutet, Quentin and Chen, Chen and M{\"u}ller, Matthias and Koltun, Vladlen},
  journal = {arXiv preprint arXiv:2611.06908},
  url     = {https://arxiv.org/abs/2611.06908},
  year    = {2026}
}