Jev + Harness 工程:造一个你看得见、也控得住的 Agent
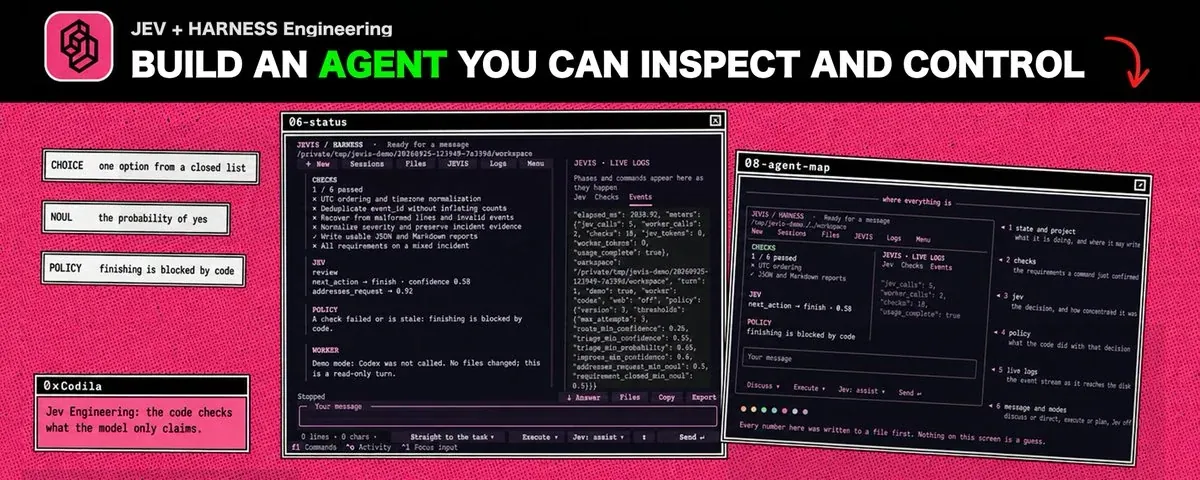
三个 build 都搭在 Jev 上:需求报告、诊断选择、有边界的修复闭环。代码能跑,跑的是真机,两套标注集上一共 28 个决定全对,28 对 28。
原文标着 2026 年 9 月 20 日,Python,代码和存档的运行记录一起给。
有个 agent 写了点代码,跑了个测试,然后报「完成了」。测试确实绿。可需求是按标题或描述搜索,测试只查了标题。
把问题重述一遍没用。这种局面需要的是一个具体的下一步:找到那条缺失的确认,跑那个检查,把一份可复现的失败交给 agent。这就是 Jev 的活——它是 TypeSafe 家的模型,返回的是按你事先定好的形状给出的决定。
一张工单就能说明这个接口。然后同一个接口撑起三个 build:需求报告 → 检查选择器 → 有边界的修复闭环。三个各自独立能站住。
仓库里有全部代码、教学应用和存档的运行记录。
文中有一次成功的修复、一次因为答案不够确定而停下、以及一条被验证过的继续办法。
不带任何 key 也能跑,全部走 demo 模式:测试跑真实代码,模型的回答来自预置的 fixture。十分钟上手路线。
一、Jev 返回的是决定,不是文字
先看这张工单:
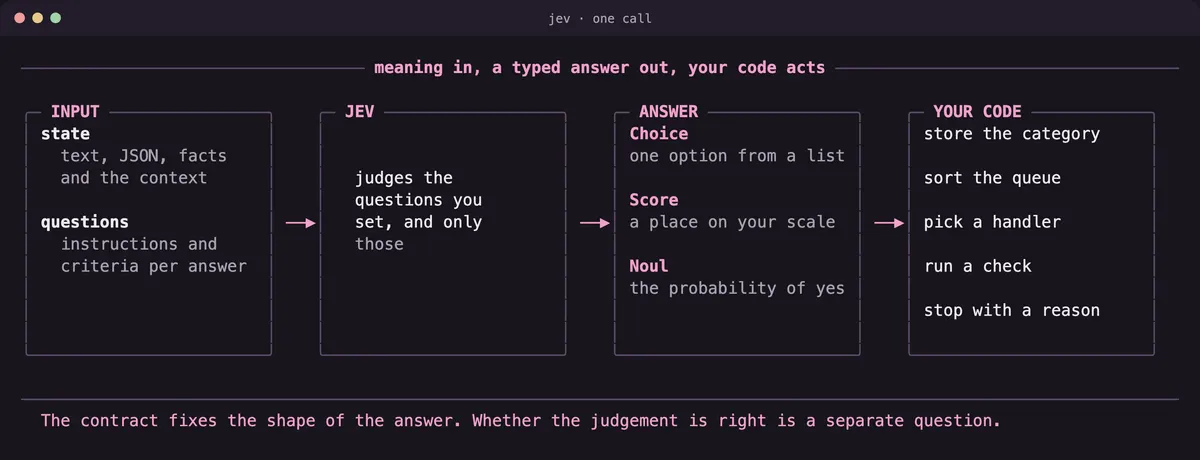
PDF 在 Safari 里导出失败,同一个文档在 Chrome 里没问题。现在先用 Chrome,但我还是想恢复 Safari 里的导出。
应用在这件事上需要三样东西:问题的类别、它对用户工作的影响、以及有没有变通办法。
Jev 收下文本和问题,返回程序接下来要用的值。允许的选项和每条判据的含义都由你来定义。TypeSafe 接口文档。
之前:模型返回一段文字,应用解析它、猜它的意思。之后:模型返回你列表里的一个值,应用直接拿它分支。
一次请求有三个主要字段:
payload = {
    "model": "jev-1.13.0",
    "state": ticket,
    "questions": questions,
}
state 放被判断的材料:一条消息、一段文档、工具结果,或者一个小 JSON 对象。questions 列出你想知道什么。model 填版本。
这篇钉住 jev-1.13.0。jev-latest 这个别名熟悉期很好用,但总有一天它会指向另一个版本。
请求有硬限制:整个请求 64k token,state 加最长的那条问题 32k,一个 Choice 最多 255 个选项,Score 的档位在 2 到 10 之间。
输入 token 每百万 $0.042,输出不计费。所以对着已经发过的 state 再加一个问题,账面上几乎不增加什么。
Jev 除了回答什么都不做。浏览器、shell 命令、写文件,全都属于围着模型搭起来的那个应用。
一句话:Jev 交回的是决定本身,而不是关于决定的文字,形状是代码不用解析就能接的形状。
二、三个原语:选项、刻度、判断
你要什么形状的答案,决定你该问哪种问题。
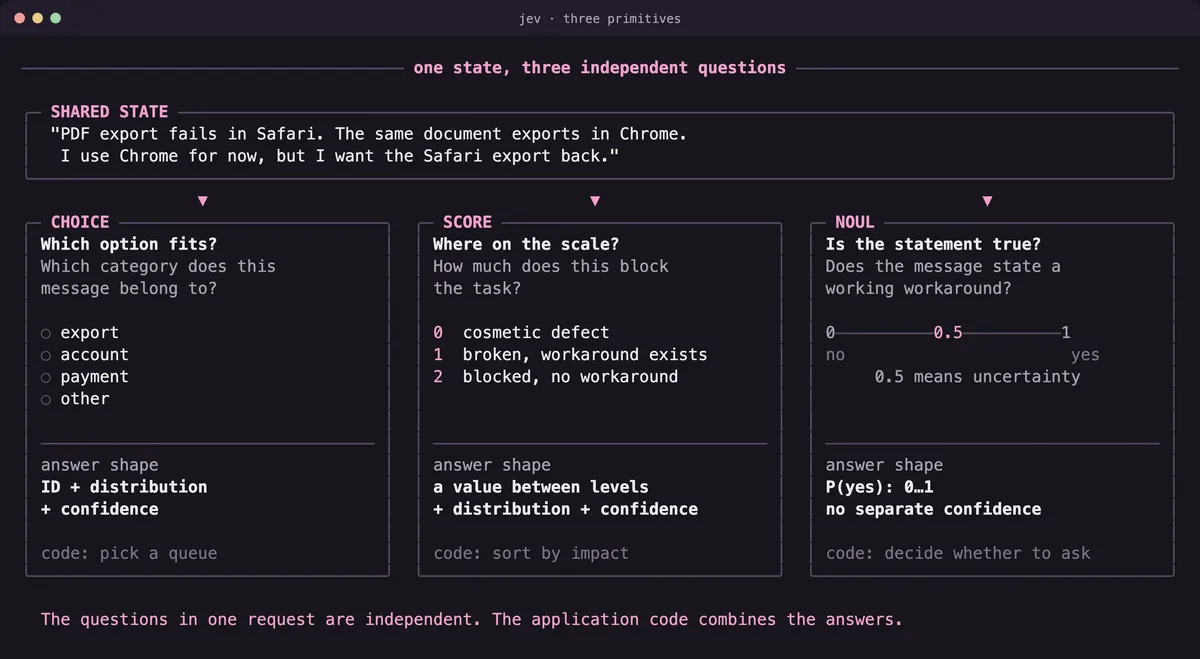
选项之间没有顺序时用 Choice。答案是某个刻度上的位置时用 Score。要判断某一句特定陈述成立不成立时用 Noul。
三种问题可以放在一次请求里:
questions = {
    "category": {
        "type": "choice",
        "instructions": "Which category does the main problem belong to?",
        "criteria": {
            "export": "Creating or downloading an exported file",
            "account": "Signing in and account access",
            "payment": "Charges, invoices and payments",
            "other": "None of the listed categories fits",
        },
    },
    "impact": {
        "type": "score",
        "instructions": "How does the problem affect getting the task done?",
        "criteria": [
            "Cosmetic defect; the task is completed the usual way",
            "The feature is broken, but a working workaround is stated",
            "The task is blocked; no working workaround exists",
        ],
    },
    "has_workaround": {
        "type": "noul",
        "instructions": "Does the ticket state a working workaround?",
        "criteria": {
            "true": "The author says outright that they do the same task another way",
            "false": "No working workaround is stated; there is only a guess, or nothing at all",
        },
    },
}
Choice 里那个 other 给了模型一个合法的出口,让它在列表覆盖不到时能说「都不合适」。没这个出口,赢家照样会出现,只不过是在一堆都不合适的选项里挑一个。
Score 的档位由数组下标决定:0、1、2。他们的档位描述的是可观察的情形。「差」「很差」「差到灾难级」这种写法会给不同的解读留下太大的空间。
一次请求内的各个问题是独立评估的:category 的答案不会成为 impact 的输入。如果前一个答案决定了下一个问题该有哪些选项,那就再发一次请求。原语文档、官方示例。
标签不是答案
上面那张工单实际存下来的答案:
{
  "model": "jev-1.13.0",
  "answers": {
    "category": {"type": "choice", "choice": "export", "confidence": 1.0,
                 "probabilities": {"export": 1.0, "account": 0.0, "payment": 0.0, "other": 0.0}},
    "impact":   {"type": "score", "score": 1.0, "confidence": 0.99,
                 "legend": {"0": "Cosmetic defect; the task is completed the usual way",
                            "1": "The feature is broken, but a working workaround is stated",
                            "2": "The task is blocked; no working workaround exists"},
                 "probabilities": {"0": 0.0, "1": 1.0, "2": 0.0}},
    "has_workaround": {"type": "noul", "noul": 0.95}
  },
  "usage": {"input_tokens": 746, "output_tokens": 79}
}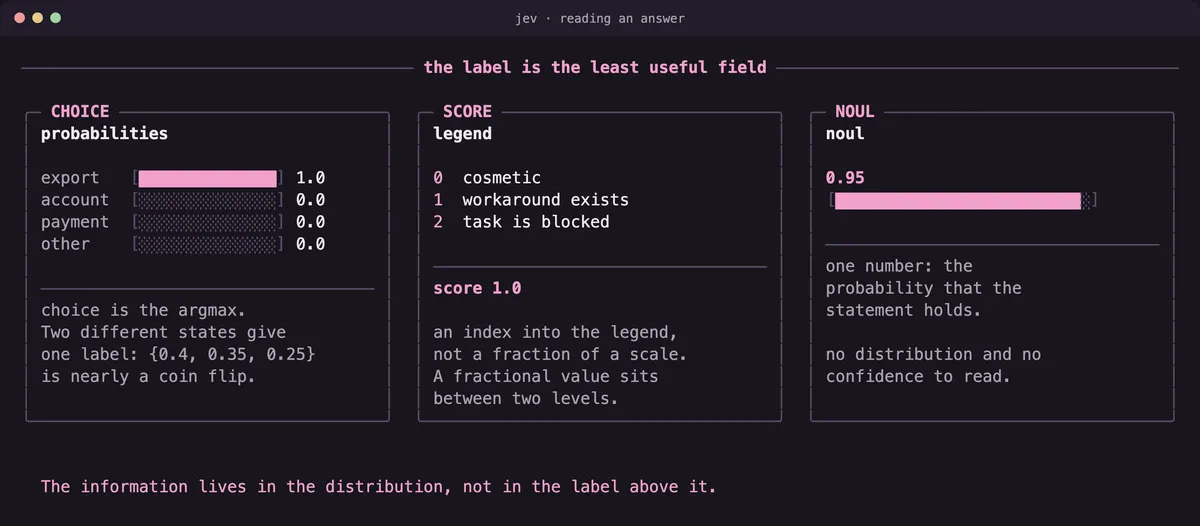
Choice 里要紧的字段是 probabilities,不是 choice。标签只是最可能的那个选项,除了它自己什么也没多。
{export: 1.0, 其余: 0.0}→ 标签 export;{export: 0.4, account: 0.35, payment: 0.25}→ 还是标签 export,可这几乎是抛硬币。
Score 里要紧的字段是 legend。1.0 单看什么也不表示:档位从 0 开始编号,这里有三档,1.0 落在中间那档。
这个数字是 legend 的下标。给 Score 设阈值要按这些下标来设,因为「档位总数的几分之几」是错的单位。
而且 score 回来的位置是按概率加权算出来的,不是某一档的标签:{0: 0.5, 1: 0.5} 会返回 0.5,而没有哪一档的编号是 0.5。
Noul 既没有分布也没有 confidence,就一个数字:那句陈述成立的概率。
它用起来最便宜,措辞也最危险。Choice、Score、Noul。
confidence 是同一个分布的另一种写法
文档把 confidence 和概率的集中程度挂在一起,但没公布公式,所以他们自己测了。
n 个选项时,这个值等于 (n × p_max − 1) / (n − 1)。拿工具箱里存档的全部 161 个 Choice 和 Score 回答核对过,最大偏差 0.015,就是四舍五入到两位小数的量级。
实操上:三个选项时设 confidence = 0.60 的阈值,等于要求 p_max >= 0.73。这道闸比看上去严。
但它仍然不能当成「在你的数据上答对的概率」来读。confidence 文档。
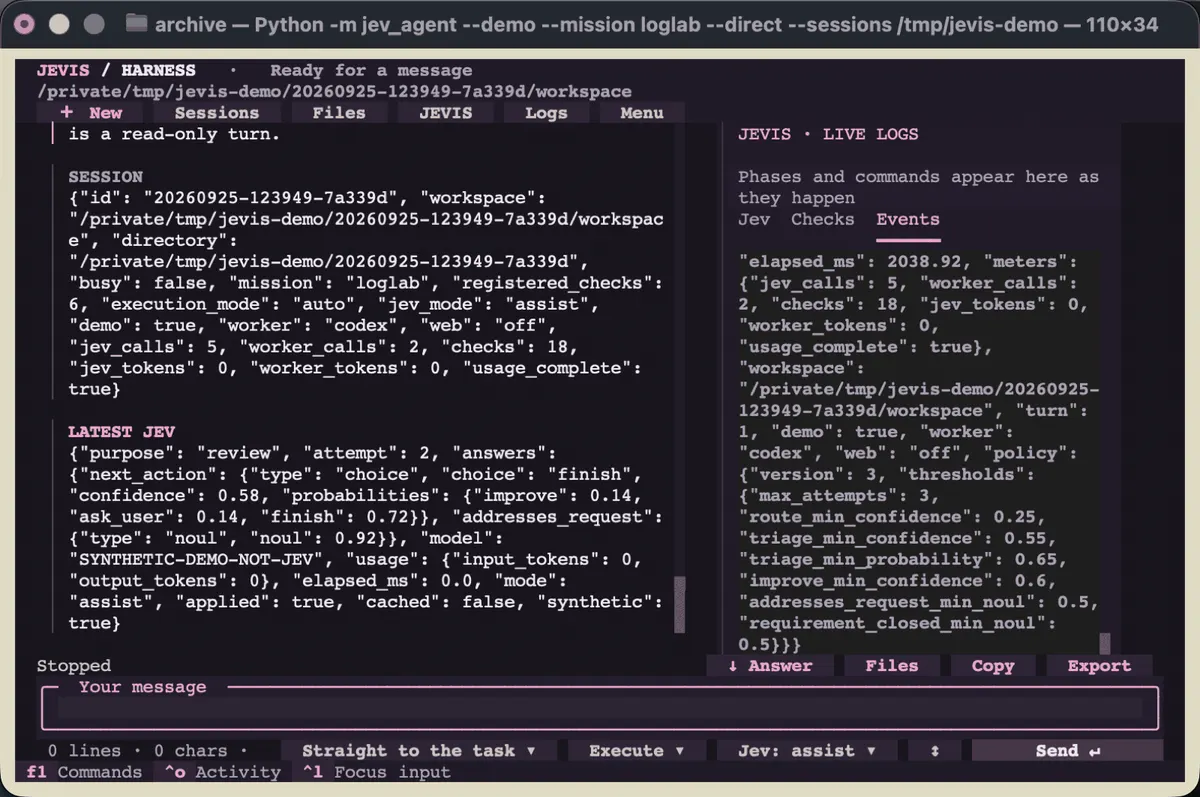
这是 agent 在展示一条存档的回答。标签写的是 finish,而它下面那行才是标签不够用的全部理由:0.72 对 0.14 和 0.14。模型名字显示为 SYNTHETIC-DEMO-NOT-JEV,因为没有 key 的时候,没有任何东西假装自己是 Jev。
用到了 Score,却没在三个 build 里用它
从这往后,所有决定都跑在 Choice 和 Noul 上。Score 只在第一次调用里出现过。
不是因为它更差。刻度适合那种答案连续、并且要拿一个分数当阈值的场合:先修哪个失败、缺陷有多严重。
而他们这个任务里的每一个决定,最后都属于两类:从一个封闭集合里挑一个,或者判断一句陈述。把刻度硬拉到这些决定上,等于凭空发明这个领域并不存在的档位。
1.5 分落在「能用」和「坏了」之间,说明的是答案内部有分歧,跟世界的状态没关系。
提问的措辞会改变答案
同一张工单、同一个问题——有没有说明一个可用的变通办法。两种问法:
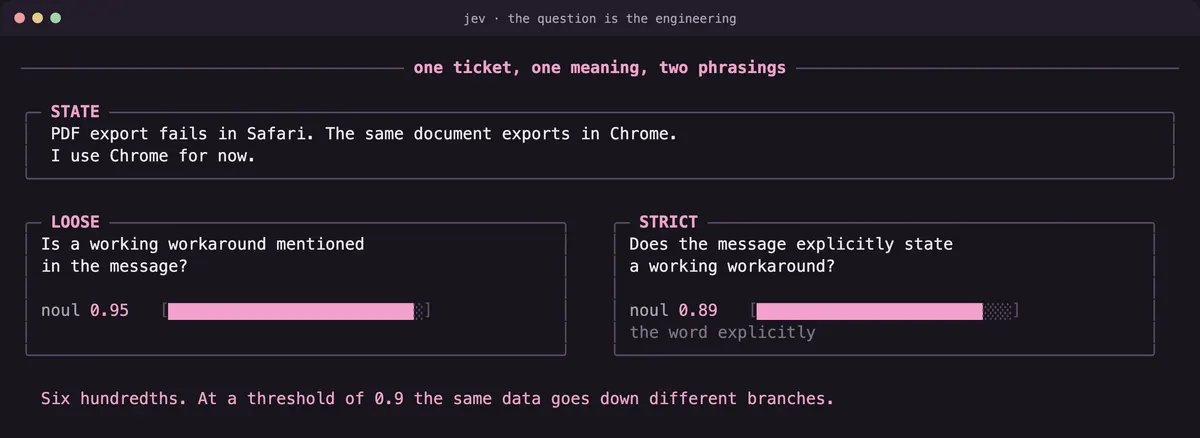
差别不在语言,在一个词:explicitly(明确地)。
客户写的是「现在先用 Chrome」。变通办法是真的,但只是顺带提了一句,不是明说。要求「明确说明」,数值合法地降下来。
标注集用的是第三个版本,更严,把什么不算变通办法写清楚了:
Does this customer's message explicitly report an alternative method that they have
actually used successfully to accomplish the affected task? Advice, an untried
suggestion, a question, and a failed alternative do not count.
百分之六的差距不算大。但你只设一个阈值,如果闸设在 0.9,这两种措辞就会把同一份数据送进程序的不同分支。
所以有个做法:把措辞、阈值、版本三样钉在一起,当一个东西来做版本管理。
一句话:原语由你要的答案形状决定。决定来自标签下的分布,也来自你提问的措辞,永远不来自标签本身。
三、选项由程序来造,不是模型
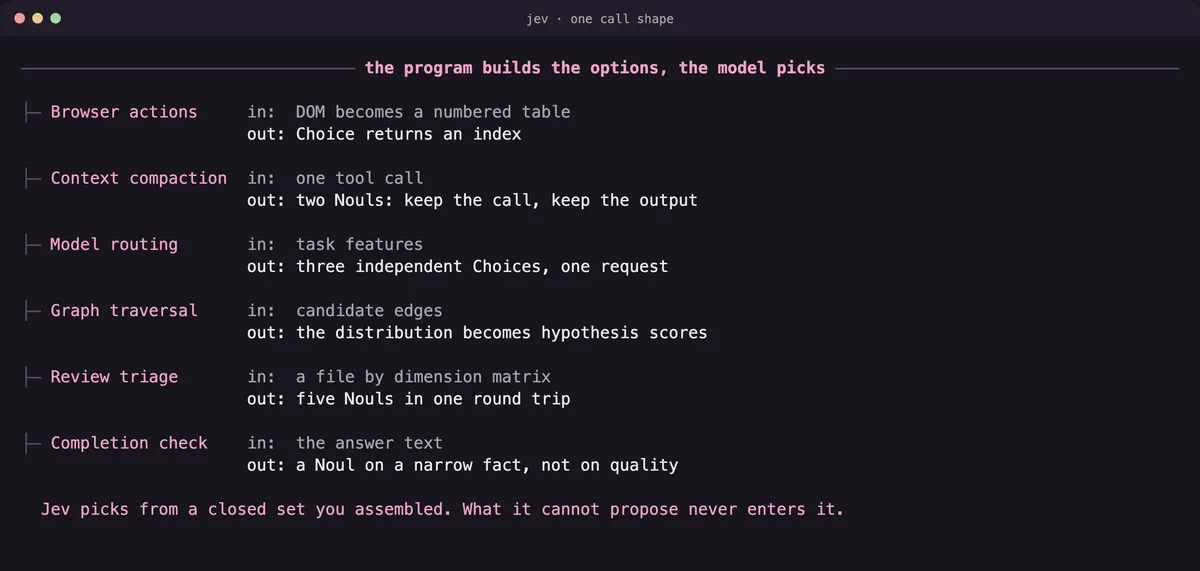
同一个调用形状,长出来的产品可以完全不同。变的是材料、问题,以及拿到答案之后做什么。
- 客服。一条消息 → 用 Choice 分到某个类别、用 Score 打影响 → 一个有可解释优先级的工单队列。
- 文档搜索。一个查询加一个召回片段 → 用 Noul 判断片段是否满足条件 → 结果排序。找候选仍然是应用的独立部分,见重排 cookbook。
- 浏览器操作。把 DOM 变成一张带编号的动作表,Choice 来挑编号。没有选择器,不写代码,见 browser-use/jev-ultrafast。
- 选模型或选工具。一个任务加上各个 worker 的描述 → Choice → 调用被选中的那个,见 LangChain 的文章。
- 检查一个 coding agent。一份需求加上工作的结果 → 判断证据和需求是什么关系,然后选一个诊断。这条就是他们完整搭出来的分支。
同样一个调用形状,还能长出四个产品,都来自已经有人给自己搭好的开源代码:
- 上下文压缩。每次工具调用问两个 Noul:这次调用本身有必要吗,它的输出有必要逐字保留吗。留下来的那些,一字不改。
- 知识图谱遍历。整个分布都用上:概率直接当 beam search 的假设分数,根本不取 argmax。
- 代码评审分流。把「文件 × 维度」的矩阵拆成一次请求里的五个 Noul。一次往返拿到五个概率。
- 完成度校验。问的是这条消息有没有声称工作做完了,不是工作有没有做完。这是关于文本的一个窄事实,不是关于质量的判断。
贯穿这些的一条:选项由程序来造。Jev 从你组装好的封闭集合里挑,而模型在物理上提不出来的东西,永远进不了这个集合。
关于数字本身有三条规矩,每一条都是先踩坑才学会的。
低置信等于没有意见。 他们曾经拿到一个 confidence 0.26 的 improve(阈值 0.6),然后写了一条规则把它读成「有地方不对」的信号。
之前:0.26 对 0.6 读作「有地方出问题了」。之后:0.26 读作「模型不知道」,交给别的东西去决定。
缺失的判断不等于同意。 代码里很容易写出「没有答案时把 confidence 视为最大」,最后得到一个系统:Jev 连不上反而提高了自动完成的机会。
判断者的参与必须是一个显式状态:问过并答了、根本没问、问了但不可用。第三种情况必须和第一种区分开。
给建议要两个阈值。 只有当 confidence 高于 0.55、且所选类别的概率高于 0.65 时,提示才落地。只用一道闸,要么漏掉「在两个几乎并列的选项里很有把握地挑了一个」,要么漏掉「分布很尖,但模型不信任自己」。
一句话:产品来自你自己搭的那个封闭选项集,以及对附在它上面的那个数字的诚实解读。模型聪明与否不是来源。
四、实验台:一个半数需求已被确认的搜索
需要 macOS 或 Linux,Python 3.9+,不装任何外部包。实时请求要 key,从 TypeSafe API Keys 拿,通过 TYPESAFE_API_KEY 传进去。问题可以先去 Playground 手动试。
第一次调用:
python3 run.py inspect --mode live --case export-ticket --out runs/inspect-live
python3 ../first_call.py
这条命令会存下 decisions.json 和发给模型的完整请求。再跑一次就换一个新的 --out。
一次实时调用就是一个 POST,只用标准库:
request = Request(
    "https://api.typesafe.ai/v1/systemone",
    data=json.dumps(payload, ensure_ascii=False).encode("utf-8"),
    headers={
        "Authorization": "Bearer " + os.environ["TYPESAFE_API_KEY"],
        "Content-Type": "application/json",
    },
    method="POST",
)
with urlopen(request, timeout=30) as response:
    result = json.load(response)
first_call.py 确实跑了,也确实打印出了 export、1.0、0.95。
这次请求约 0.98 秒,API 报了 746 个输入 token、79 个输出 token。这是一次请求的一次观测,对延迟什么也没承诺。完整 API 契约、存档的回答。
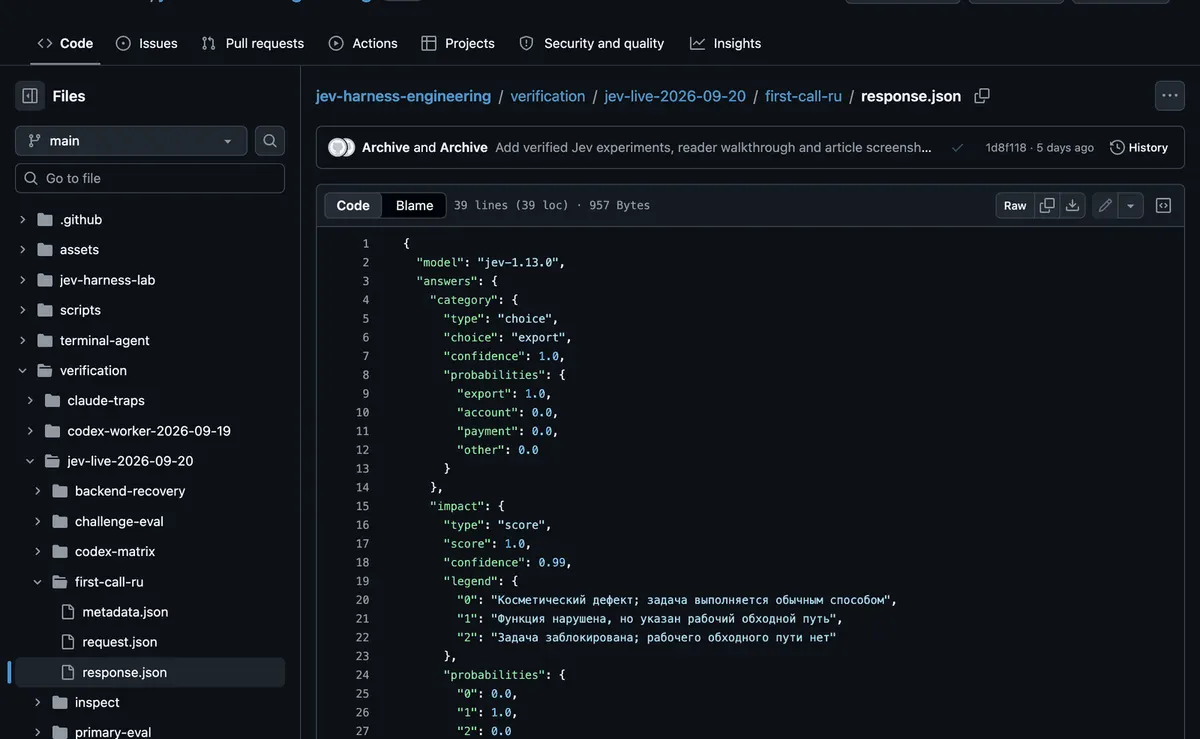
这篇文章里的每个数字都是一个你能打开的文件。上面这张就是第一次调用返回的响应,原样。
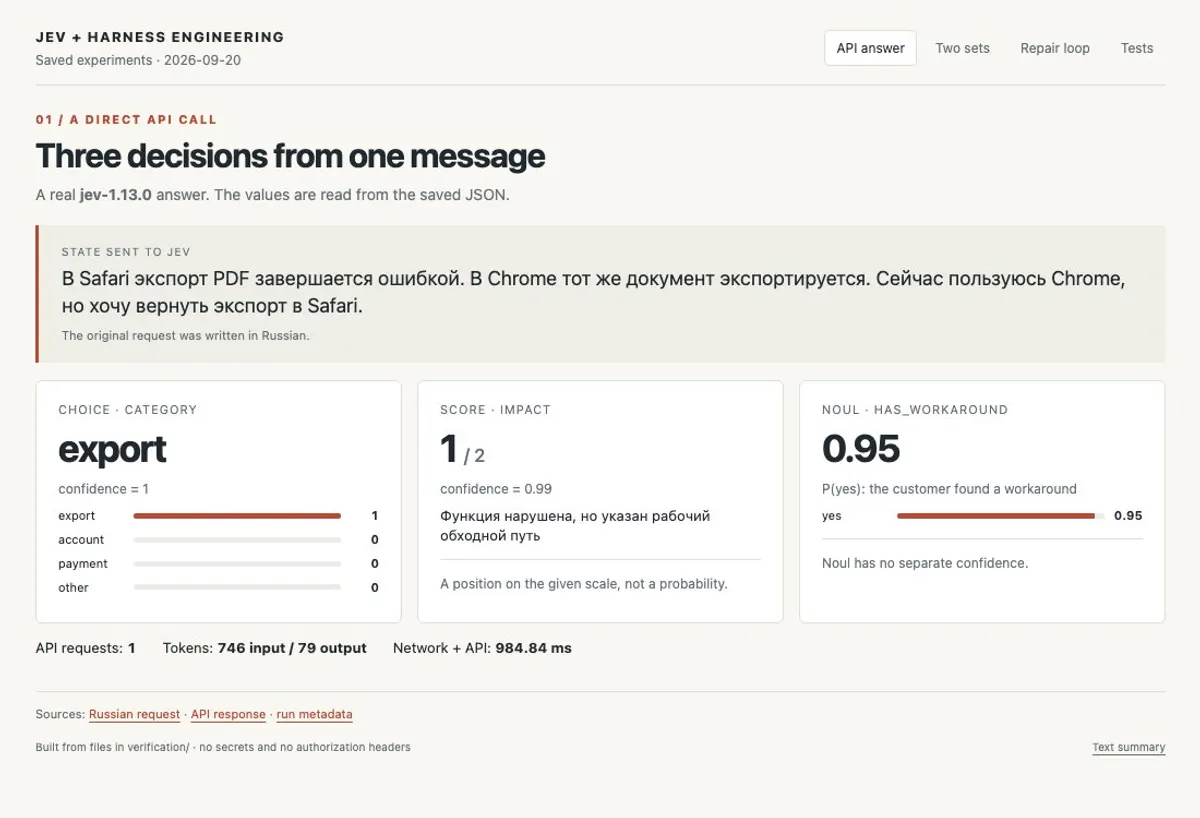
没有 key 时,同样可以在 demo 里研究这个接口。它会故意把模型名写成 SYNTHETIC-DEMO-NOT-JEV,预置答案也不计入后面的测量。
缺陷藏在层与层接缝处的教学应用
现在看教学应用本身。契约很短:
R1. The query "milk" finds the card "Buy milk": the word is in the title.
R2. The query "carton" finds the same card: the word is only in the description.
整个搜索一屏放得下:
ITEMS = [
    {"id": 1, "title": "Buy milk", "description": "Remember the blue carton"},
    {"id": 2, "title": "Prepare slides", "description": "Explain the export feature"},
]

def api_search(query, fields):
    query = query.casefold()
    return [item for item in ITEMS
            if any(query in item.get(field, "").casefold() for field in fields)]

def ui_request(query):
    return {"query": query, "fields": ["title"]}

def search(query):
    request = ui_request(query)
    return api_search(request["query"], request["fields"])
后端能做的事:按标题、也按描述搜索。接口要的字段:只有标题。
起点是这样:worker 声称搜索做完了,日志里只有一条针对 R1 的、跑过了的检查。
检查注册表把检查分成强制和诊断两类:
R1  requirement      search finds the card by a word from the title
R2  requirement      search finds the card by a word only in the description
C1  mandatory check  search("milk")   expects card 1
C2  mandatory check  search("carton") expects card 1
D1  diagnostic       calls the backend directly across both fields
D2  diagnostic       shows which fields the interface actually sent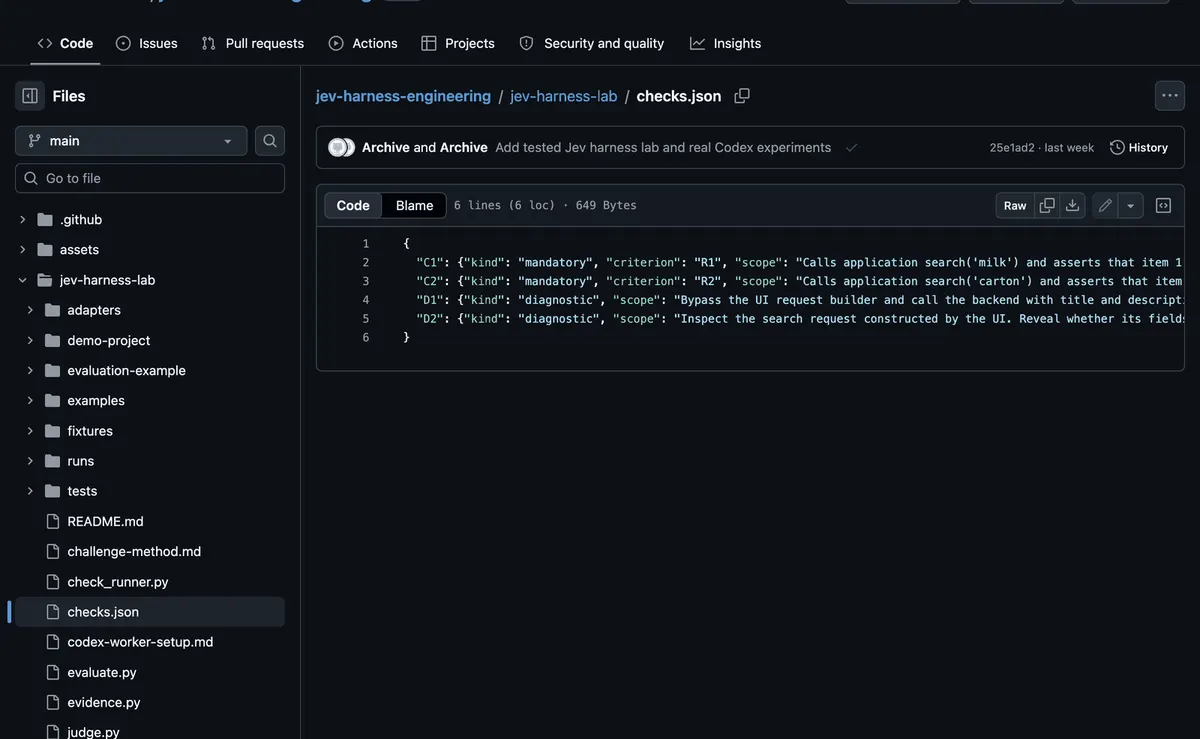
C1 和 C2 由代码自己跑:它们和需求的关系是事先知道的。D1 和 D2 还得被选出来,Choice 的位置就在这儿。
如果你的项目已经有精确又便宜的测试覆盖着,那就去跑它们,这里不需要 Jev。这个实验台的意义在于造出那个「语义判断可以插进来」的位置,然后看清在你自己的材料上到底需不需要它。
一句话:实验台是这么搭的——强制检查由代码决定,只把一个选择留给模型:要哪一个诊断。
五、三个 build:报告、选检查、闭环
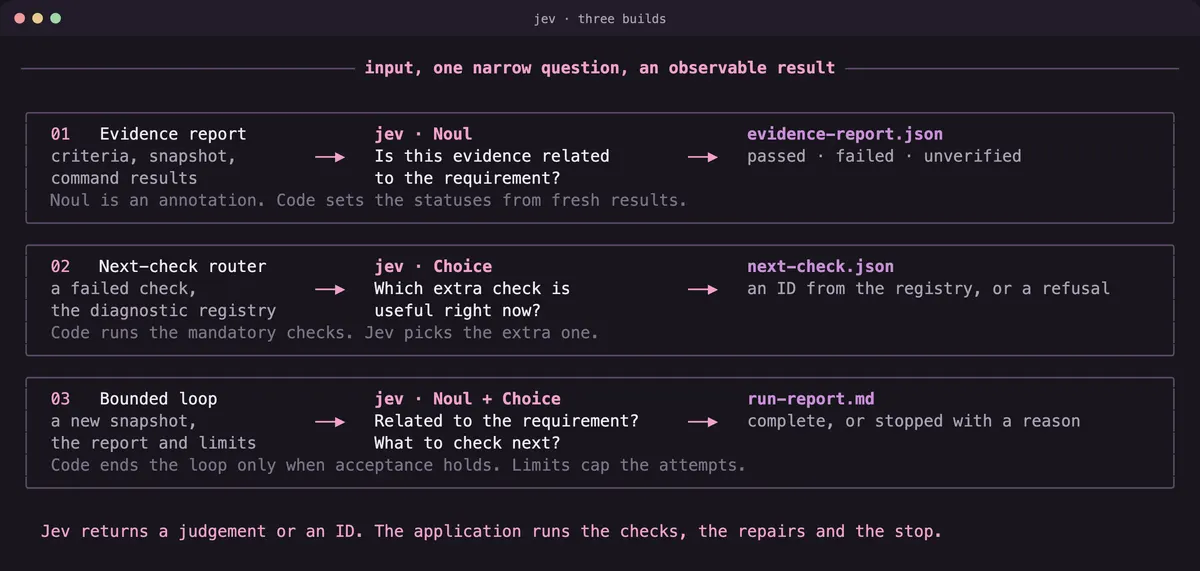
流程拆成三个工具,各有各的输入输出。这样出事时能看清是哪一环:事实和需求之间连错了属于第一个工具,诊断没用于是第二个,完成判错是第三个。想用一条长提示词把整件事做好更难,因为同时移动的未知量不止一个。
六、Build 1:事实和声称分开
输入:需求、代码版本、检查结果,以及单独放着的 worker 消息。输出:给程序看的 evidence-report.json 和给人看的 evidence-report.md。
python3 run.py evidence --mode demo --case missing-evidence --out runs/evidence-demo有三个状态:passed(当前版本的检查确认了这条判据)、failed(当前版本的检查发现了违反)、unverified(确认不足)。worker 那句「都做完了」被存成改动作者的声称,永远不会变成一条测试结果。
每个事实都带来源:检查 ID、命令、退出码、输出、时间戳、项目快照。一条真实的 C2 失败记录:
{
  "check_id": "C2",
  "snapshot": "d8fd8d95…fc7408",
  "snapshot_after": "d8fd8d95…fc7408",
  "exit_code": 1,
  "stdout": "{\"check_id\": \"C2\", \"kind\": \"assertion_failure\", \"detail\": \"description-only search: expected [1], got []\"}"
}
快照取两次,跑之前和跑之后:检查不许改动项目,两个哈希相同就是这件事的证明。如果检查之后代码变了,那次绿的结果不能顺延到新版本上。
状态判断完全是程序的事。从来不会让 Jev 去比较字符串,或者判断退出码是不是零:
def requirement_status(current_snapshot, latest_check):
    if latest_check is None:
        return "unverified"
    if not is_fresh(latest_check, current_snapshot):
        return "unverified"
    if latest_check["exit_code"] == 0:
        return "passed"
    if latest_check["exit_code"] == 1:
        return "failed"
    return "unverified"   # 退出码 2、超时、runner 崩了
崩掉的工具既不算确认,也不算否证。
语义判断在这些时候插进来:材料跟某条需求有关,但没有到它的精确链接——别人测试的一段描述、报告的一个片段、一次手动运行的观察。他们问得很窄,一次一对:一条判据,加上一段证据描述。从来不问「任务是不是被正确完成了」。
实跑里那条毫无争议的 C1 → R1,Noul 给的是 0.88 到 0.91。哪怕没什么可争的,模型也不肯给一个干脆的 1.0。
主要限制:这种标注始终只是标注,永远不会把某条判据升成 passed。只有一张显式的验收映射才给出「可以完成」的许可。
所以 API 失败在两种位置上的代价不一样:
可选调用:Noul 标注时 API 不可达,报告记下
scope_annotation_error,验收仍由当前版本的 C1/C2 决定。强制调用:Choice 路由失败,整个闭环停下。
报告不替 Jev 编造理由。模型返回了一个数字;「C2 没在当前版本上跑过」这种句子是程序根据日志写出来的。报告本身已经是一个独立的产品:评审之前你会打开它,哪怕最后是人来修。
七、Build 2:按「能换来什么新事实」选诊断
输入:一份没做完或者失败的报告。输出:next-check.json,里面是一个具体的检查 ID 和做出这个决定的依据。
python3 run.py next-check --mode demo --case missing-evidence --out runs/router-demoC2 是强制的、还没跑过时,由代码指派。等 C2 已经失败、需要定位原因了,选择权交给模型:
next_check_question = {
    "type": "choice",
    "instructions": ("Which available diagnostic yields the most useful new fact "
                     "for locating the observed failure?"),
    "criteria": {
        "D1": "Search by description directly through the backend",
        "D2": "Inspect which search fields the interface passes",
        "none_suitable": "No available check would produce a useful new fact",
    },
}
措辞决定结果:
坏的:「挑最好的那个测试」,选项叫 test_1、test_2。模型完全不知道那两条命令里面是什么。好的:每条描述都说清这个检查能定下哪个问题。
应用读 choice,存下分布,拿 ID 去匹配允许的检查注册表。命令从它自己的配置里取,模型给的文字永远不会被当成 shell 执行:
selected = answer["choice"]
if selected == "none_suitable":
    action = "stop_for_review"
elif selected not in allowed_check_ids:
    action = "stop_invalid_answer"
else:
    action = "run_registered_check"
这个路由器有个很简单的竞争对手:把所有检查都跑一遍。当 D1、D2 只花几毫秒时,这个对手很可能赢。选择器真正有意思,是在诊断变贵或者变多之后。
八、Build 3:每一次停下都有理由
输入:需求和这一次运行的当前状态。输出:按契约完成,或者带着一个有名字的理由停下。
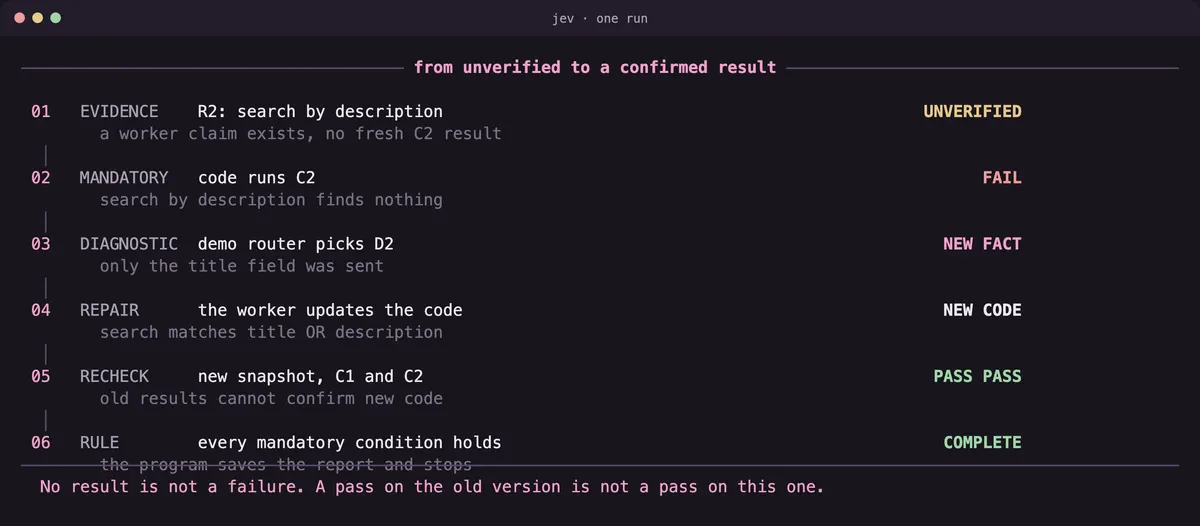
五条规则,用文字说:
- 强制的确认缺失或过期:跑对应的检查。
- 某个检查发现了违反:需要的话再取一个额外事实,然后把一份可复现的失败交给 worker。
- 当前版本上所有强制判据都已被确认:按这份契约完成。
- 什么都没变、没有合适的诊断、或者到了某个上限:存下状态,带着理由停下。
- 那个强制 Choice 的答案缺失、非法或者低于阈值:带着理由停下。API 报错永远不等于确认就绪。
模型给的高分推翻不了一个失败的 C2。一次完整的决定,精确的含义是「所描述的验收契约被满足」;两个测试并不证明不存在任何可能的缺陷。
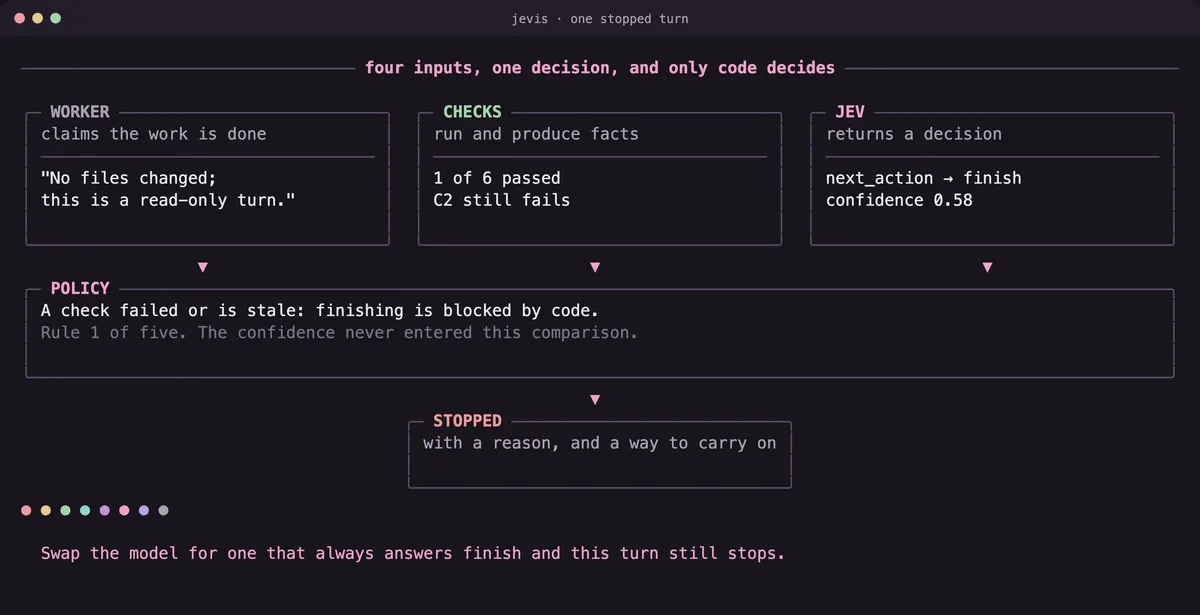
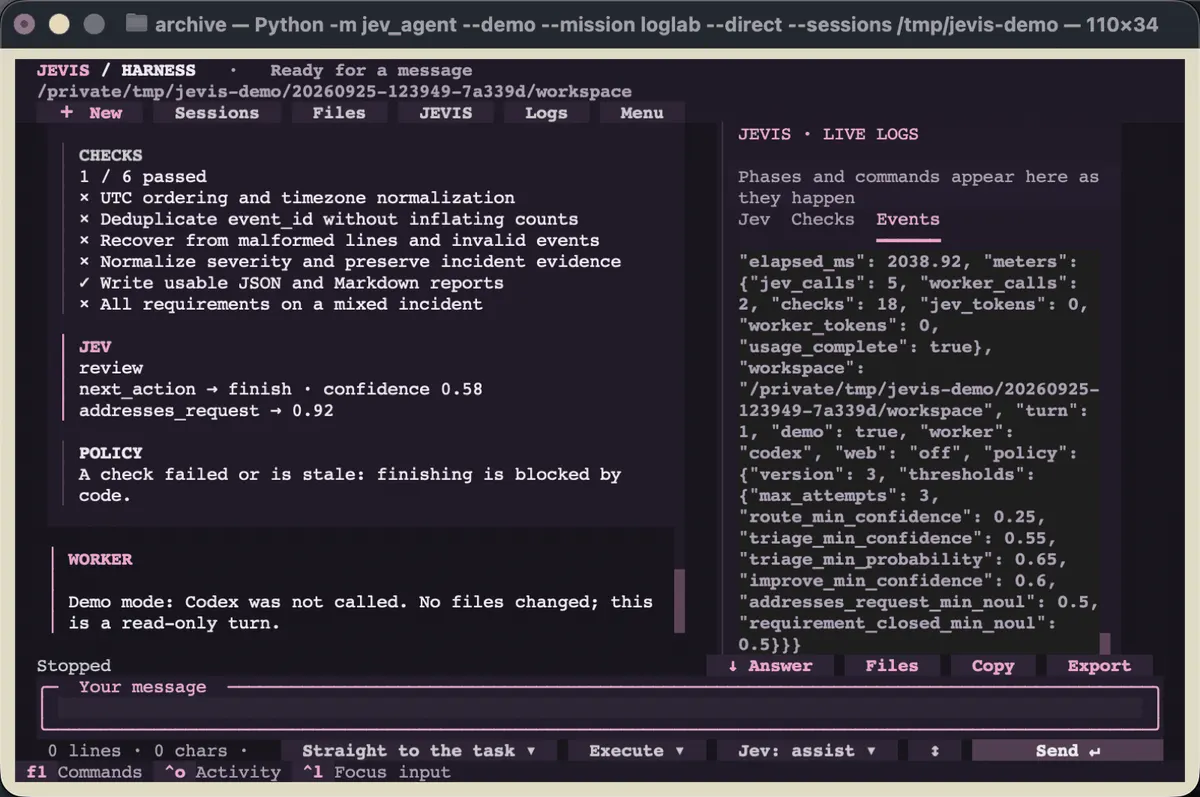
真实运行里的规则 1:模型选了 finish,六个检查里只有一个通过,于是策略写下「有检查失败或过期,代码禁止完成」,这一轮停下。模型产出的那个数字从来没进过决定。
worker 拿到的不是「再试一次」,而是一个最小的包裹,里面每条事实都能指回一条工具记录:
Criterion: R2, search finds a record by its description.
Reproduction: registered check C2.
Result: the expected record was not found.
Extra observation D2: the request carries fields=["title"].
Repair scope: application code; the acceptance contract stays as it is.
After the change: rerun C1 and C2 against the new snapshot.
改完就要有新快照。旧的 PASS 和 FAIL 留作历史,当前是否就绪由新的检查决定。如果 worker 交回一份很有把握的报告但文件根本没变,闭环不能永远重查同一样东西。
类似架构别处也在搭:Foreman 同样把 worker 和监督性的决定分开。
一句话:就绪由注册检查的新鲜结果决定,模型只回答那些「答案没法从日志里推出来」的窄问题。
九、实跑看到了什么
worker 用的是 Codex CLI。它收到任务、真实的失败和诊断,读 app.py,做一处改动。然后 harness 自己重跑检查,agent 的回答不决定验收。
工作副本被限制在这次运行的目录里,而且只有 app.py 允许被改。
适配器跑在 workspace-write 模式下,禁止提权,关掉网页搜索。一次尝试 90 秒超时,策略允许最多两轮修复、整个闭环 300 秒。
这次用的 CLI 是 0.155.0-alpha.9。见 Codex 非交互模式文档。
python3 run.py loop --mode live --selector fixed \
  --case missing-evidence --task task.md \
  --worker-config worker-config-codex.json \
  --policy policy-codex.json \
  --out runs/my-codex-run
换 worker 就换适配器,协议不变:stdin 收一个 JSON 对象,含 task、project、feedback、iteration;stdout 回 {"claim": "..."}。非零退出码、非法回答、超时,各自都产生一次带理由的停下。
先看固定的诊断选择。开跑之前他们把三个起始缺陷冻住,一次一个交给实时的 Codex:
- 只有接口的问题:请求丢掉了
description字段。15.17 秒。 - 只有后端的问题:接口两个字段都传了,后端只读标题。17.02 秒。
- 两个缺陷同时存在。20.43 秒。
每种都是靠一处真实的代码改动收尾的:一次修复、五个检查,最后独立的验收通过。
停下之后,另有一个进程拿 worker 从没见过的四条查询去测。没有出现一次错误的「完成」。运行日志。
然后同一套用例,换成 Jev 来做选择。代码和输入在第一次调用之前就冻进了一份清单:
python3 worker_eval.py --selector jev --out runs/my-jev-worker-evaluation- 接口缺陷:选了 D2,一次修复,五个检查,验收 PASS,20.98 秒。
- 后端缺陷:还是 D2,但 confidence=0.52,低于记录的阈值 0.60。跑完两个强制检查后停下,worker 根本没启动,独立检查确认缺陷还在。2.17 秒。
- 两个缺陷同时存在:D2,一次修复,五个检查,PASS,21.57 秒。
之前(固定选择):三个准备好的缺陷,三次修复。之后(Jev):两次自动完成,一次停下。
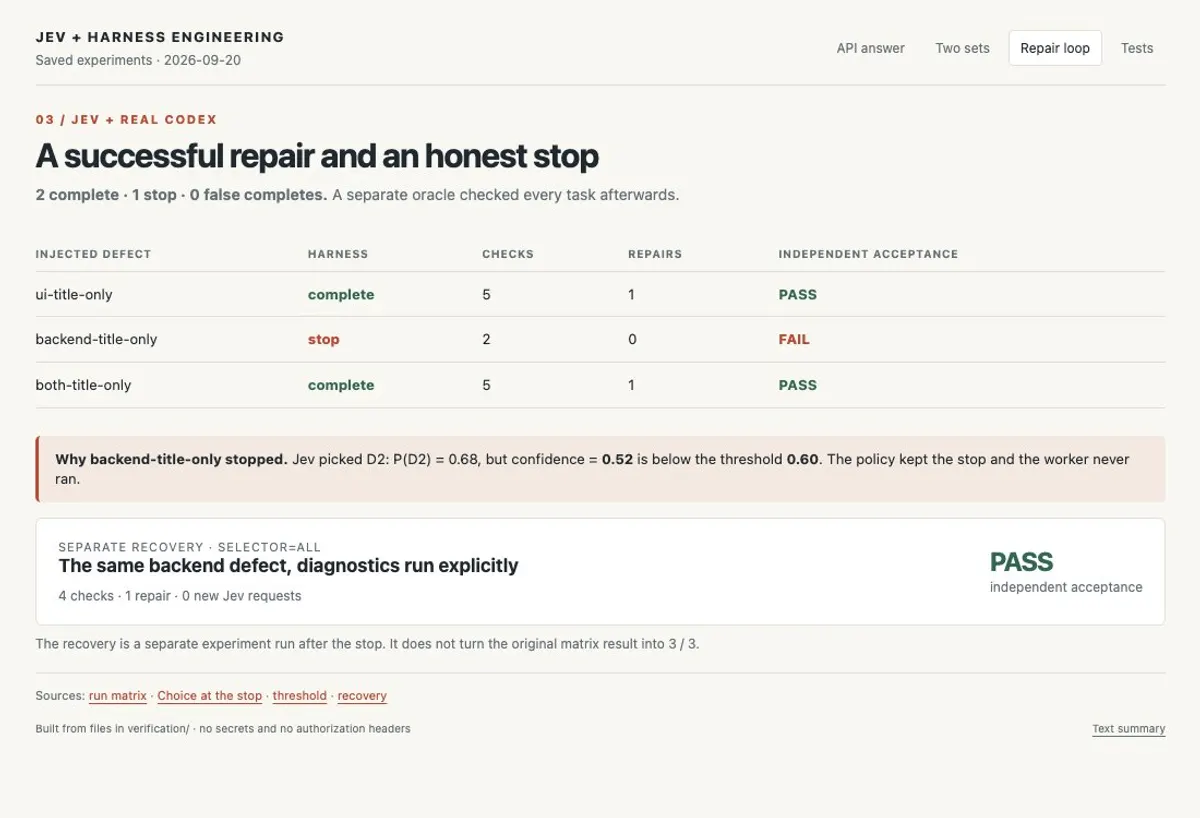
三次运行的分布:D2 得 0.85 时置信度 0.77,0.80 时 0.70,0.68 时 0.52。最后一个就是那次停下。候选之间并不是并列的:D1 只有 0.26。但这个分布确实比另外两次更平,因为缺陷在后端,直接走 D1 调用后端,并不比通过 D2 检查接口更差。三次运行的全部结果。
同样没有错误的「完成」。在这几个例子上,Jev 的优势并没有被确立——这比承诺「加一个判断者就能改善任何流程」要诚实。
局限是普遍性的:请求不带 seed,也不带 temperature,所以同一个请求可能返回不同的概率。离阈值的余量是八个百分之一,重采样一次就吃掉了。你在代码里放阈值之前,把同一个请求发十次,看看散布。
停下来了,总得有办法继续
他们保留了那次失败的尝试,复制它的状态,明确选择 all:两个可用诊断都跑,然后把事实交给 worker。Jev 的阈值没动。
新的一次运行:四个检查,一次修复,独立验收通过,Jev 请求零次。
cp -Rf runs/my-jev-worker-evaluation runs/my-jev-worker-recovery
python3 run.py loop --mode live --selector all \
  --state runs/my-jev-worker-recovery/backend-title-only/state.json \
  --out runs/my-recovery-result \
--worker-config worker-config-codex.json --policy policy-codex.json状态里存着指向项目的相对引用和已经跑过的检查记录。所以上一轮那两个新鲜的强制检查会被原样读回来,等代码一改再重跑。恢复日志。
不确定的选择会怎么处理,要事先定好。两条便宜的本地诊断,都跑一遍是合理的。一个很贵的外部动作,可能就需要人来。
标注集:28 对 28,跑了两遍
能跑的代码回答了「系统搭起来了没有」。Jev 有没有用是另一回事,得单独比,而一个节点就是起步的地方。
python3 live_eval.py --out runs/my-jev-evaluation第一套:18 个状态,28 个决定。其中十个是俄语和英语的工单,对应 Choice 和 Noul;另外八个是 D1、D2、none_suitable 的诊断情境。参考标签从来没传给模型。
28 个答案对 28 个:类别 10/10,变通办法 10/10,下一个诊断 8/8。策略接受了每个答案,其中两个正确答案是 none_suitable。18 次请求,没有 API 错误,17.10 秒,9,322 输入 token、1,024 输出 token。第一份日志。
第二套 18 个新用例,在没看未来答案的前提下凑出来,问题、阈值一律不改:否定句、没试过的建议、卡片标题里的关键词、想改写类别的文字尝试、过期快照、已经跑过的诊断。方法说明。
又是 28 对 28,全部被策略接受,三个正确的 none_suitable,没有 API 错误。17.26 秒,10,824 输入、1,026 输出 token。第二份日志。
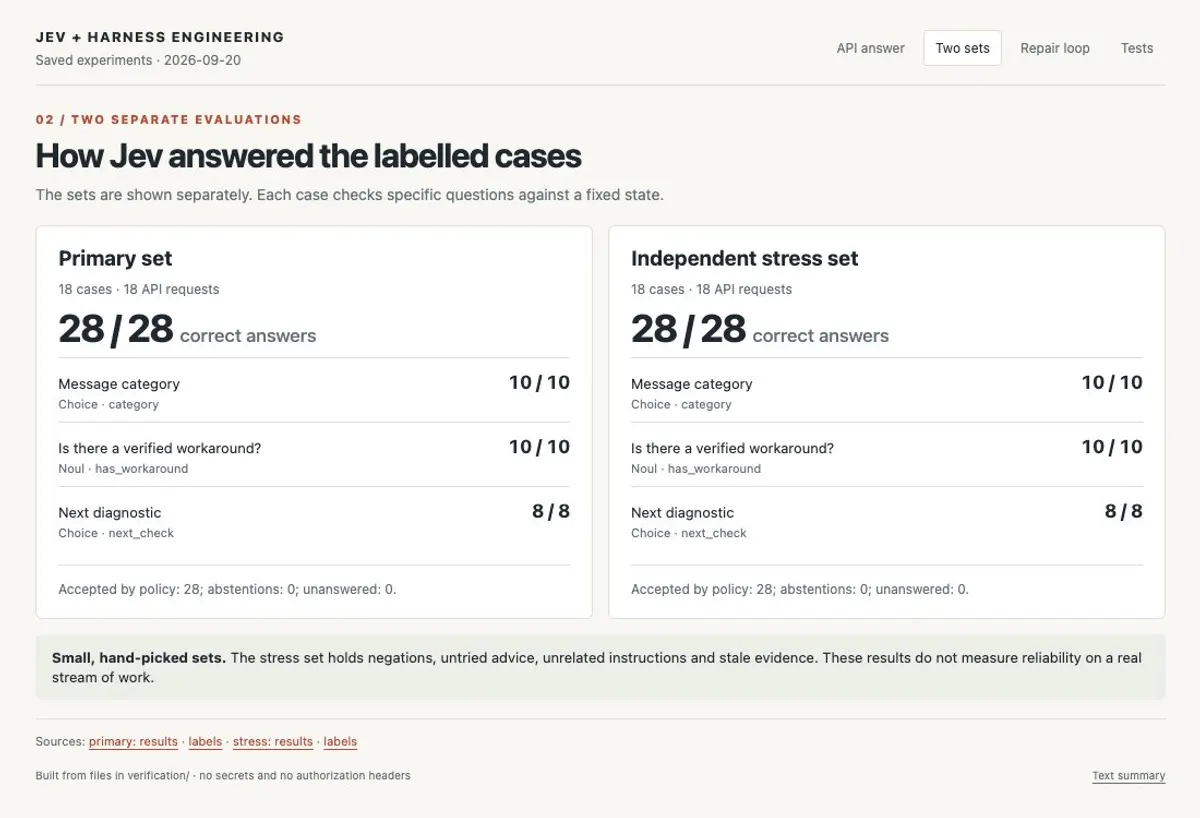
这两套都不大,用例是他们自己挑的。它们只能说这些列出来的用例,对你的真实流量、你的标定、以及对任意文本注入的鲁棒性,什么也说明不了。
标注集上的准确率不等于任务做完:
在一个标注状态上:一个明显有用的步骤。在一个真实闭环里,C2 失败的那次:两个诊断都有用,而一次不确定的选择让修复停下了。
所以要数整条链。先看质量:错误的完成、没被确认的需求、独立的最终验收。再看成本:没必要的干预、检查数、worker 尝试次数、总耗时和花费。
最终评估发生在停下之后,它的测试和专家答案从不进入运行中的 worker 和选择器。否则你等于先给了系统一个提示,再拿它的表现宣布成功。
harness 里的错误和模型里的错误一样容易造出假成功,所以 harness 自己也要有测试:一共 83 个检查,包括判断者可选调用失败、token 记账不全、以及把一个存档项目搬家。CI 在 Python 3.9、3.12、3.13、3.14 上跑。
python3 -m unittest discover -s tests -v
python3 run.py replay --run runs/first-loop --policy policy.json
replay 读存档的输入和答案,重算策略动作,不调用任何模型。把设置副本里的检查预算调小,它会告诉你第一个不同的动作是什么。越过那个分岔点,你就不能把旧记录当成新实验:如果另一个策略选了 D1 而不是 D2,旧日志里往下的那些修复属于另一段历史。
Jev 1.13 的文档列了九个弱点,其中四个直接打到他们这个 build:条件的字面理解、精确计数和日期比较上的错误、被无关上下文拖累、以及误导性材料的影响。另外两个之所以要紧,是因为他们的 Noul 判据本身建立在否定之上。见已记录的局限。
所以有条规矩:语义相关性问得窄一点,精确的算术和不变量交给代码。
一句话:标注集说明模型答得对。它不说明这条链能到达结果。
十、搬回自己项目怎么开始
先说三个大家最容易踩的坑。
confidence 看起来像 probabilities 旁边的一个独立信号。 它是同一个分布的另一种形式。先决定你要的 p_max 是多少,再手工换算成 confidence,而且两种情况都把整个分布留在日志里:赢家解释不了停下,亚军能。
一条 Noul 的语义标注会长成验收。 先出现在报告里,然后有人拿它当闸,然后模型给个绿的就算做完。有一个动作能测它:把模型关掉,如果你的流水线仍然报成功,那它从一开始就没在拿证据当闸。
阈值是照一次运行定下来的。 八个百分之一,比一个你还没测过的散布还小。
搬过来从一个需求开始。挑一个,比如「改变搜索查询时保留已选过滤器」。给它一个 ID,写清强制检查,想明白哪些额外观察有助于定位失败。
然后才写 Jev 的问题。把这个需求对应的短材料放进 state,一起放进它从哪来、当前版本是什么。
Noul 里问一条具体的关系。Choice 里把每个诊断能带来什么新事实写清楚,并保留 none_suitable。
落到文件上,就是同步修改 task.md、evidence.py 里的 CRITERIA、checks.json 里的条目、check_runner.py 里可执行的检查,以及独立的验收。只往 --task 里塞新文字,不会造出一份验收契约。
jev-harness-lab/
  run.py                  commands and the wiring between stages
  judge.py                questions, TypeSafe HTTP API, demo answers
  evidence.py             facts, snapshots, per-requirement reports
  policy.py               permitted actions and stopping
  worker.py               the worker protocol
  checks.json             the check registry
  policy.json             thresholds and limits
  task.md                 the task and the acceptance contract
  demo-project/           the small application with search
  adapters/codex_cli.py   the tested live Codex adapter
  worker_eval.py          three real experiments with a coding agent
  live_eval.py            labelled evaluation of Jev's decisions
  evaluate.py             offline matrix of the three policies
  tests/                  tests of the harness itself
从你现在需要的那个 build 开始。报告在人工评审之前就有用,路由器帮你组织诊断,闭环把它们接到 worker 上,并记下为什么停。
这些都不专属于 Jev。而且在一个玩具搜索上学,比在生产队列上学便宜。
一句话:在把一个模型的数字放进 if 之前,先弄清这个数字是什么,以及答错一次要你付多少。
打开你 agent 上一次失败的运行,从里面取一个状态,问 Jev 一个窄问题。把答案和一条简单规则做出的决定放在一起比:你手里就会留下这次请求、真实结果,以及一条清晰的「有没有用」的判准。
有类型的答案仍然是一个意见。检查才决定就绪。
如果你要的不是实验台而是一个成品 agent,就用同样这三个 build 搭出来的那个:JEVIS 终端 agent,一行命令装好,不带 key 也能跑。
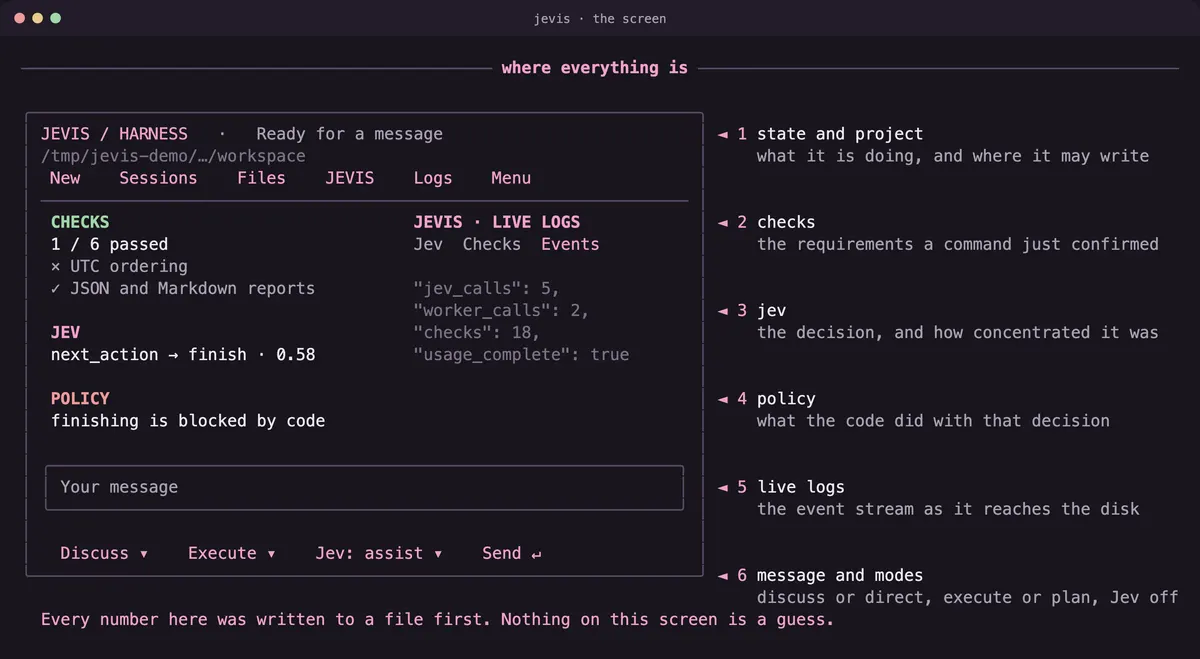
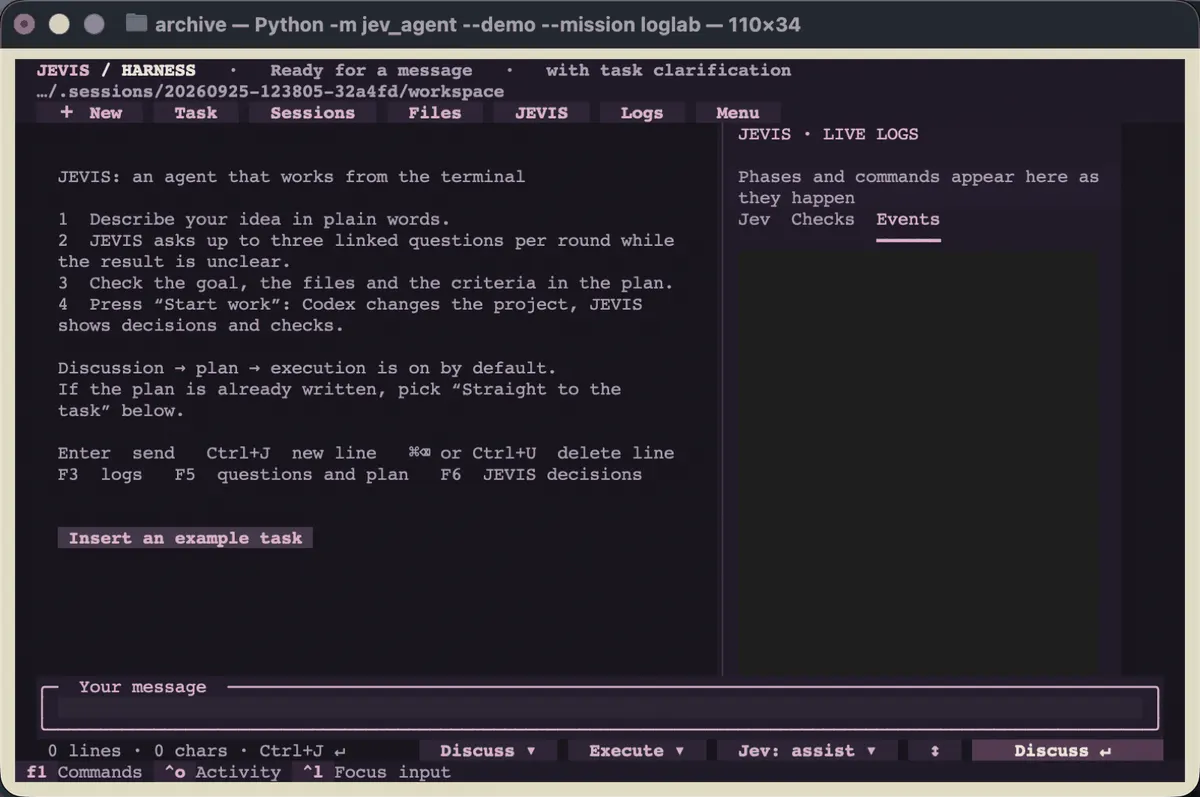
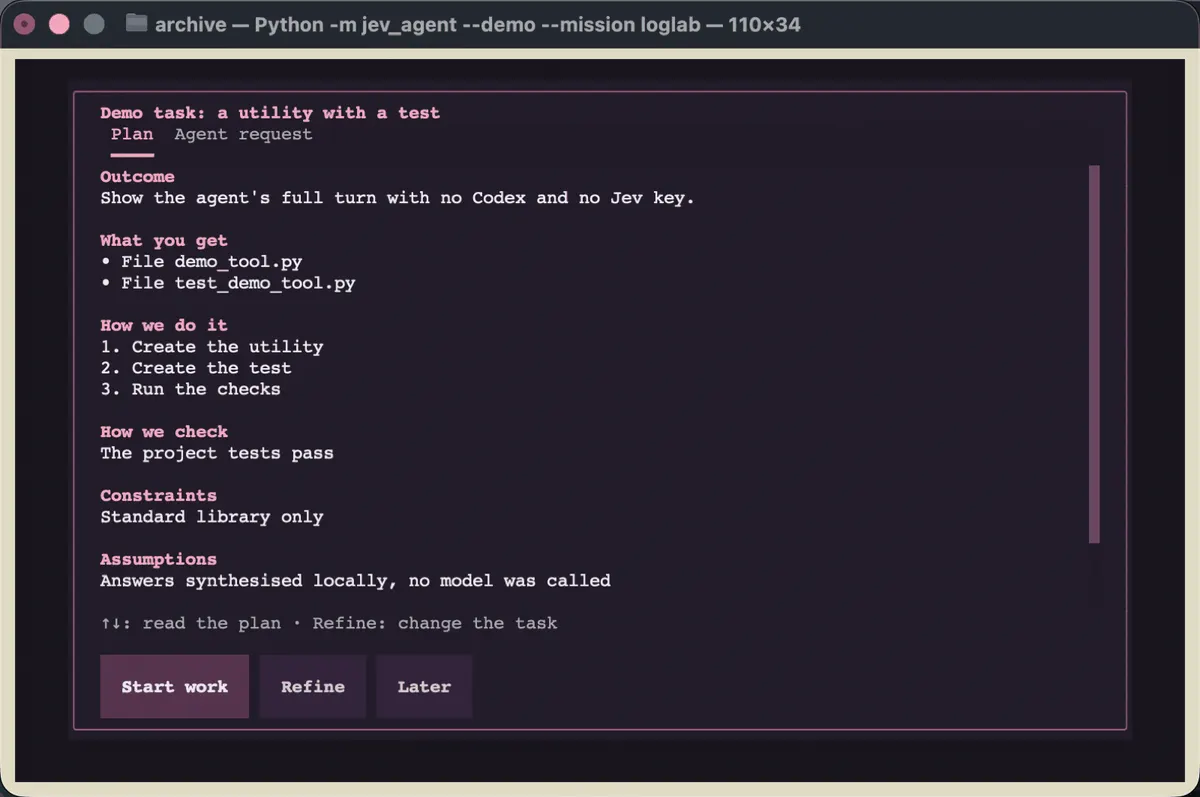
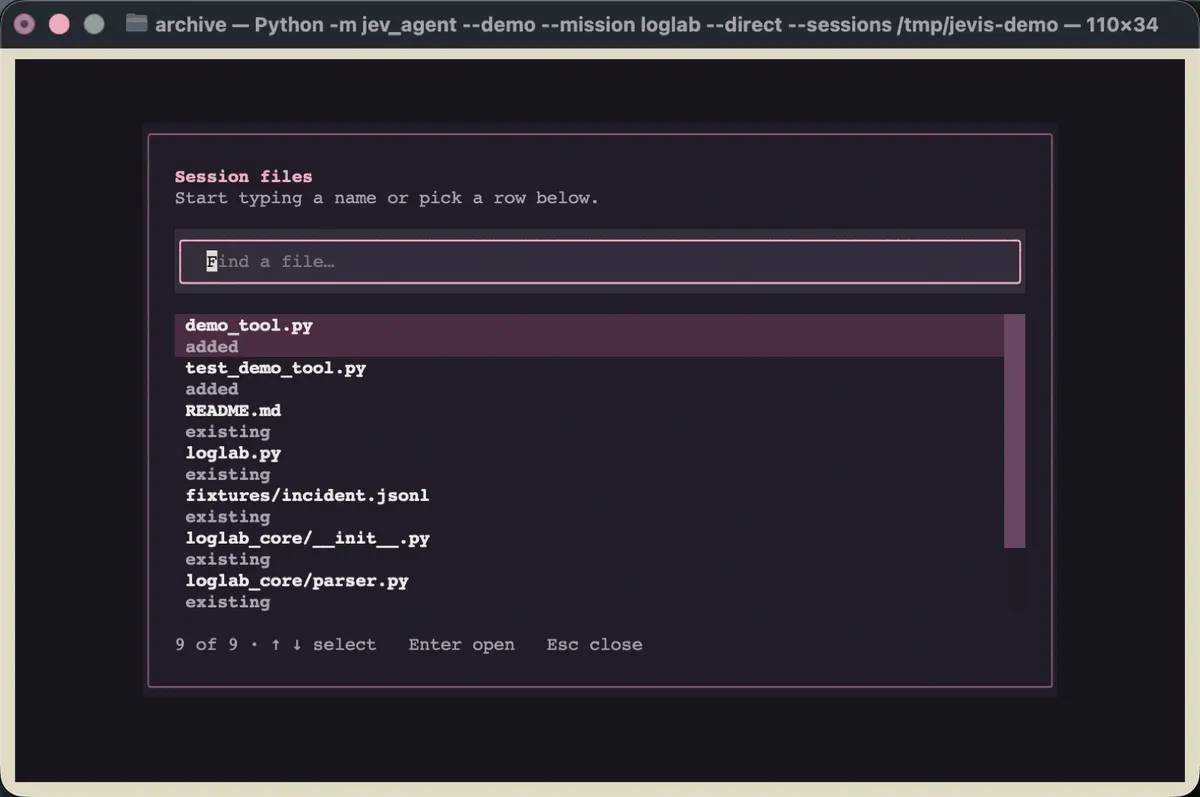
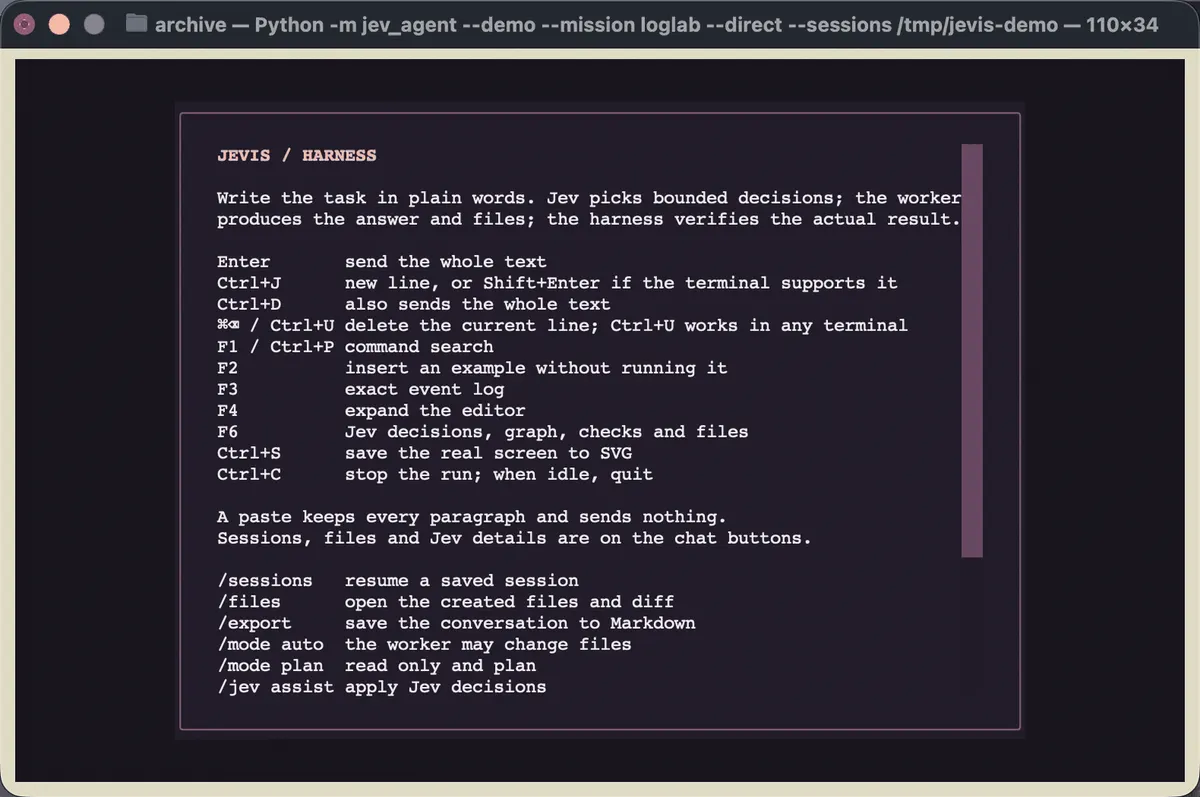
它会问几个问题,写一份计划,然后等。等你按下按钮才开始干活,运行过程中每个检查和每个决定都在屏幕上。
其余的东西都在正文旁边:代码和说明、第一次调用、起步说明、源码核对、结果画廊、VALIDATION.md、GitHub Actions。