阿里开源了:Open Code Review 代码评审助手
一、它和「用 Claude Code 顺手做评审」差在哪
如果你用 Claude Code 之类的通用 agent 评过代码,大概率遇到过这三种毛病,README 里也直接点了名:
- 覆盖不全:改动一大,agent 就开始偷懒,只挑几个文件看,剩下的悄悄跳过;
- 位置漂移:报告的问题和实际代码位置对不上,行号、文件名飘走;
- 质量不稳:纯靠自然语言驱动的 skill 很难调试,提示词改几个字结果就变。
根因是同一个:纯语言驱动的架构,对评审流程没有硬约束。
Open Code Review 的做法是把流程拆成两半,各干各的:
该确定的事交给代码。 选哪些文件看、过滤哪些不看,由工程逻辑决定;相关文件打成一个评审单元(README 举的例子是 message_en.properties 和 message_zh.properties 捆在一起),每个单元跑一个上下文隔离的子 agent,大改动集上不会崩,还天然支持并发;规则匹配用模板引擎按文件特征挑,比「在提示词里让它记得查 XSS」稳得多。另外还有独立的评论定位模块和反思模块,专门治「行号飘走」和「这条意见到底对不对」。
该判断的交由模型。 提示词和工具集都是围绕代码评审专门蒸馏的:README 说工具集是从大规模生产数据里的调用链分析出来的(调用频次分布、单工具重复率、新工具对整条链的影响)。
一句话:代码负责「不会错的那些步骤」,模型只负责「需要判断的那些」。
二、装起来跑一遍
前置只有一个:Git ≥ 2.41,它靠 Git 做 diff、搜索和仓库操作。
安装走 npm,装完全局就有 ocr 命令:
npm install -g @alibaba-group/open-code-review(安装脚本、GitHub Release 二进制、源码编译等其他方式见安装文档。)
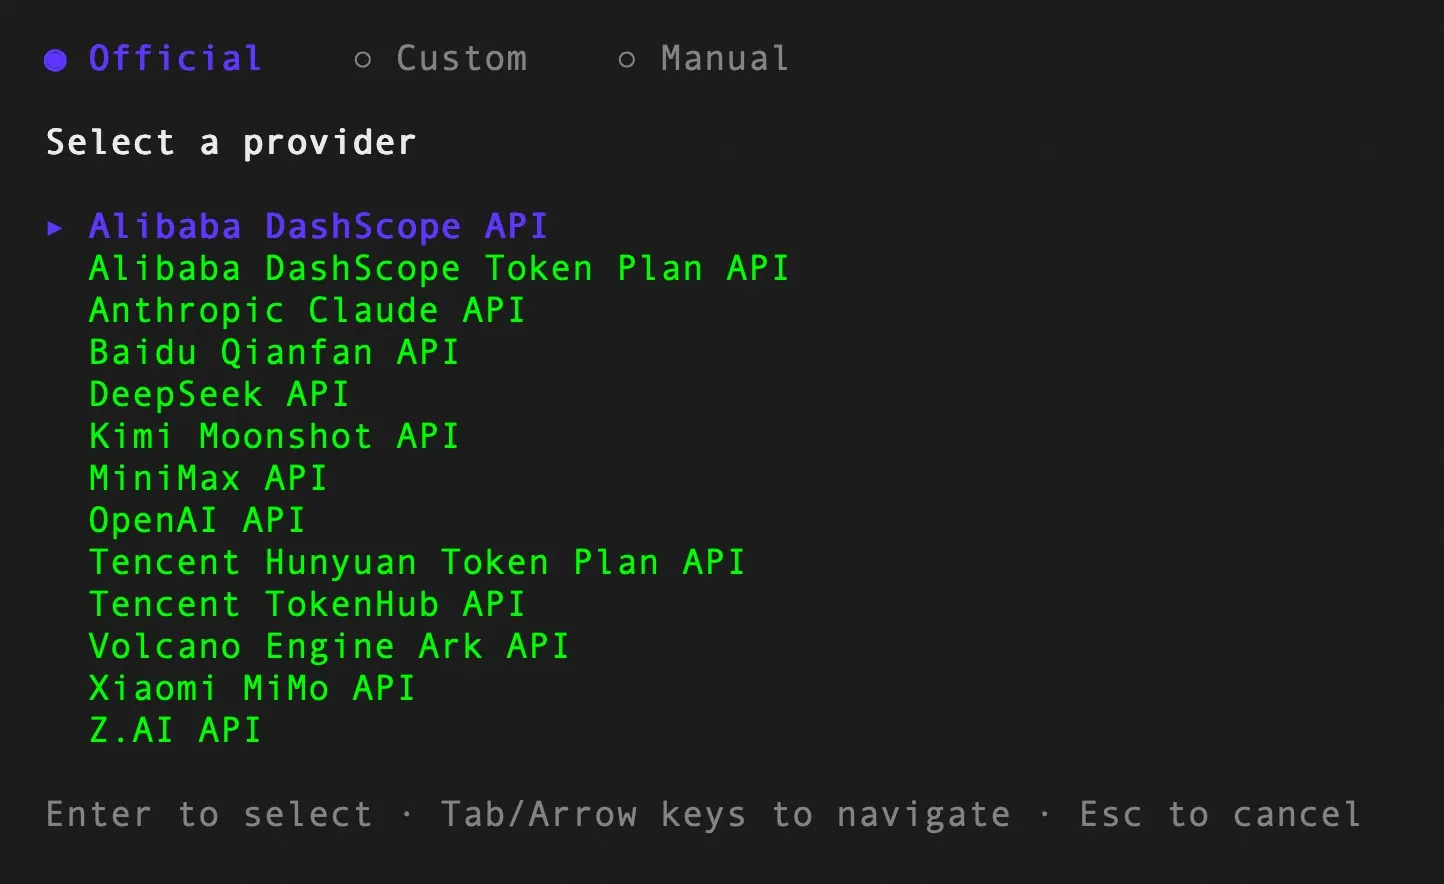
装完第一步是配模型。交互式引导会带你选供应商、填 API Key、选模型,并顺手测一遍连通性:
ocr config provider
ocr config model
它兼容 OpenAI 格式和 Anthropic 格式的接口,所以自建网关、第三方中转也能接。
配好之后,五种常用跑法:
ocr review
ocr review --from main --to feature-branch
ocr review --commit abc123
ocr scan
ocr scan --path internal/agent
第一条是工作区模式,把所有已暂存、未暂存、未跟踪的改动一起评;第二条只评特性分支从 main 分叉以来的改动(merge-base 模式);第三条评单个 commit;后两条是整文件扫描——不需要 diff、不需要 Git 历史,拿来审陌生代码库或历史遗留目录很合适。
| 跑法 | 评什么 | 什么时候用 |
|---|---|---|
ocr review | 工作区全部改动(暂存 + 未暂存 + 未跟踪) | 本地提交前的自查 |
ocr review --from A --to B | 分支从分叉点(merge-base)以来的改动 | PR 评审、CI 里评特性分支 |
ocr review --commit <sha> | 单个 commit | 补审某次提交、复盘问题 |
ocr scan [--path] | 整文件内容,不看 diff | 陌生仓库摸底、遗留代码审计 |
ocr delegate | 只选文件与规则,评审交给宿主 agent | 已有 Claude Code / Codex,只想加结构化 |
另外三个可能比上面更实用的用法:
ocr session list
ocr review --from main --to feature-branch --resume <session-id>
ocr review --format json --output result.json- 评审跑到一半中断了,
session list找到会话 ID,--resume接着跑,不用重头再来一遍(ocr scan也支持--resume); --format json --output把结果落成 JSON,交给上层的 AI agent 或自己的脚本消费;- 还支持 delegation 模式:
ocr delegate preview、ocr delegate rule——只让 ocr 负责选文件和匹配规则,评审本身交给你已经在用的 Claude Code / Codex 去做,不用给它配 API Key。这一点推文里没提,但对不想再买一份模型额度的人挺关键。
三、benchmark 怎么读:数字好看,取舍也写在明面上
官方在 50 个热门开源仓库、200 个真实 PR、10 种编程语言上建了个评测集 AACR-Bench,由 80 多位资深工程师交叉标注出 1,505 个真实问题,数据集放在 Hugging Face(Alibaba-Aone/aacr-bench)。
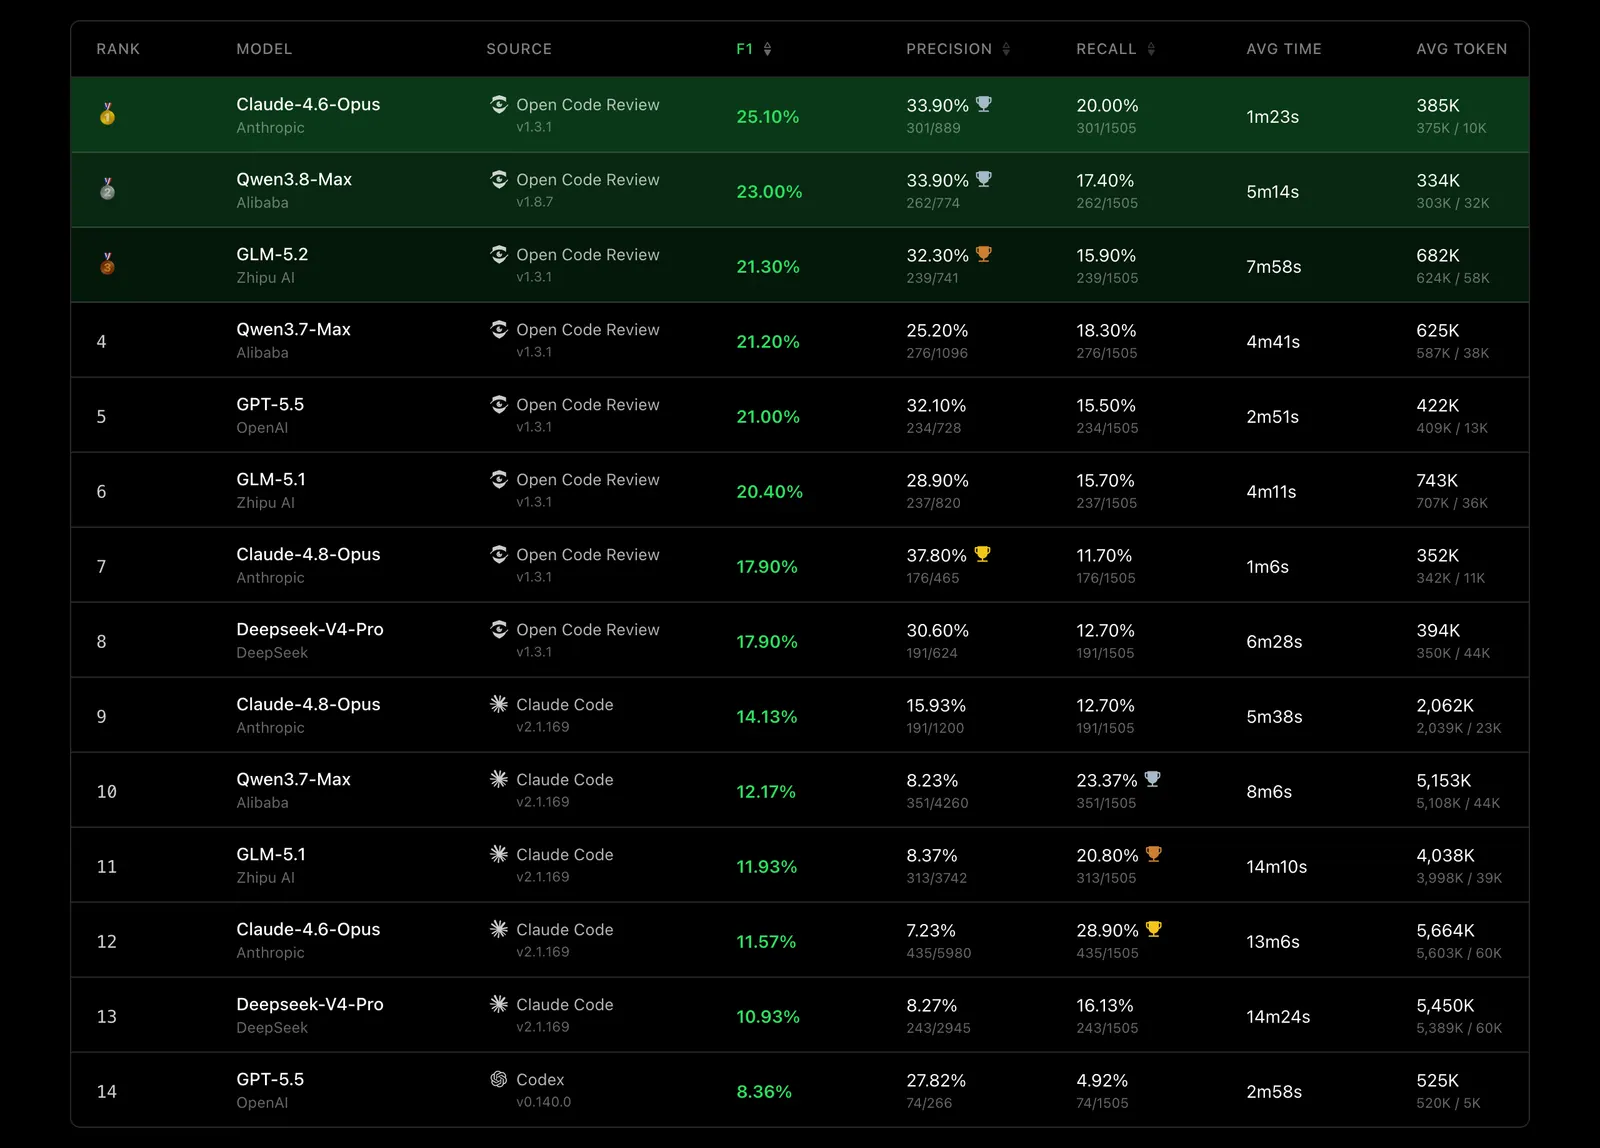
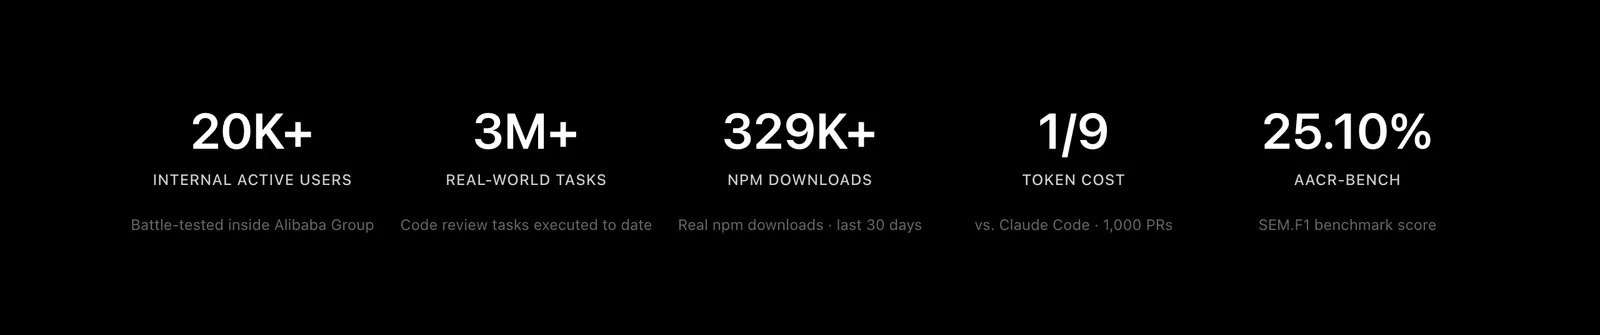
结论是 README 自己写的:同一个底层模型下,精准率(Precision)和 F1 明显高于通用 agent,token 只花约 1/9,评审完成得更快。
但同一段话里还有半句,很多转发都没带:召回率(Recall)比通用 agent 低,这是刻意的取舍——宁少勿吵。
把这句话翻译成日常使用场景:
- 你讨厌 agent 每天提一堆假警报、要你逐条否掉 → 这个设计合你的口味;
- 你指望它当最后一道防线、把漏网的问题都抓出来 → 它明确不保证,人工评审该留还得留。
还有一点得说清楚:这套 benchmark 是项目自己建的、自己跑的,指标口径也由它定义(F1 = 精准率与召回率的调和平均)。这不等于数据造假,但别把它当成第三方独立评测来引用。
四、能接哪些地方
推文列了集成清单,README 的多几个,按官方口径整理如下:
宿主 agent(插件形式,装完就有评审命令或 skill): Claude Code、Codex、Cursor、Kimi Code、OpenCode、QCA Forward,以及任何兼容 Agent Skill 的宿主。
CI: GitHub Actions、GitLab CI、GitFlic CI、Gerrit。
模型接口: OpenAI 兼容、Anthropic 兼容。
周边: 有 MCP server(可以把外部工具接给评审 agent 用)、有 Session Viewer(浏览器里回放评审过程,把已修/忽略的评论藏起来继续干活)、有 OpenTelemetry 遥测。
五、仓库现状(2026-10-28 现查)
| 项目 | 数据 |
|---|---|
| 仓库 | alibaba/open-code-review |
| 星数 / Fork | 48,546 / 3,553 |
| 主语言 | Go |
| 许可证 | Apache-2.0(Copyright 2026 Alibaba) |
| 最新版本 | v1.13.3(2026-10-22) |
| 创建时间 | 2026-05-18 |
| 最后推送 | 2026-10-22 |
| 未关闭 issue / PR | 358 |
| 其他 | OpenSSF Best Practices Gold 徽章、Trendshift 榜上有名、中英日韩俄五语 README |
五个多月冲到 4.8 万星,说明这波关注度是真的;GitHub 上 358 个未关闭的 issue 和 PR 也说明社区提问题比维护者清得快,用之前挑一个稳定版本、别追 HEAD。
六、用之前要知道的五件事
- 不配模型就没有评审结果。 除 delegation 模式外,第一次用必须先
ocr config provider+ocr config model,否则ocr review跑不起来。 - Git ≥ 2.41 是硬要求。 低版本会在 diff 生成、代码搜索环节出问题,不是「可能有点小毛病」,是直接不工作。
- 召回率低是设计,不是 bug。 官方明说宁少勿吵,所以「它没报」不等于「这里没问题」。
review看改动,scan看全文件。 想让它理解上下文,scan该用就用——只跑 diff 的话,跨文件的逻辑问题它只能靠顺带读到的那点内容判断。- 接进 CI 优先用 JSON 输出。
--format json --output result.json是官方推荐的给宿主 agent 消费的方式,比解析终端文本稳。
还有一个工程上的选择值得注意:大改动集会被拆成多个子 agent 并行评(按文件相关性分块、每块独立上下文)。好处是稳定和快,代价是跨块的问题(比如 A 文件改了接口、B 文件没跟上)需要靠「读取其他改动文件」这个能力补,真遇到这类问题,scan 比 review 更靠得住。
七、适合谁,不适合谁
适合:
- 团队 PR 量大、评审人手不够,想要一个「不吵人」的第一道筛子;
- 已经在用 Claude Code / Codex / Cursor,想加一层结构化的评审(走 delegation 模式最省);
- 老代码库没人敢动,先用
ocr scan整文件扫一遍摸底; - 需要把评审结果接进 CI 流水线,输出结构化 JSON。
不适合:
- 想找「一个工具替你完成评审」:它自己说了召回率低;
- 代码不能出内网:命令行工具本身能内网跑,但你得自己配内网模型;
- 只看星数就上生产——刚开源五个多月、未关闭 issue 与 PR 共 358,先在非关键仓库上试。
八、五分钟上手清单
git --version
npm install -g @alibaba-group/open-code-review
ocr config provider
ocr config model
cd your-project
ocr review
ocr review --from main --to feature-branch
ocr scan --path internal/agent
ocr review --format json --output result.json
第一遍建议先在一两个不太重要的仓库上跑 ocr review,把输出和人工评审对一遍,看看它挑出来的问题你认不认、漏掉的你介不介意。一个评审工具值不值得留,取决于你对「它漏的那部分」的容忍度,这一点任何 benchmark 都替不了你。
仓库在 github.com/alibaba/open-code-review,文档在 open-codereview.ai/docs。