Jev:给大模型装一个「第二大脑」,十二个可以插进去的位置
一个便宜的「第二大脑」替它做判断,昂贵的模型可以回去思考和写作。
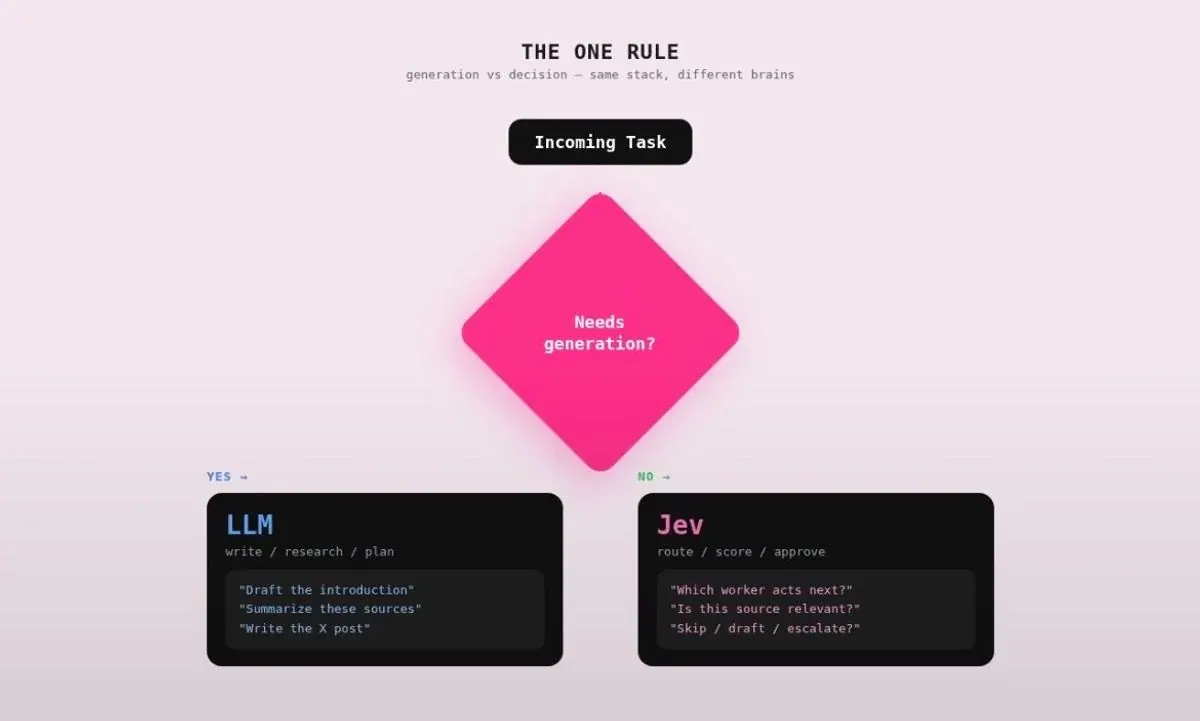
打开任何一个已经上线的 agent 的日志,都会看到大批前沿模型的 token 花在这些问题上:这条消息是垃圾吗?接下来该哪个 worker 跑?这份草稿够不够格给人看?我们是动手、等着,还是往上抬一级?
这些都不是写作任务。它们是有已知答案的分叉,而一个以写作为长的模型逐段推理它们,慢、贵、还话多。
Jev 是 TypeSafe AI 公开发布的第一个模型,就是为循环里的这一半存在的。
这是一份给开发者看的使用指南:它是什么、该怎么想它、以及九个能放它的地方。
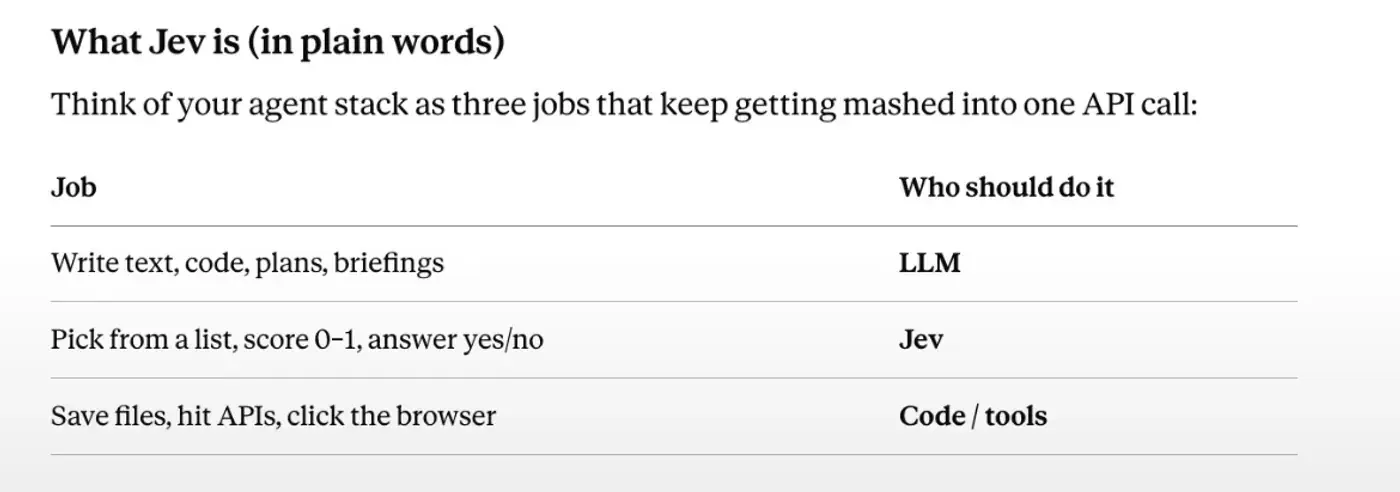
一、三个活,一次 API 调用
大多数 agent 栈把三件不同的活塞进一次调用。拆开是这样:
- 创作(调研、起草、解释)→ LLM
- 挑选、打分、把门→ Jev
- 真的去做(点、发、存)→ 代码
守住这条分工,账单、延迟和失败模式都会变得好推算一些。
二、Jev 到底是什么
TypeSafe 把 Jev 称为「System One」模型。它接收非结构化状态作为输入,返回带类型、受 schema 约束的决策,附校准过的概率;采样是并行做的,不是一个 token 一个 token 地吐。它不生成文本。
TypeSafe 报出来的响应时间大约 70 到 500 毫秒,并声称相对同类 LLM 工作流有 20 到 200 倍的速度优势和 40 到 400 倍的成本优势。这些是厂商自己的数字,要拿你自己的数据去验。
在生产里,让它有用的是 confidence 这一层。每个决策都带一个置信度估计,于是软件可以在置信度高时直接动手,在不高时往上抬一级。90% 和 55% 应该是两回事,你的代码可以据此分叉。
三、能不能用:访问现实核查
发布那一周,访问政策变得很快。TypeSafe 在 9 月 20 日对所有人开放注册,送 5 美元额度;9 月 22 日因为需求太大暂停了新注册,已有账号继续可用。到 9 月 25 日,它首页上仍然只有一个登录链接。
两条绕行路线:
- Vercel AI Gateway。Vercel 把 Jev 加了进去,模型名
typesafe-ai/jev,不用排队,还能选零数据保留。 - 盯 TypeSafe 的 X 账号等重开。以那里为准,我写的任何东西今天都可能过期。
Jev 是闭源的托管 API,跑不到本地。
四、心智模型:Choice、Score、Noul
三种问题类型覆盖了大部分闸门:
- Choice:从一个带标签的选项里挑一个(哪个队列、哪个动作)。
- Score:在一个有序刻度上打分(紧急度、质量)。
- Noul:是/否,带置信度(可以继续吗?)。
两条规矩能帮你省钱,也能少走错路:
- 把策略写进 instructions 和选项文本里。 Jev 猜不出你的字段名是什么意思。
- state 里放证据,不放结论。 传
last_error、找到的来源、消息片段;别传"research_done": true。
一个工单分流器长这样。形状只作示意,我没有拿真 key 跑过,属性名以当前 SDK 文档为准:
from typesafe_sdk import Choice, Score, Noul

state = {
    "ticket": ticket_text[:1500],
    "plan": "enterprise",
    "prior_tickets_30d": 3,
}

result = client.system_one(
    state=state,
    questions={
        "team": Choice(
            instructions="Route to the right team.",
            criteria={
                "billing": "Charges, invoices, refunds.",
                "engineering": "Bugs, outages, errors.",
                "support": "How-to questions.",
            },
        ),
        "urgency": Score(
            instructions="How urgent is this for the customer?",
            labels=["low", "medium", "high", "critical"],
        ),
        "needs_human": Noul(
            instructions="This ticket should be read by a person before any reply."
        ),
    },
)
一次调用回来三个答案,你的代码对它们分叉。
五、上线前的护栏
confidence 是信号,不是保证。这几样从第一天就该有:
- 每个决策一条置信度下限。 低于它,抬给更大的模型或者人。下限要在你自己的标注样本上校准。
- 代码里的硬上限。 限制每次运行的工具调用次数和花费。
- 每个动作之后保存进度,重试时不会把副作用再做一遍。
- 不可逆的事一律留人工闸:发布、删除、付款、发送。
- 结果复核。 流程说「做完了」之后,去验证它真的发生了。
这个模式是一致的:Jev 判断要不要往下走,代码执行,人负责不可逆的那几步。
六、从这里开始有意思
分类是个无聊的 demo。有意思的部分是,你开始把一天里每一个分叉都看成「状态 + Choice / Score / Noul」。
下面是操作手册里的十二个用例,每个都写成一个小故事,给出具体的 state,另加三个我们内容台真正在用的流程。
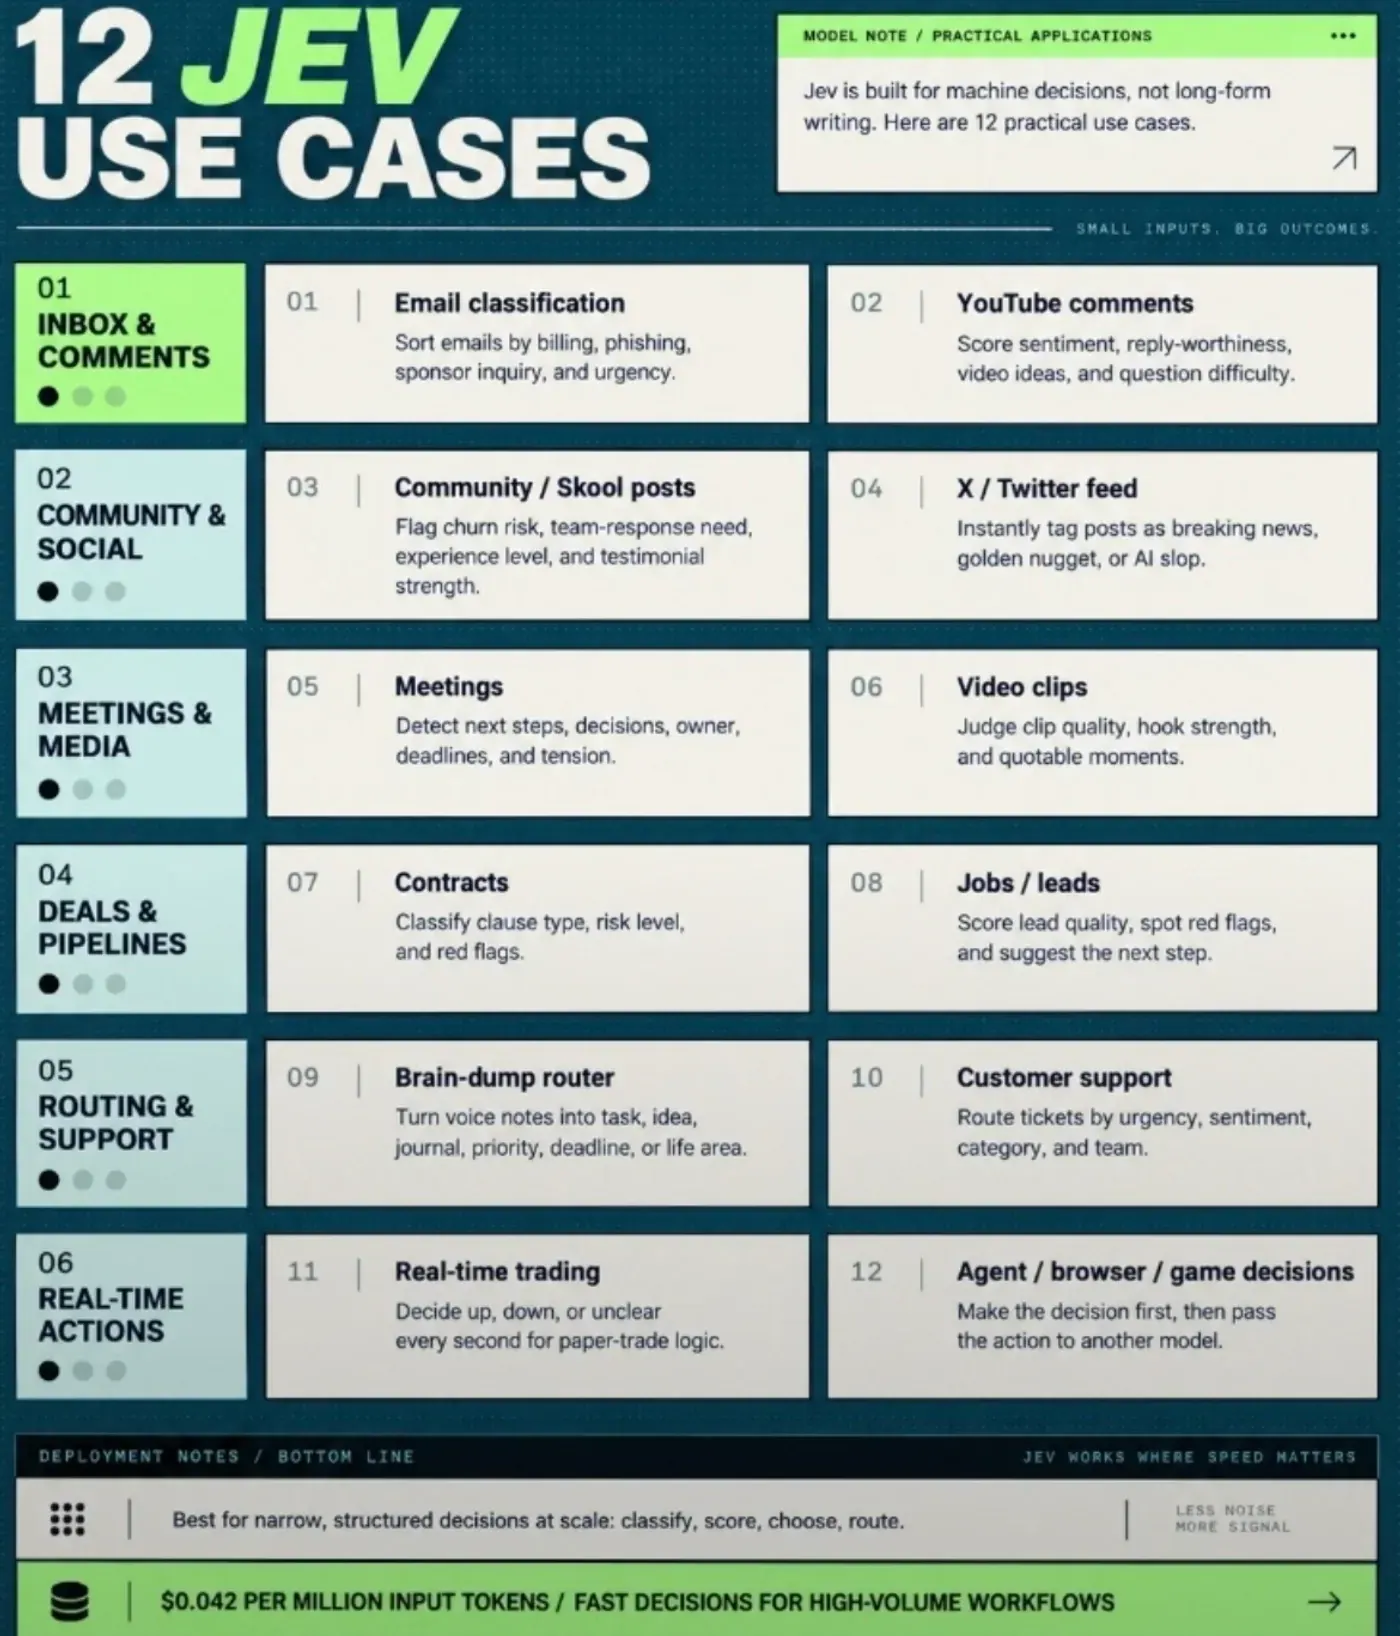
01 · 邮件分诊:账单、钓鱼、赞助、紧急度
你的收件箱不是一个队列,是四个活戴着同一个主题行。一封「发票逾期」的信,可能是真账单,可能是钓鱼的仿冒,可能是带假紧迫钩子的赞助提案,也可能是一个当天就要回复的合作伙伴。
把裁剪过的邮件喂给 Jev:头部 + 前若干字符 + 你在代码里已经算好的发件人信誉标志。并行地问:
- Choice:billing / phishing / sponsor / personal / ops
- Score:紧急度 low → critical
- Noul:looks_like_credential_harvest
状态长这样:
{
  "from": "billing@vendor-lookalike.tld",
  "subject": "Action required: invoice #4412",
  "body_excerpt": "Click here to avoid suspension…",
  "spf_pass": false,
  "known_vendor_domain": false
}
代码把「钓鱼且高置信」直接丢进隔离文件夹,根本不用叫醒 GPT-5。真账单加高紧急度送去财务。低紧急度的赞助进每周批处理。只有当 Choice 说这个线程值得回的时候,LLM 才动手写回复。
02 · YouTube 评论:情绪、值不值得回、选题、难度
评论是金矿也是时间黑洞。大部分是噪音。少数是产品反馈,少数是能拍成后续短视频的好问题,还有少数是坑。
state 可以是评论文本、视频标题和简单的互动数据。问题:
- Score:情绪
- Noul:worth_a_creator_reply
- Choice:ignore / heart / public_reply / save_as_video_idea
- Score:question_difficulty,如果是问题的话
具体的例子:一条系统设计视频下面,有人评论「等等,你的队列是怎么做的,重启不会丢任务?」,40 个赞——大概率值回、也值当选题。一条「沙发!」零信号,进 ignore。只有第一类,LLM 才去起草公开回复;Jev 已经先决定这些 token 值不值得花。
03 · 社区 / Skool 帖子:流失风险、要不要回、经验层级、证言
社区帖子是预警系统。有人悄悄写「我卡了两周,没人回」,和一个新人问「入门文档在哪」,不是一回事。
state:帖子正文、成员时长、之前没被回复的次数、角色。问:
- Score:churn_risk
- Noul:needs_team_response_today
- Choice:beginner / intermediate / power_user(经验层级)
- Score:testimonial_strength,当帖子是夸奖的时候
高流失 + 今天要回 → Slack 敲社区负责人。强证言 → 进 CRM 摘录队列(公开引用前仍然要人批)。LLM 可以起草回复的语气;Jev 决定这条回复今天该不该在清单上。
04 · X/Twitter 时间线:突发、干货、AI 垃圾
你的时间线是个消防水龙头。你不需要 LLM 去总结每一条,你需要一个闸,标出这条帖子配得上哪种注意力。
state:帖子文本、作者、粉丝数、是否在你的观察名单、互动速度。问题:
- Choice:breaking_news / golden_nugget / ai_slop / normal / skip
- Score:signal_quality
- Noul:worth_bookmarking
一条内容空洞的「改变一切的 10 个 AI 工具」串、配着转了好几手的截图,拿 ai_slop,死在过滤器里。观察名单上一位研究者的、干巴巴的一手资料帖,可能落成 golden_nugget,打开一条草稿笔记。高互动速度的突发新闻唤醒另一个只负责收集来源的 worker——依然不自动发帖。
05 · 会议:下一步、决定、负责人、截止、火药味
逐字稿很长。价值在五个结构化字段,不在又一篇总结散文。
会后,state = 逐字稿分块,或者你那个记录工具吐出的原始要点。问:
- Choice(多轮或逐条):这是 next_step、decision、parking_lot,还是噪音?
- Noul:owner_was_explicitly_named
- Score:deadline_clarity
- Score:interpersonal_tension(这样在机器人给任何人发邮件之前,人会先看过火药味重的那几条)
例子:「Alex 周五前把定价页上线」变成一条 next step,负责人 Alex,截止清楚。「我们是不是该找个时间重新想想 onboarding」变成 parking lot,截止清晰度很低——不会凭空造出一个 Asana 任务。张力高 + 要发公开 Slack → 人工闸。
06 · 视频素材:片段质量、钩子强度、可引用金句
把长视频翻拍成短片,大部分工作是过滤。剪辑师会花几个小时去找钩子,而这个活便宜模型可以先打一遍分。
state:片段窗口的逐字稿、你已经提取好的响度/场景变化特征、时长。问题:
- Score:clip_quality
- Score:hook_strength(前 3 秒)
- Noul:contains_quotable_line
- Choice:reject / shortlist / editor_review
只有进了 shortlist 的片段才让 LLM 去写标题和封面文案。被拒的片段永远碰不到贵模型。最终剪辑还是剪辑师在做——Jev 只是把垃圾堆清空了。
07 · 合同:条款类型、风险、红旗
律师(以及创始人兼律师)第一遍不需要模型重写整份 MSA。他们需要分诊:这是什么条款、有多辣、今晚该不该有人读它。
state:条款文本、合同类型、对方规模、如果能拿到就加上司法辖区标志。问:
- Choice:payment / liability / ip / termination / other
- Score:risk
- Noul:contains_red_flag_language(无限责任、意外的自动续约、奇怪的管辖地等)
高风险 + 红旗 → 标出条款,抬给律师。低风险的付款样板 → 归档走人。在 Jev 判定这条值得解释之后,LLM 再用大白话解释一遍。
08 · 招聘 / 线索:质量、红旗、下一步
入站是不对称的:大部分消息是来试水的,少数是真预算但语法很差。
state:表单字段或者私信文本、公司规模的线索、来源、有没有提预算和时间线。问题:
- Score:lead_quality
- Noul:has_red_flags(白嫖范围、「曝光换合作」、只用加密货币这类怪东西——按你的台子自己定义)
- Choice:ignore / nurture / book_call / send_case_study
只有高过你置信度下限的 book_call 才能拿到日程链接。其余的发模板,或者不回。这条和下面的创始人台案例配套使用。
09 · 想法倾倒路由器:语音备忘归到生活区块
你一边走路一边录了两分钟语音。Whisper(或任何 ASR)给出文本。然后呢?大多数人粘进备忘录,然后就丢了。
state:逐字稿 + 时间点 + 可选的「我在工作模式」标志。问题:
- Choice:task / idea / journal / errand
- Score:priority
- Noul:has_deadline_signal
- Choice:work / health / family / money / creative(生活区块)
例子:「提醒我周四之前把发票发给 Nova,另外我一直觉得 onboarding 视频应该用失败案例开场」——拆成两条:一条带截止信号的高优先工作项,一条没有截止的创意。你的任务应用和灵感箱保持干净,不用手工分拣。
10 · 客服:紧急度、情绪、分类、团队
所有工单都是 P1 的时候,支持队列就死了。Jev 干的是人以前用宏做的第一遍。
state:工单文本、套餐档位、账号年龄、历史工单数。问题:
- Score:urgency
- Score:sentiment
- Choice:category(billing / bug / how_to / abuse)
- Choice:team(L1 / billing / eng_oncall)
愤怒的企业账单问题和免费用户平静的「怎么弄」走的是两条路。不确定的工单(置信度低于你的下限)抬给更大的 LLM 或者人——和后面那套审核级联是同一个模式。
11 · 实时交易:每秒判涨、跌、不清
这个最容易浪漫化,也最容易炸。当成纸面交易逻辑和研究来做,别当成 alpha 的承诺。
每一秒(或每根 bar),state = 你已经信得过的那几个特征:收益率、点差、交易时段标志、你自己的指标向量——不是一段凭感觉的描述。问:
- Choice:up / down / unclear
- Score:confidence_band(或者直接用 Choice 的置信度)
- Noul:within_risk_limits_to_act
只有当 Choice 不是 unclear、置信度过你的下限、风险 Noul 为真时,代码才下单(纸面单)。其余一律空仓。重点不是 Jev「预测市场」,而是你的循环不再每分钟叫 60 次聊天模型来说「可能吧」。
12 · Agent / 浏览器 / 游戏里的决策:先决定,再交出去执行
浏览器 agent 和游戏 agent 有一个共同的失败模式:大模型既选下一个动作,又把它讲出来。这等于把 System One 和 System Two 混在一次昂贵的调用里。
模式是:Jev 看 state(DOM 摘要、背包、目标、上一个错误),在合法动作菜单上返回一个 Choice。再由一个更小的专用模型(或者纯代码)去点、去输入、去走那一步。
{
  "goal": "Find a refundable flight under $400",
  "url": "https://example-airline/search",
  "visible_actions": ["click_filter", "type_destination", "submit_search", "back", "stop"],
  "last_error": null
}
Jev 选 type_destination,另一个模型填字段。Jev 选 submit_search,代码来点。你把生成从决策路径上拿掉。正经的浏览器栈演示多时的便宜控制循环,干的就是这件事。
七、工作台上真正在跑的流程
上面十二个是地图。下面这三个是我们内容台和创始人台上真在用的路线。
F · 病毒式传播 / 内容台的门
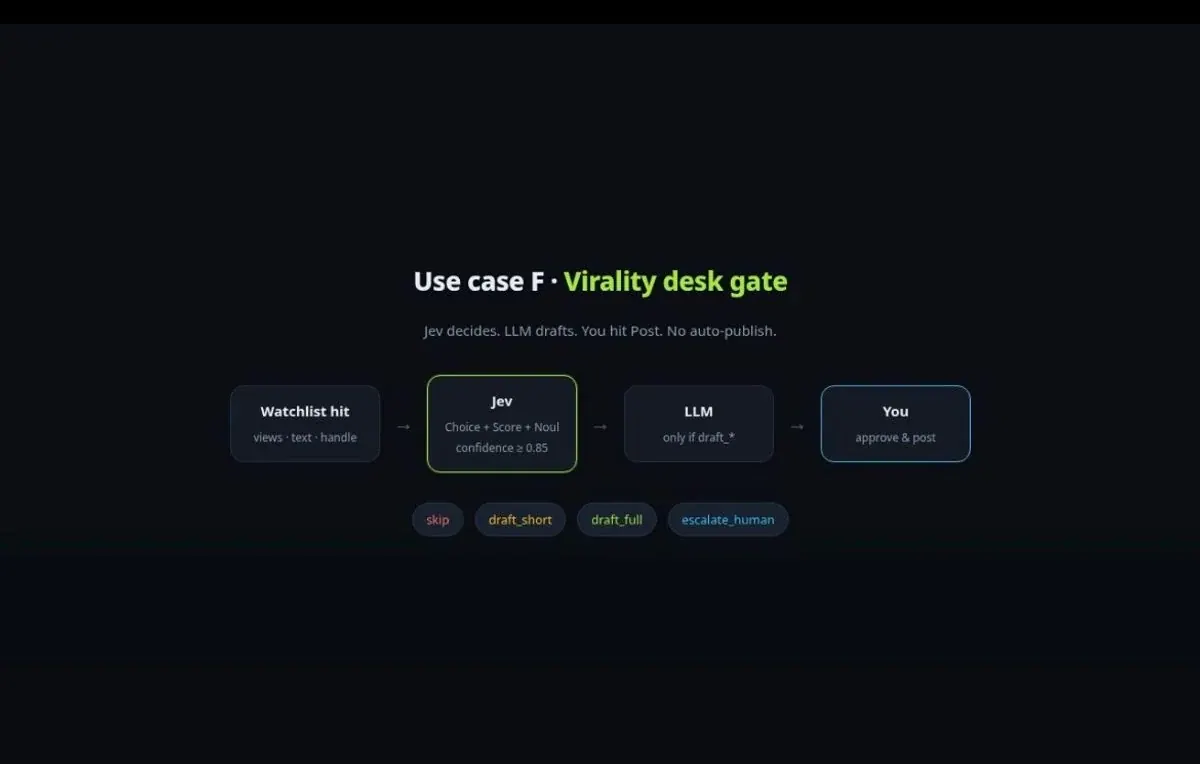
在你的写手为一个回复或引用帖烧 token 之前,先过一道闸。状态长这样:
state = {
    "post_text": original[:2000],
    "views": views,
    "likes": likes,
    "author": handle,
    "watchlist": True,
    "floor_views": 5000,
}
三个问题:Choice 在 skip / draft_short / draft_full / escalate_human 里选;Score 打 viral_fit(低 → 高);Noul 判断 safe_to_engage_without_human,默认 false,也就是交给人。
低于浏览底线或者不在观察名单 → skip。很契合 → LLM 起草一条短回复或长回复,放进待审文件夹,你按下发布。
Jev 决定,LLM 写,人来发。这条是常设规矩,在这个账号上不容商量:绝不自动发到 X。
G · AI 创业者的线索 / 入站评分
私信和表单填写看上去都一样,直到它们不再一样。把消息、来源、以及任何公司画像的碎屑打包进 state。给紧急度和线索质量打分;Choice 在 ignore / nurture / book_call 里选。
只有高置信的 book_call 打开日程路径,其余的发培育模板,或者不回。你的贵模型在闸后面写那条定制回复,而不是替掉这道闸。
H · 支持 / 货到付款 / 评论审核的三级分流
第一遍是 Jev:垃圾是/否、类别 Choice、毒性 Score。确定的垃圾 → 代码删掉或隐藏。灰区(置信度低于大约 0.85,或信号互相矛盾)→ 更大的 LLM 或者人。清清楚楚的「我怎么重置密码?」→ 宏回复。
这和人们在钓鱼邮件分诊上演示过的是同一套级联:前面一道便宜的闸,贵模型只碰模糊的那一片。审核要快,又不能因为一个自信的误报就把真客户干掉,靠的就是这个。
八、成本现实(别照抄 demo)
开发者们引用的 TypeSafe 公开价格:输入大约每百万 token 0.042 美元,输出免费。按每个决定约 1k token 算,一万个决定大概 0.42 美元。做表格之前先去核当前文档——价格会动。
下面这些是别人公开报出来的(demo 或推文串,不是我们实验室的数字):
- Browser Use + Jev 风格的循环找机票,大约 7 秒、约 0.0039 美元
- 上千篇论文的分类,大约 0.08 美元,中位延迟约 256 毫秒
- 五百封邮件过一遍,三个半美分左右
- 上下文压缩的 demo:一个很大的 Claude 会话,约 1M token 压到约 86k,耗时约一秒
把这些当成「它能做到」的证据,不是 SLA。要盯的是每个完成任务的美元数,不是每次 API 调用的美元数。一个便宜但错误的分叉,订错航班或者删错评论,照样很贵。
九、真正的 alpha
诀窍不在于 demo 快或者账单小,而在于你发现循环里有那么多调用,本来就不需要生成。
让 LLM 去调研、规划、写作。让 Jev 去路由、打分、批准、升级。让代码去执行,带上限、存进度,不可逆的步骤留给人。
这周就从一件重复发生的判断开始。量它的成本和延迟。然后换掉下一个分叉。
文中例子只作示意,价格、访问政策、第三方说法都会变,用之前自己核一遍。不构成专业建议。
觉得有用的话收藏、转发,关注 @beaver_0x 看更多 alpha 和 AI 工具。