大模型学习地铁图:一条主干线,五条支线
很多人想学大模型,卡在第一步:不知道从哪开始。
网上的资料有讲 Transformer 的,有讲 RAG 的,有讲 Agent 的,有讲微调的,有讲 vLLM 的。每一块看起来都重要,放在一起却拼不出一张完整的图。常见的结果是收藏了几十个教程、看了几篇科普,好像什么都懂一点,真被问到「LLaMA 和 GPT-2 到底有什么区别」,又说不清。
问题不在于不够努力,在于缺一张地图。
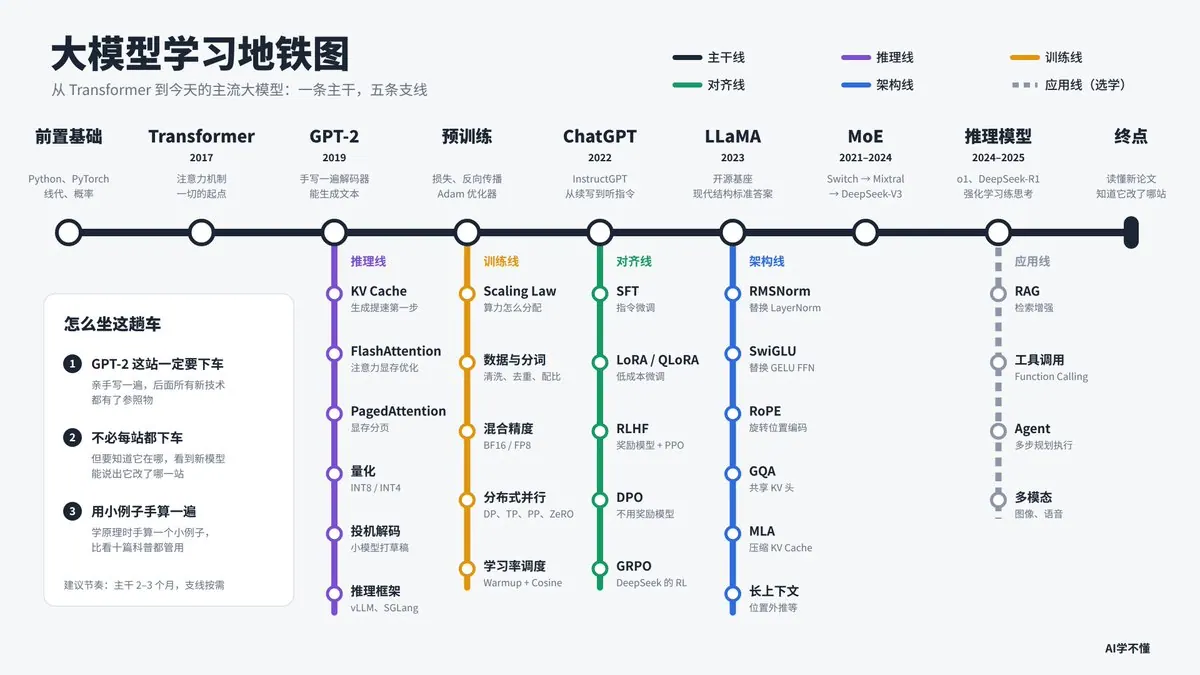
纳米AI 的做法是把整块知识体系画成一张地铁图:一条主干线,五条支线。主干线大家都要坐完,它就是大模型这几年真实的演进顺序;支线按兴趣换乘,不是每个人都要坐一遍。
先看全景
| 线路 | 包含什么 | 谁该坐 |
|---|---|---|
| 主干线(8 站) | 前置基础 → Transformer → GPT-2 → 预训练 → ChatGPT → LLaMA → MoE → 推理模型 | 所有人,坐到底 |
| 推理线 | KV Cache、FlashAttention、PagedAttention、量化、投机解码、vLLM / SGLang | 关心速度和成本的人 |
| 训练线 | Scaling Law、数据与分词、混合精度、分布式并行、学习率调度 | 想搞懂大模型为什么这么贵的人 |
| 对齐线 | SFT、LoRA / QLoRA、RLHF、DPO、GRPO | 想做微调、想看懂 R1 的人 |
| 架构线 | RMSNorm、SwiGLU、RoPE、GQA、MLA、长上下文 | 想读懂新模型技术报告的人 |
| 应用线 | RAG、工具调用、Agent、多模态 | 离落地最近,选学 |
主干线:八站坐到底
| 站 | 时间 | 这一站在讲什么 |
|---|---|---|
| 第 0 站 | 前置 | Python、PyTorch、线性代数、一点概率 |
| 第 1 站 | 2017 | Transformer《Attention Is All You Need》 |
| 第 2 站 | 2019 | GPT-2,亲手写一个 |
| 第 3 站 | — | 预训练:损失函数、反向传播、梯度下降、Adam |
| 第 4 站 | 2022 | InstructGPT 与 ChatGPT,从续写到听指令 |
| 第 5 站 | 2023 | LLaMA,开源大模型的分水岭 |
| 第 6 站 | 2021–2024 | MoE 稀疏专家 |
| 第 7 站 | 2024–2025 | 推理模型:o1、DeepSeek-R1 |
第 0 站:前置基础
需要的东西不多:Python、PyTorch、线性代数、一点概率。
线性代数不用学到数学系的水平,能看懂矩阵乘法、向量点积,知道每一步张量的形状怎么变就够了。PyTorch 只要会搭一个简单的神经网络,理解 tensor、nn.Module、前向传播是什么意思。
这一站最常见的坑是一直停在这里,想先把数学全部补完再出发。其实不用,边学边补效率最高。
第 1 站:Transformer(2017)
论文是《Attention Is All You Need》。今天几乎所有主流大模型都是从这篇论文长出来的。
这一站要搞懂几件事:
- 自注意力在算什么,Q、K、V 分别是什么角色
- 为什么要多头
- 残差连接和 LayerNorm 解决什么问题
- FFN 在每一层里干什么
- 模型本身不知道词的顺序,所以需要位置编码
建议先看图解类文章或视频建立直觉,再回头读原论文。原论文写得很精炼,直接啃容易劝退。
第 2 站:GPT-2(2019)
整条路线最关键的一站,一定要下车。
原始的 Transformer 是编码器加解码器,用来做翻译。GPT 系列只保留了解码器,任务也变得很简单:根据前面的词预测下一个词。
这一站的目标是亲手写一个 GPT-2:从分词、Embedding 到注意力、Transformer Block、堆叠多层,最后加载官方的预训练权重,让它真的生成文本。
为什么强调「亲手写」?因为后面所有所谓的「新技术」,绝大多数都是在 GPT-2 这套结构上换零件。脑子里有了一个能跑的 GPT-2,后面看到任何新模型都能拿它做对照:它改了哪里,为什么改。没有这个参照物,后面的东西只能死记。
第 3 站:预训练
第 2 站加载的是别人训练好的权重,这一站要搞懂这些权重是怎么来的。
核心是四件事:损失函数(交叉熵)、反向传播、梯度下降、Adam 优化器。用这些东西把一个随机初始化的模型训到能说话。
不需要真的花几百万去训一个大模型。在小数据集上把一个小 GPT 从头训起来,看着 loss 一点点降下去,原理就通了。
第 4 站:ChatGPT 时刻(2022)
预训练出来的模型只会续写。你问它一个问题,它可能接着编出三个类似的问题,而不是回答你。
InstructGPT 这篇论文解决的就是这件事:让模型从「会续写」变成「听指令」。方法分三步——先用人工写的问答数据做监督微调,再训练一个奖励模型给回答打分,最后用强化学习让模型往高分方向调整。
ChatGPT 就是这条路线的产物。这一站只要理解整体流程,细节留给对齐线。
第 5 站:LLaMA(2023)
LLaMA 是开源大模型的分水岭。在它之后,大部分开源模型的基本结构都差不多定型了。
拿 LLaMA 和 GPT-2 对比,主体还是那个 Transformer 解码器,但几个零件换掉了:LayerNorm 换成 RMSNorm,FFN 的激活换成 SwiGLU,绝对位置编码换成 RoPE,后续版本还用 GQA 让多个注意力头共享 KV,省显存。
这就是前面说的「换零件」。主干上只需要知道换了什么,每个零件的细节在架构线上展开。
第 6 站:MoE 稀疏专家(2021–2024)
模型越大越强,但计算量也越大。MoE 的思路是:参数做得很多,每个 token 只激活其中一小部分。
FFN 被拆成很多个「专家」,再加一个路由器,决定每个 token 交给哪几个专家处理。总参数量可以很大,每次计算的量却不大。
路线上值得看三个节点:
- Google 的 Switch Transformer,把路由简化到每个 token 只选一个专家
- Mixtral,把 MoE 带进了开源社区
- DeepSeek-V3,总参数 6710 亿,每个 token 只激活约 370 亿
想读懂 DeepSeek 的论文,这一站绕不开。
第 7 站:推理模型(2024–2025)
OpenAI 的 o1 和 DeepSeek-R1,代表了最近一次大的范式变化:让模型先思考,再回答。
模型在给出答案前会生成一长段推理过程。这种能力主要靠强化学习练出来,特别是答案可以自动验证的任务,比如数学和代码。DeepSeek-R1 的论文公开了很多细节,是这一站最好的入口。
终点:能自己读懂新论文
坐完主干不代表什么都会了,但你会有一个能力:看到一个新模型发布,能说出它在哪一站做了改动、为什么这么改、解决了什么问题。
2026 年新出的模型,基本也是在这张图的某几站上继续改进。地图坐熟了,看新东西会快很多。做到这一点,就算真正入门。
五条支线:按兴趣换乘
推理线:关心速度和成本的人
模型训好了,怎么让它跑得快、跑得省?这条线是工程师最容易上手、也最容易找到工作的方向。
- KV Cache:把已经算过的 K 和 V 存起来,避免每生成一个词都从头算一遍
- FlashAttention:重新安排注意力的计算顺序,减少显存读写
- PagedAttention:借鉴操作系统的分页思想管理 KV Cache 的显存,是 vLLM 的核心
- 量化:把模型权重从 16 位压到 8 位甚至 4 位
- 投机解码:让一个小模型先打草稿,大模型批量验证
- 推理框架:vLLM 和 SGLang 把以上技术组装在一起
入口建议从 KV Cache 开始,它最简单,也是后面所有优化的基础。
训练线:想搞懂大模型为什么这么贵的人
- Scaling Law:给定算力,参数量和数据量怎么分配最划算
- 数据与分词:清洗、去重、配比,这部分对效果的影响常常比结构改动还大
- 混合精度:用 BF16 甚至 FP8 训练,省显存、提速度
- 分布式并行:一张卡放不下时,数据并行、张量并行、流水线并行、ZeRO 各自怎么切
- 学习率调度:Warmup 加余弦衰减,大模型训练稳定性的基本功
这条线的实操门槛最高,大部分人理解原理就够了。
对齐线:想做微调、想看懂 R1 的人
- SFT:监督微调,用问答数据教模型听指令
- LoRA 和 QLoRA:只训练一小部分额外参数,单张消费级显卡也能微调
- RLHF:奖励模型加 PPO,也就是 InstructGPT 的方法
- DPO:跳过奖励模型,直接用「好回答和坏回答」的偏好数据训练
- GRPO:DeepSeek 提出的强化学习方法,不需要单独的价值模型,R1 的训练就用了它
想动手的话,LoRA 是性价比最高的入口。
架构线:想读懂新模型技术报告的人
这条线就是第 5 站「换零件」的展开。
- RMSNorm 替换 LayerNorm
- SwiGLU 替换原来的 FFN 激活
- RoPE 替换绝对位置编码
- GQA 让多个头共享 KV
- MLA:DeepSeek 提出的方法,把 KV 压缩到更低维度,进一步省显存
- 长上下文:模型怎么处理几十万甚至上百万 token
学习方法很简单:每个零件都拿 GPT-2 对照,问三个问题——原来是什么样?现在换成什么?解决了什么问题?
应用线:选学,但离落地最近
- RAG:检索增强,让模型回答前先查资料
- 工具调用:让模型调用外部函数和 API
- Agent:让模型自己规划多个步骤、调用工具、完成任务
- 多模态:让模型处理图片和语音
这条线标成虚线,不是因为它不重要,而是它和主干的关系不一样。主干和其他四条支线讲的是模型本身怎么工作,应用线讲的是怎么用模型。
如果目标是做产品,可以较早换乘到这条线。但建议至少坐到第 4 站再来,否则遇到问题时很难判断是模型的能力边界,还是自己用法的问题。
怎么坐这趟车
最后说三点建议。
一、GPT-2 这站一定要下车。 这是整张地图的锚点。手写一遍,哪怕代码写得很笨,后面所有内容都有了参照物。
二、不用每站都下车,但要知道每一站在哪。 五条支线全部学透,是好几个方向的专家才有的积累。普通学习者把主干坐完,再选一到两条支线深入,就已经比大部分人清楚了。
三、学原理的时候,用一个小例子手算一遍。 比如三个词的句子、四维的向量,把注意力从头到尾算一遍。纸上算过一次,比看十篇科普都管用。
时间上,有编程基础的话,主干认真学大约两到三个月。支线按需,没有终点,因为这个领域每个月都在长出新的站。
完整地图放在下面,建议收藏。学到哪一站,回来对照一下自己的位置。
注:原文由 Claude Opus 5.5 辅助撰写。