别逐行读 diff 了:写一个能对 agent 说「不」的检查
agent 走过的每一步你都在读。每个 diff、每次工具调用、每一句「做完了」。
不是因为你爱看,是因为系统里没有别的部件会在它出错时告诉你,只能你来。
那就不叫审查。那叫你就是那把一次只能被一件事拿住的锁。
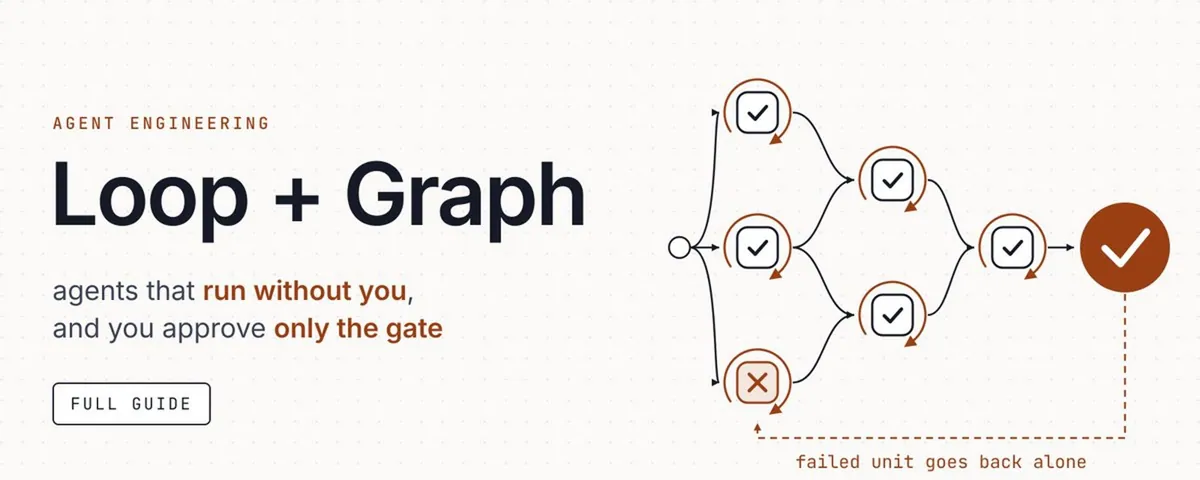
要离开那把椅子,需要两样东西,多数人只做完了第一样。循环让一件活自己修到对为止;图是活的分布:哪些块存在、哪些必须等、哪些能同时跑。两样都有了,你只剩一件事:批准结果。
下面的例子是一个代码库从 JavaScript 搬到 TypeScript,但同样的形状适用于任何 agent 会重复去做的活。
一个前提:这两层都跑在 harness 上——也就是 agent 干活用的工具、沙箱和状态。如果它连类型检查器都跑不了,那就没有检查可写,先修那个。这篇讲的是它上面的两层。
一、循环:干活,加一个能说不的检查
循环有四个动作:产出、检查、纠正、重来。
所有价值都在检查里。
让模型给模型打分,是绕了几步的照镜子。如果审查这份工作的唯一环节,是另一次读它输出的调用,那你没建循环,你建的是一个倾向于同意前一个人的第二意见。
所以检查要在干活之前写好,而且要写成脚本能执行的东西。
算得上检查的:
- 类型检查器以 0 退出;
- 这个单元的测试通过;
- diff 只碰了这个单元范围内的文件;
- 改动前存在的每个导出,改动后还在。
不算检查的:
- agent 宣布它做完了;
- 输出看起来是对的;
- 没有报错——没报错也可能是根本没跑起来。
一个文件的完整检查长这样,用法是 check.sh src/utils/date.ts,只有这个单元真的做完了才退 0:
#!/usr/bin/env bash
set -e
unit="$1"; test_file="${unit%.ts}.test.ts"

npx tsc --noEmit                      # 类型能编译
npx vitest run "$test_file"           # 这个单元的测试通过

changed=$(git diff --name-only | grep -v -e "^$unit$" -e "^$test_file$" || true)
[ -z "$changed" ] || { echo "out of scope: $changed"; exit 1; }
套在外面的循环很短:给 agent 一个单元,跑 check.sh,没过就把失败文本发回去再来一遍,次数设上限,到顶就停下把单元交给真人。一个反复失败的单元,是在告诉你它当初是怎么被定义的,不是在要求你更用力地推。
让检查通过是容易的那一半。手上有一个值得通过的检查,才是这份活。
二、循环修不了什么
循环只能让一个单元变好,就这一件事。
它发现不了「你给它切错了单元」。让 agent 转换整个仓库,它会按自己顺手的顺序过文件,走到某个文件时发现它 import 的东西还没转,于是用 any 把缝糊上。每一步都通过,结果还是错的形状。
调循环没用。问题在活怎么切,不在任何一块里。
人就是在这开始怪模型。图的价值也在这显出来。
三、图:单元和真实的依赖
图有两个部分。
节点是一块有明确输入和明确结果的活。
边意味着一个节点得等另一个把东西交过来才能开始。
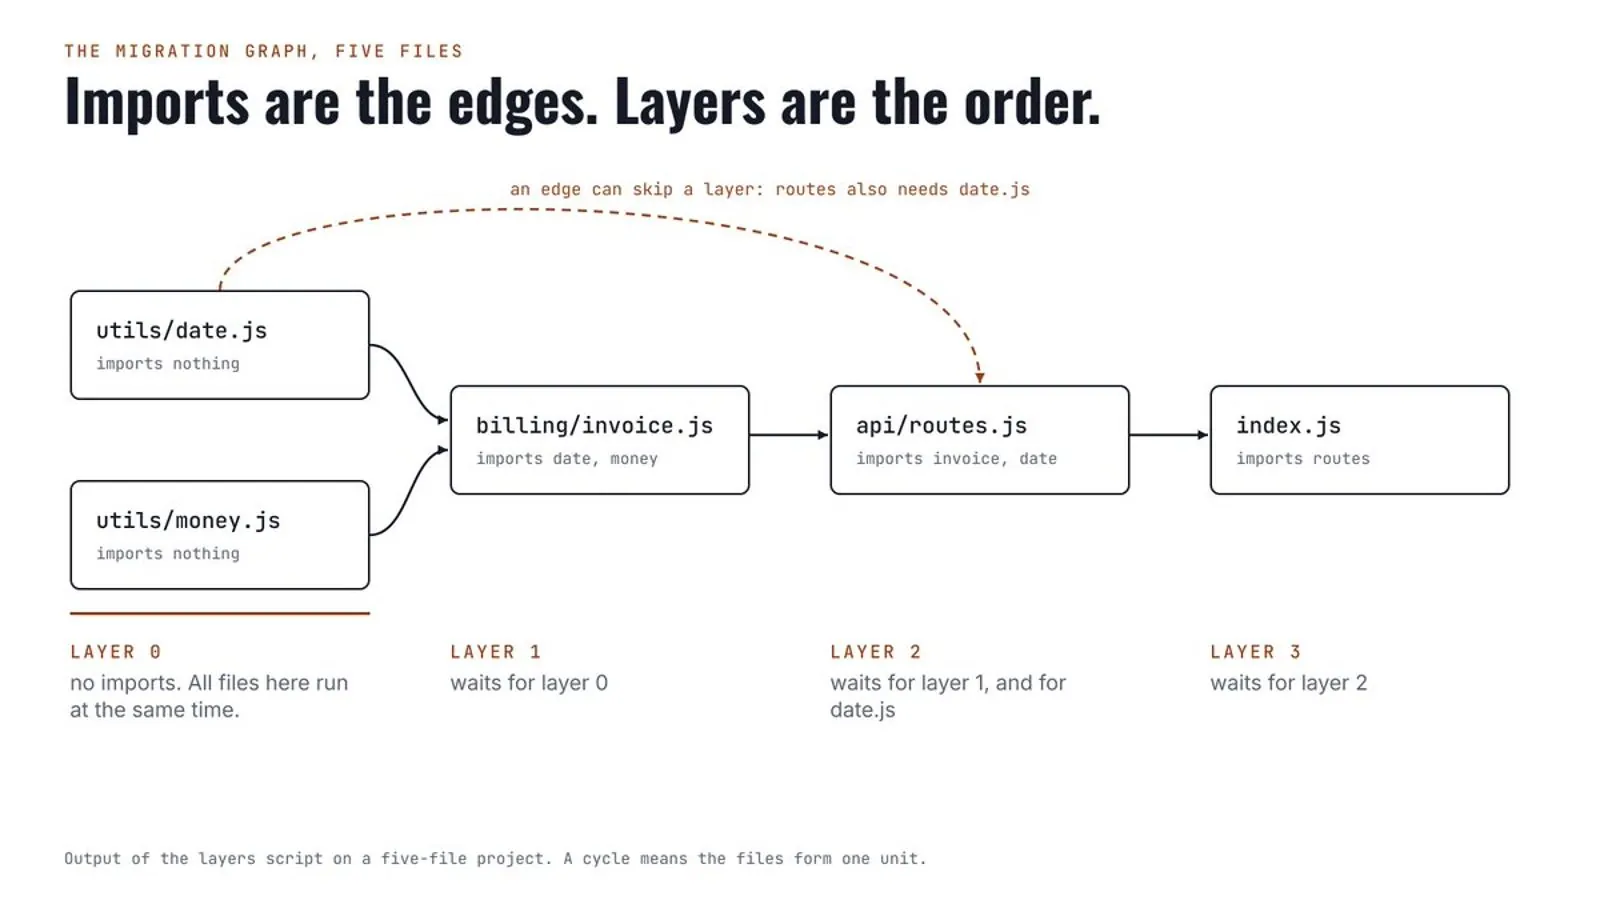
代码库里本来就有一张依赖图,就是 import。一个文件没法被正确标注类型,除非它 import 的文件已经标注好了;所以这次迁移的边就是 import 语句,而这是脚本能找到的,不用写提示:
import re, sys
from pathlib import Path

root = Path(sys.argv[1]).resolve()
files = {p.resolve() for p in root.rglob("*.js") if "node_modules" not in p.parts}
IMPORT = re.compile(r"""(?:from\s+|import\s*\(?\s*|require\(\s*)['"](\.{1,2}/[^'"]*)['"]""")

def resolve(src, spec):
    base = (src.parent / spec).resolve()
    for cand in (base, base.with_suffix(".js"), base / "index.js"):
        if cand in files:
            return cand

deps = {f: {d for s in IMPORT.findall(f.read_text())
            if (d := resolve(f, s)) and d != f} for f in files}

layer, stack = {}, []
def depth(f):
    if f in layer:
        return layer[f]
    if f in stack:
        print("cycle:", " -> ".join(p.name for p in stack[stack.index(f):] + [f]))
        return 0
    stack.append(f)
    layer[f] = 1 + max((depth(d) for d in deps[f]), default=-1)
    stack.pop()
    return layer[f]

for f in sorted(files):
    depth(f)
for n in range(max(layer.values(), default=-1) + 1):
    names = sorted(str(f.relative_to(root)) for f in files if layer[f] == n)
    print(f"layer {n}: " + ", ".join(names))
对一个五个文件的项目跑一遍,它打出:
layer 0: utils/date.js, utils/money.js
layer 1: billing/invoice.js
layer 2: api/routes.js
layer 3: index.js
同一层里的东西可以同时跑,每层等前一层结束。六十个模块的真实代码库,会变成几层,而不是六十步排成一队。
如果脚本打出 cycle:,那几个文件互相依赖,把它们当成一个单元处理。
六十步排成一队是习惯,不是设计。
想找出你自己流水线里哪些箭头是真的,指着其中一个问:交过去的是什么?一个类型、一个导出、一个文件。如果诚实的答案是「什么也没有,只是它在我的清单里排在后面」,那这个箭头就是习惯,这段等待是白等的。
搭的时候三条规矩:
- 每个工人只拿到自己的单元:它的文件、它的测试、它 import 的那些接口签名。不是整个仓库,也不是别的工人的笔记。共享一个窗口的 agent 会收敛到同一批发现,同一个意见你付了好几遍钱。
- 去找隐藏的边:两个文件之间没有数据往来,也可能都要改
package.json或同一个 barrelindex.ts。共享资源要么定顺序,要么指定唯一负责人。 - 模型只用在判断就是活本身的地方:算 import 顺序只有一个正确答案,那就是脚本的活;判断一个含义模糊的函数该怎么标注,才是 agent 值这个价钱的地方。
还有一句:如果你现在还说不出单元是什么,别提前画图。先让 agent 跑一遍,看它做了什么,再照看到的东西画。把一张图硬套在没人观察过的活上,系统只会变脆,不会变安全。
四、各自管哪一段
每个节点里放一个循环,所有节点外面套那张图。
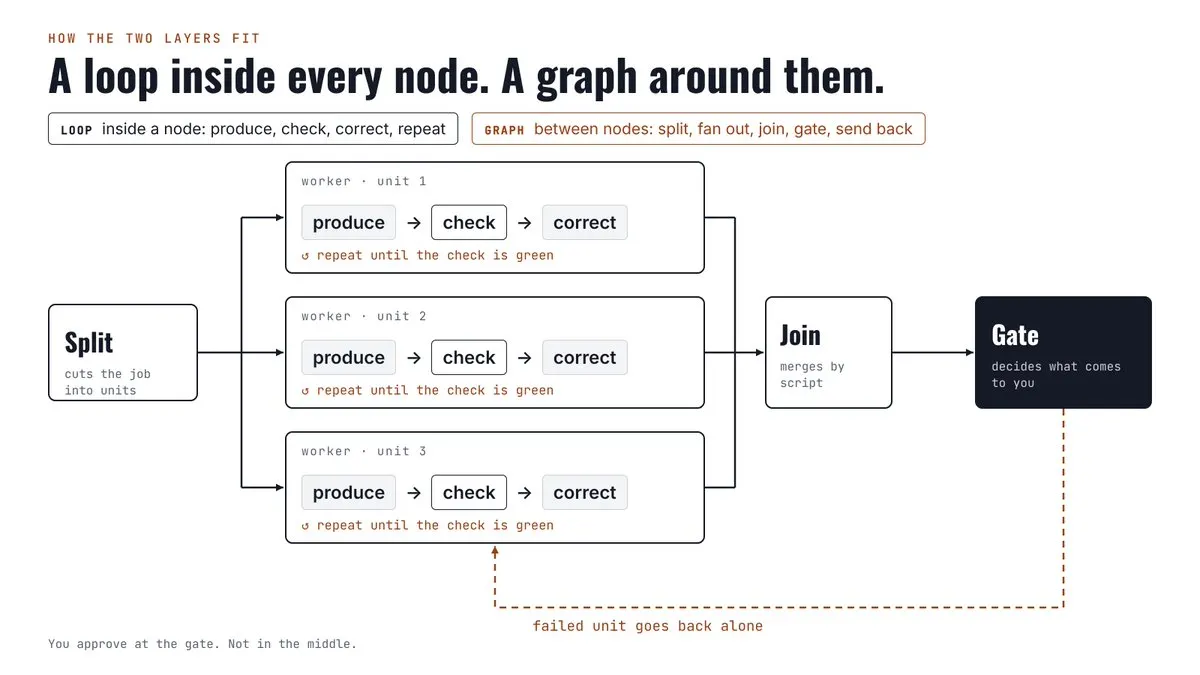
单元内部,活重复到检查通过为止;单元之间,图负责切活、铺开、汇合、把门、退回失败的。哪一层都干不了对方的活。
两个都要。一张节点不受检的图,是用更高产量、更快速度生产错的东西;一个没有图的循环,是没人计划过的一串步骤里被磨得很亮的一步。
五、单元挂了,就只退那个单元
四十个文件里有一个测试没过。最想做的动作是把整批打回去。
别。另外三十九个好好的文件会被重写,新版本不一样,也没更好。接着四十个全要重测,还有几个会失败,原因跟第一次失败毫无关系。
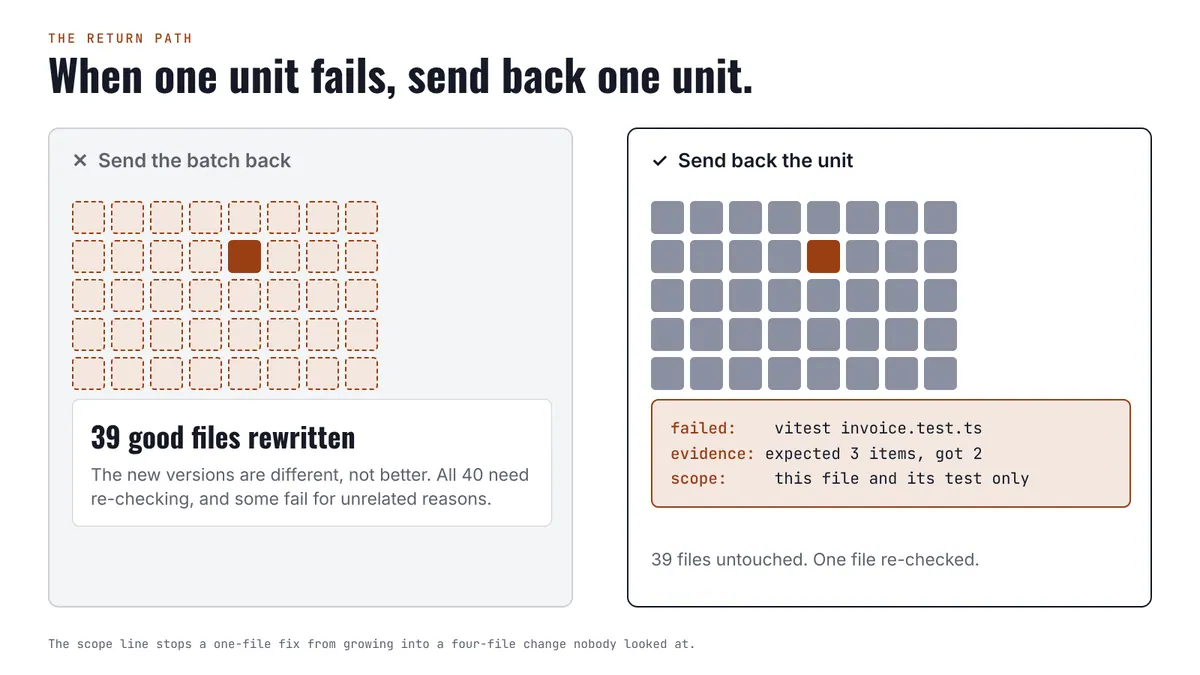
只退失败的那个单元,附三样东西:
failed:    vitest src/billing/invoice.test.ts
evidence:  expected 3 line items, got 2 (invoice.ts:88)
scope:     this file and its test only
scope 那一行最重要。 没有它,agent 会顺手看见旁边两个问题,一并修掉,一个文件的修复悄悄长成四个文件的改动,而没人看过这四个。
同一个失败在两个不同单元里出现时,别修两次。写进之后每个工人都会收到的那份说明里:「日期进来时是字符串,比较前先解析」。一个没被变成规则的失败,你还会再遇到。
六、闸门:按错的代价定价,不按信心
你还是需要在某处留一个人,问题是在哪一处。
常见答案是给个信心分和阈值。更好的变量是「一次错误合并的代价」——因为这是你在跑之前就知道的。把活分三档:
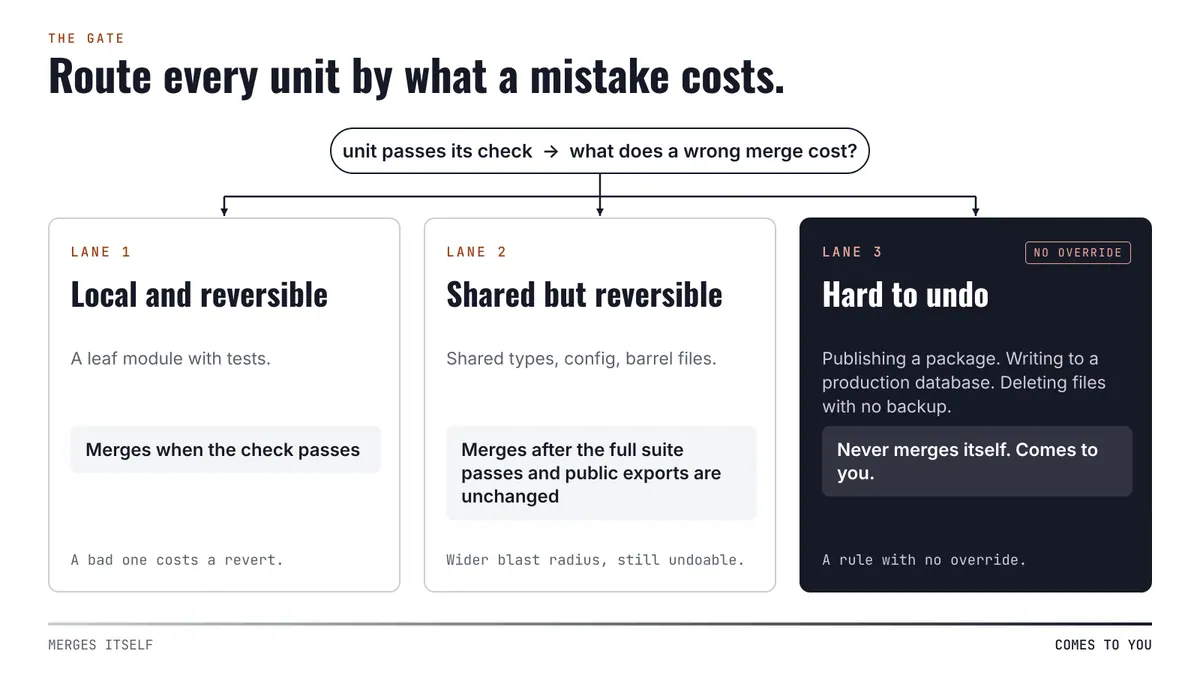
第三档不是「阈值很高」,是一条没有例外的规则,这样周五晚上没人能把它磨下来。
你就坐在这:最终合并,和第三档。中间那些 diff、每一步,都不归你。你要是去读图中间的东西,你自己就成了图里的一个节点,还是最慢的那个。
七、早上的那份报告
你按下运行然后走开。回来时看到的是这样一份报告(是示意,不是实测):
run: js-to-ts · 60 modules · 5 layers
layer 0   14/14 merged   lane 1
layer 1   19/19 merged   lane 1
layer 2   17/18 merged   lane 1   1 returned: billing/invoice.js, attempt 2
layer 3    6/7  merged   lane 2   1 waiting on the full suite
layer 4    2/2  held     lane 3   for you: scripts/release.js, db/seed.js
两个文件需要你。其余的已经向程序交过账了。
八、一个单元一张卡
图里每个单元带三个字段,每个字段回答上面的一节:
unit:   src/billing/invoice.js
check:  tsc --noEmit, vitest invoice.test, no files outside scope
scope:  this file and its test
lane:   2
check 是循环,scope 是退回的边界,lane 是闸门。一块活要是这三样你都填不出来,它还没准备好交给 agent。
九、今晚
挑你上一次逐步审查的那个任务。写下它的检查——那个说「完了/没完」的程序。然后列出它的单元,只在真有东西交过去的地方画一个箭头。
你要从审查那把椅子上起来,不需要更聪明的 agent。你需要一个它争不过的检查,和一张写清谁必须等的图。
别读 diff。去写那个读 diff 的检查。