GPT-6 的 Intelligent UI:ChatGPT 开始给每个问题现做一个界面
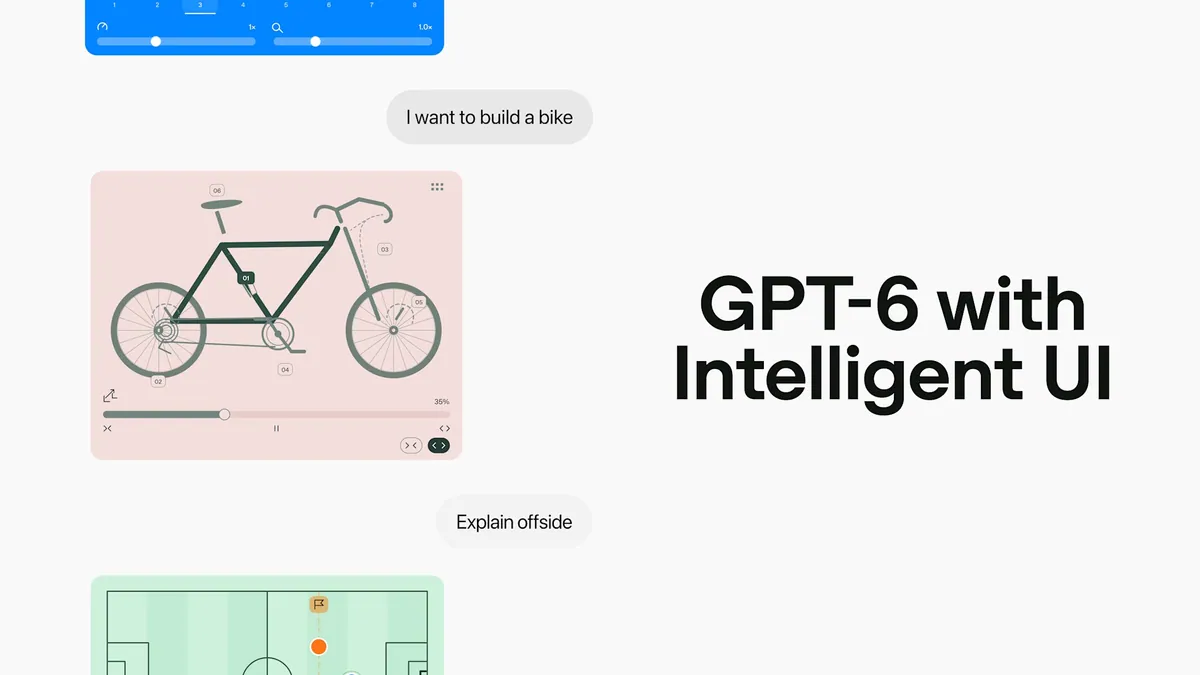
10 月 7 日,OpenAI 把 GPT-6 放进 ChatGPT 的 Chat,一起上的还有 Intelligent UI。官方发布说明写得很直白:GPT-6 会用文字、图形和可交互元素拼回答,怎么拼取决于你问的是什么。
这句话的分量比“回答变好看了”重。ChatGPT 上线快四年,输出格式基本固定:一段文字,偶尔配张图或者一个表格。Intelligent UI 第一次把“用什么形式回答”交给模型自己决定。
一、这次到底发了什么
发布当天,Plus、Pro、Business、Enterprise 在 Chat 标签页拿到 GPT-6 Sol;10 月 8 日扩到 Free 和 Go,用的是 GPT-6 Luna。企业版还要看管理员设置。Work 和 Codex 的模型这次没换。
官方给的规模是每周超过 12 亿人使用 ChatGPT。上个月,第一批 GPT-6 模型先给了付费用户,这次是把下一代模型铺到更大的用户面上。
| 套餐 | 模型 | 开始时间 |
|---|---|---|
| Plus / Pro / Business / Enterprise | GPT-6 Sol | 2026-10-07 |
| Free / Go | GPT-6 Luna | 2026-10-08 |
需要说清楚的是,Intelligent UI 是 ChatGPT 内部的能力。官方发布说明只讲 Chat 体验,没提 API 能不能用同一套组件。想在自己产品里复刻,目前没有现成接口。
二、Intelligent UI:回答可以长成什么样
官方举的例子挺具体,大致分四类。
日常问题:周日烤羊腿的时间表跟食谱排在一起;公路旅行的停靠点直接画在地图上,旁边标哪里值得绕路。
学习:交互式图解,改一个输入看结果怎么变,或者一步一步拆开一个问题。
临时工具:算存款增长的复利计算器、聚餐分账工具、能在对话里玩的小游戏。
调整答案:回答里自带控件,按自己的情况改条件。
发布演示是一辆 7 速自行车,点车架、轮组、传动、刹车、车把,分别看每个系统怎么工作。TechCrunch 的报道里还有一个例子:问飞机机翼怎么产生升力,ChatGPT 当场生成一组图来讲解。
格式跟着问题走。对比用并排,解释用可交互图解,一个问题一句话就够的时候,它还是给文字。官方原话是“当简单的文字回答最有用时,ChatGPT 可以给出文字”。
TechCrunch 提到,视觉密度可以调,不想看那么多图可以调少。产品经理 Aarush Selvan 在发布会上说,ChatGPT 长期是文字界面,但用户要的是把事情办完,“最有用的答案不只是文字”。
三、界面是边生成边出来的
技术路径,官方讲了三层。
组件库:一组原生的、可流式输出的组件,不是让模型写任意前端代码。好处是每个回答有统一的设计底子,同时留出空间让模型决定怎么摆。
编译器:模型一边生成,编译器一边处理界面。回答还没写完,界面已经开始出现。
训练:官方扩展了训练方法,让模型在内容、布局、视觉和交互上做判断,并用清晰度、有用性、完整度来评估它生成的界面。模型还学了什么时候该用交互,什么时候一段文字就够。
官方也承认:“在提升模型的设计判断、扩大它能创建的东西上,还有工作要做。”
界面生成的质量,最后不取决于组件库有多全,而取决于模型对“这个场景需不需要界面”的判断。判断错了,用户看到的就是一堆留白和卡片。
四、先开口,再思考
GPT-6 另一个改动是回答和思考可以交错。推理模型出来之后,用户得等模型想完才有答案;现在 ChatGPT 一边想一边写,把已经拿到的结论先给出来,再继续补。
官方说训练目标里算进了用户的等待时间:分几次给答案,每次加点有用信息,不堆废话,整体还要像一次写完那样连贯、准确。
两个数字。需要联网搜索的问题,GPT-6 Instant 平均比 GPT-5.6 Instant 早 44% 开始回答——这是开始回答的时间,不是总时长。在内部的高价值日常 agent 任务评测里,GPT-6 Extra High 开始回答的时间跟 GPT-5.6 Medium 相当,总分高于 GPT-5.6 Extra High。
五、安全部分的说法
官方说 GPT-6 延续了 Astra 的安全进展,对绕过安全训练的尝试抵抗更强,尤其是跨多轮对话逐步改写的那种。安全训练按真实使用里的情况更新过,重点在 cyberattack、生物威胁和暴力相关的高风险滥用。同时它也训练成不该拒的别乱拒,会结合对话历史和上下文,判断单个 prompt 看不出来的风险。
模型对自身能力边界的说明也更清楚,缺信息、缺工具时会讲明白。细节在 OpenAI 的系统卡里。
六、对交互界面的影响
界面从“提前设计好”变成“当场生成”。 过去的软件,界面是产品经理和设计师在发布前定死的,用户学着用。官方在结尾写的方向相反:“几十年来,人们必须学着用软件,在围绕特定任务设计的固定界面里找路。我们相信未来不一样。不是人去适应软件,是软件去适应人。”
这个念头 1979 年 MIT 的 Put That There 演示里就有——指一下、说一句,机器照做。四十多年过去,真正变的是“谁来组装界面”:以前是人预先组装,现在是模型按你的问题现场组装。
组件库是护栏,也是天花板。 不让模型自由写 HTML,换来的是速度、web 和移动端一致的观感,以及渲染安全;代价是能表达的东西被组件库框住。第三方团队 Thesys(做 OpenUI 的那个)拆过 ChatGPT 的前端流量,说组件库大约 70 个组件加一套设计 token,编译后的程序跑在没有网络权限的 Web Worker 里。这是他们的观察,OpenAI 没有确认。他们还提到几个限制:刷新页面状态会丢、模型读不到你在界面里改的值、属性写错会静默失败。如果属实,说明现在的“界面”更接近一张会动的说明纸,还不是能双向对话的应用。
一次性界面会改变设计工作的重心。 Hacker News 的讨论里有人把它叫“用完即弃的 UI”。如果每个问题都生成一个只服务于这次对话的界面,设计的价值会从“做一个通用界面”往“定一套好组件、一套好判断标准”迁移。对做设计系统的人来说这未必是坏消息:组件质量、组合规则、默认状态是否合理,权重都比以前更高。
好看会放大错误。 一段写错的文字,读的时候容易起疑;一张排版精致、还能拖滑块的图,错误看起来同样权威。HN 上有人直接问:用户怎么知道生成的流程图是对的?官方说评估了清晰度、有用性和完整度,这三项都不等于正确性。涉及计算、金额、健康的场景,还是得自己拿能算的数验一遍。
延迟的账要重算。 界面边生成边出现,用户不用等全文结束,这是实打实的体验改进;但“能开始看”不等于“能开始用”,交互组件要等对应部分编译完才可用。真正的体验差异,得等 Free 和 Go 那一层(Luna)铺开之后才看得清,那才是最大的用户盘子。
它不是 Apps SDK。 Intelligent UI 生成的是 ChatGPT 内部的界面,不连接你的 CRM、数据库或者第三方系统;要接外部系统,还是 Apps SDK 和 MCP 那条路。两者解决的不是同一个问题。
七、现在能怎么用
几个能直接试的提示词:
- 拆开一辆 7 速自行车的设计
- 做一个计算器,看每月存 200 美元、不同利率下 20 年后有多少
- 把四人聚餐的账单按小费滑块分一下
- 规划西雅图到波特兰三个停靠点的路线,画在地图上
- 解释复利,让我能改输入
试完再问一遍同样的内容,加一句“只用纯文字回答”,对比一下。哪种更省事,你自己会有判断。
判断标准可以简单点:能用手算验证的先验算,能查到出处的对一下,花钱、健康、法律相关的,别只信聊天窗口里的那张图。
八、结语
Intelligent UI 现在不完美,官方自己也在说设计判断要继续练。但它把一件长期默认的事改了:回答的形式不再由产品预先规定,由模型按问题决定。
如果这条路走通,以后我们用软件的方式会变——不是打开一个应用找功能,而是说清楚要做什么,界面跟着出现。这一天什么时候到不好说,但方向已经从这次更新里露出来了。