微软开源 Agent Lightning v1.0:不改编一行的 agent,直接上强化学习训练
一、它把「训练」外挂到 agent 上
Agent Lightning 是微软的开源项目(仓库 microsoft/agent-lightning),2025 年 6 月建仓,v1.0 在 2026 年 8 月 17 日重新开源,MIT 许可,Python 写的。到 10 月 16 日,仓库 18.7k star,最新发版是 9 月 29 日的 v1.0.2。
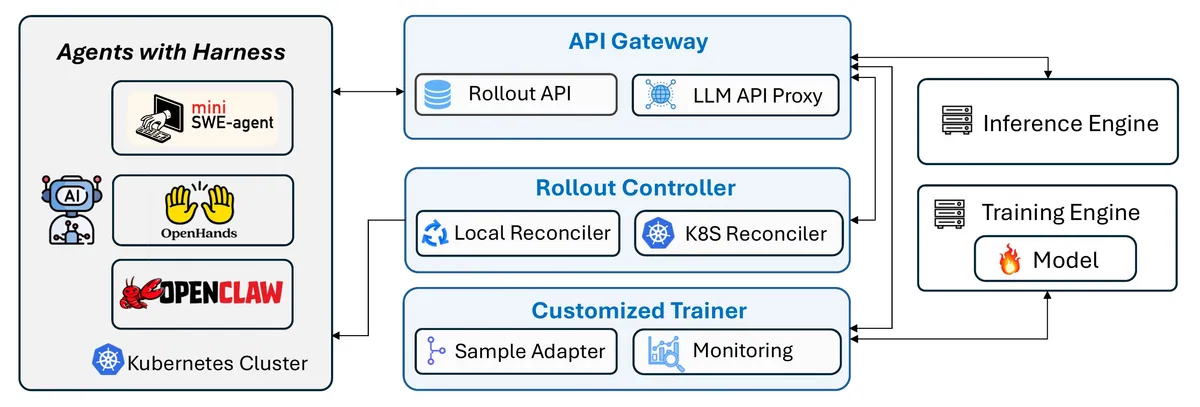
它要解决的麻烦很具体。给 agent 做强化学习,过去只有两条路:把 agent 拆成简化环境,真实工具链丢掉;或者改 agent 的代码去迎合训练框架。v1.0 走的是第三条——agent 一行不改,模型请求全部经它的 API Gateway 代理出去,工具、上下文、控制流、执行环境都还在原来的 harness 里跑,交互过程顺手被抓成训练数据。官方把这种做法叫 harnessed agentic RL。
代价是模型调用要经过它的代理;换来的是训练和线上跑的是同一个 agent,而不是两套东西。
二、三个组件,约 3,500 行
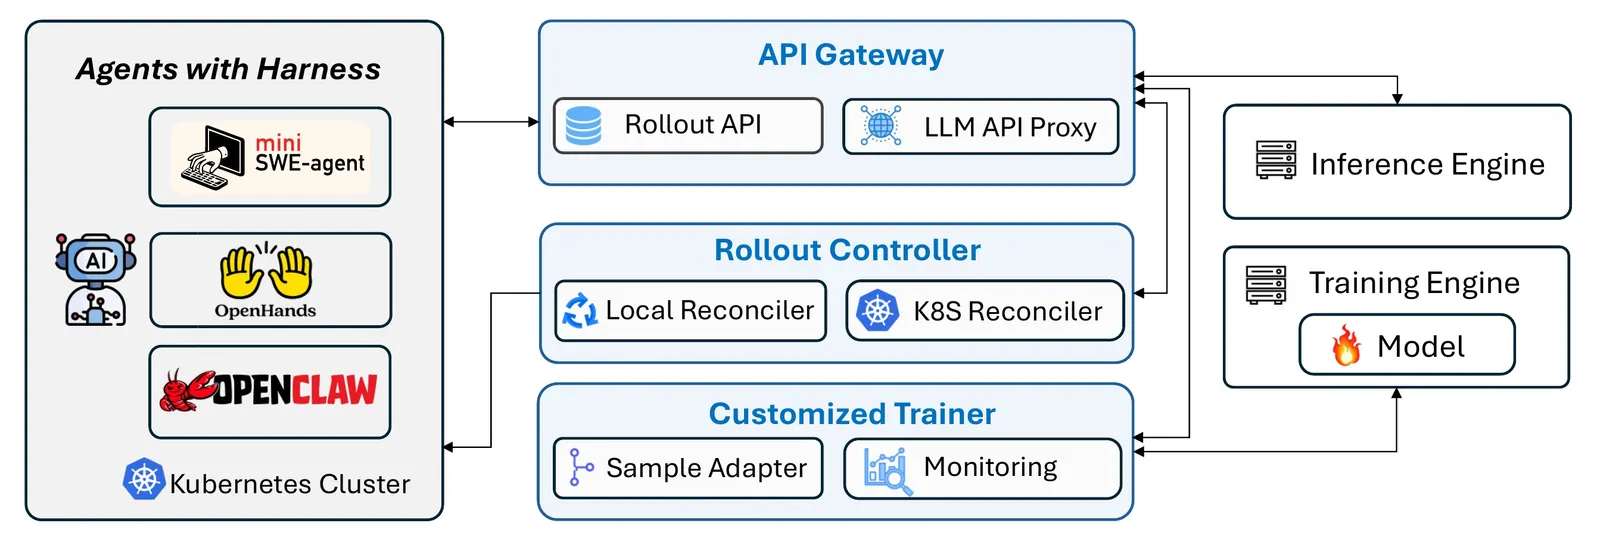
代码量是它自己摆在第一位的原则:整个框架约 3,500 行,拆成三个组件。
| 组件 | 干什么 |
|---|---|
| Trainer | 跑 verl 和 vLLM,构造训练样本、更新策略 |
| API Gateway | 代理模型请求,把交互抓成训练数据 |
| Rollout Controller | 在本地或 Kubernetes Job 里把 agent 跑起来 |
Kubernetes 是原生支持:agent 直接当 K8s Job 提交,不用另外搭一套沙箱服务。三者各管一段——Trainer 造 rollout、Controller 拉起 agent、Gateway 把交互变成训练数据,而 agent 跑的还是它原本那套装备。
概念细节在 Basics 一页(组件、rollout、事件、trajectory),调参分别看 Trainer、API Gateway、Controller 三页配置文档。采集和训练还能异步跑,专门有一节讲 collocated 异步采集与 pause/drain(Asynchronous Training)。
三、纯 RL 跑出来的数字
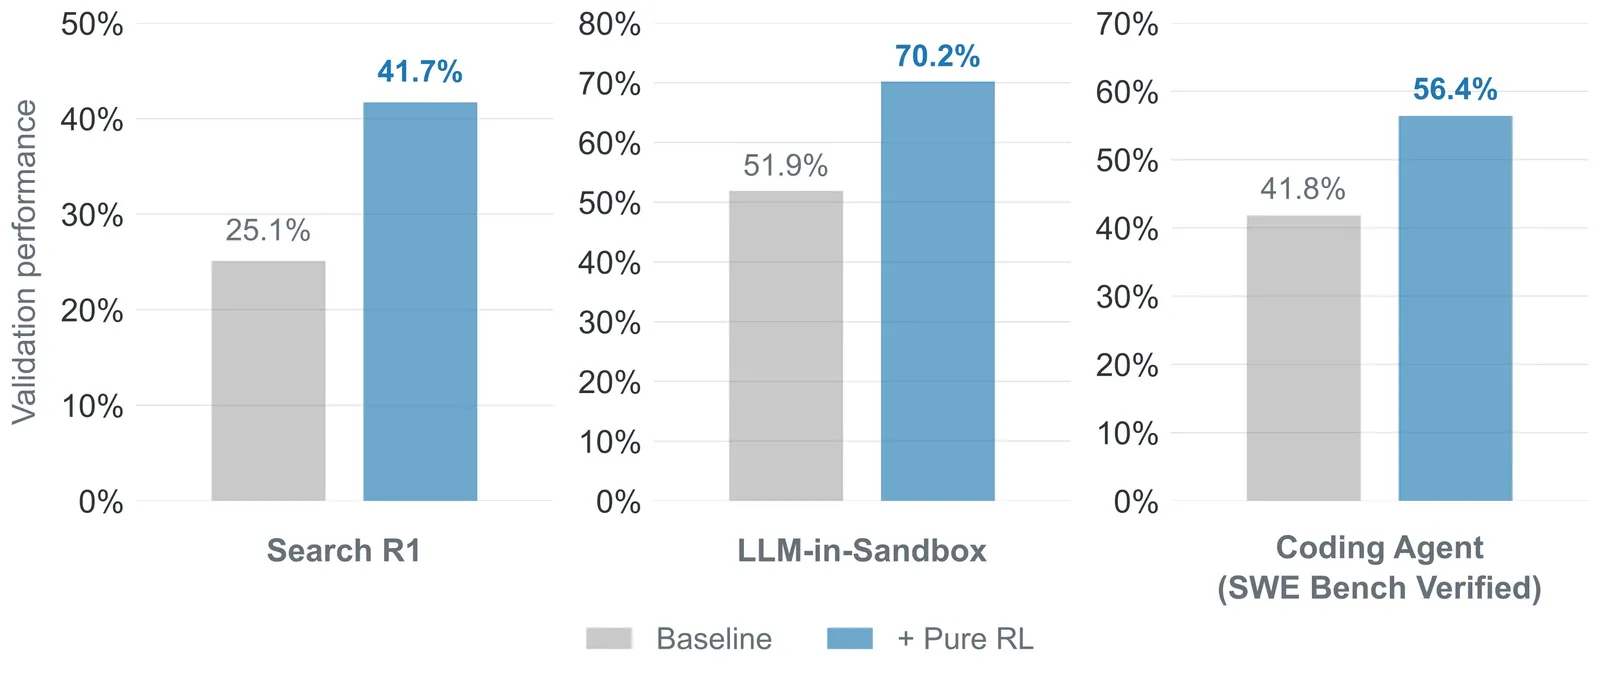
README 里最有说服力的是编码 agent 那条线:一个端到端的 Qwen3.5-9B 工作流,只用 6K 训练样本,SWE-bench Verified 从 41.8% 提到 56.4%,涨 14.6 个百分点。整条流程都开源了,包含数据清洗、防 reward hacking 和训练脚本(Coding Agent 例子)。
9 月又补了一个 MoE 模型的例子:Qwen3.5-35B-A3B 只喂 1.8K 样本,同一基准从 47.8% 爬到 61.6%,涨 13.8 个百分点,走的是 Megatron 加 R3 的路子(MoE 例子)。
编码之外,Search R1(多轮检索加推理)和 LLM-in-Sandbox(带电脑和代码执行工具的通用 agent)两个域也各有提升。
四、让一个 agent 去训练另一个 agent
它 2026 年 8 月还开源了一个 Agent Lightning Skill,思路挺直接:把一个可编辑的 agent 加一个 benchmark 交给 Claude Code、Codex 或 GitHub Copilot,让编码 agent 自己去试改 prompt、工具、工作流、模型设置,把分数提上去,同时盯住每次运行的成本。
三个基准上的平均成绩(对照是同样三个编码 agent、不配 Skill 的情况):
| 方法 | SpreadsheetBench 准确率 | OfficeQA 正确率 | ALFWorld 成功率 |
|---|---|---|---|
| 编码 agent,不配 Agent Lightning | 62.9% | 54.1% | 88.6% |
| 编码 agent,配 Agent Lightning | 66.7% | 54.5% | 94.9% |
被改进的 agent 用的是 GPT-5.4-mini,Claude Code 这边用 Opus 4.8 去优化,Codex 和 GitHub Copilot 用 GPT-5.6-Sol。安装方式:
gh skill install microsoft/agent-lightning agent-lightning --agent claude-code--agent 也可以换成 codex 或 github-copilot。
五、自己上手
环境要求不高也不低:装好 uv 和 NVIDIA CUDA(支持 12.9 或 13.0),单机就能跑训练任务。具体步骤看官方安装指引,第一次跑通看快速上手。
uv sync
source .venv/bin/activate
bash scripts/setup_verl.sh 0.8.0 cu130   # 或者 0.7.1 cu129
uv run wandb login
verl、vllm、torch 三个版本绑得很紧,flash-attn 也容易装崩,官方建议直接用 scripts/setup_verl.sh 装那套测过的、钉死版本的 GPU 栈。
第一个例子挑 Calc-X 最合适,数学推理加 MCP 计算器工具,一张 GPU 够:
source .venv/bin/activate
uv pip install openai httpx sympy \
  "autogen-agentchat" "autogen-ext[openai]" \
  "mcp>=1.11.0,<2" mcp-server-calculator
bash examples/calc_x/run_local.sh
其余例子依次是 GSM8K、ScienceWorld、Search-R1、LLM-in-Sandbox、Coding Agent、Coding Agent (MoE)。文档总目录在 https://microsoft.github.io/agent-lightning/stable/,技术报告是 arXiv 2608.17528(也有 PDF),2025 年那篇原始论文是 2508.03680。
有一点要留意:v1.0 是彻底重构。v1.0 之前的版本挪去了 v0.x 分支,网上不少教程和例子还是旧版的写法。
六、已经有人在用
腾讯 Youtu-Agent 是基于它的一个修改分支做的,把 agent RL 训练推到 128 张 GPU 仍然稳定收敛,训练配方和复盘长文都公开了;DeepWerewolf 是 AgentScope 配 Agent Lightning 做的中文狼人杀训练案例;斯坦福的 AgentFlow 走了类似的 Flow-GRPO 路线;vLLM 的博客专门写过它通过 OpenAI 兼容接口返回 token id、避免 retokenization drift 的做法(原文)。想找同好,仓库里留了微信群入口。
想再往深里看,微软研究院的项目主页是最早那版 RL 方案的介绍,Reddit 上的讨论帖记录了他们最初的思路,官方博客写过轨迹级聚合加速训练,Medium 上有用 Tinker 调 agent 的上篇和下篇,以及教 agent 写 SQL 并自我纠正的一篇,知乎有vLLM 那篇的译文。
对已经在跑 agent 的团队来说,它的价值在于把「训练」这件事的成本从改代码降成了接一个代理。要不要真的训是另一回事:先确认你的任务能不能稳定打分,跑得起来再谈调优。