两只眼睛看两只手:ESTHER 把自我视角的双目手部重建做成端到端模型
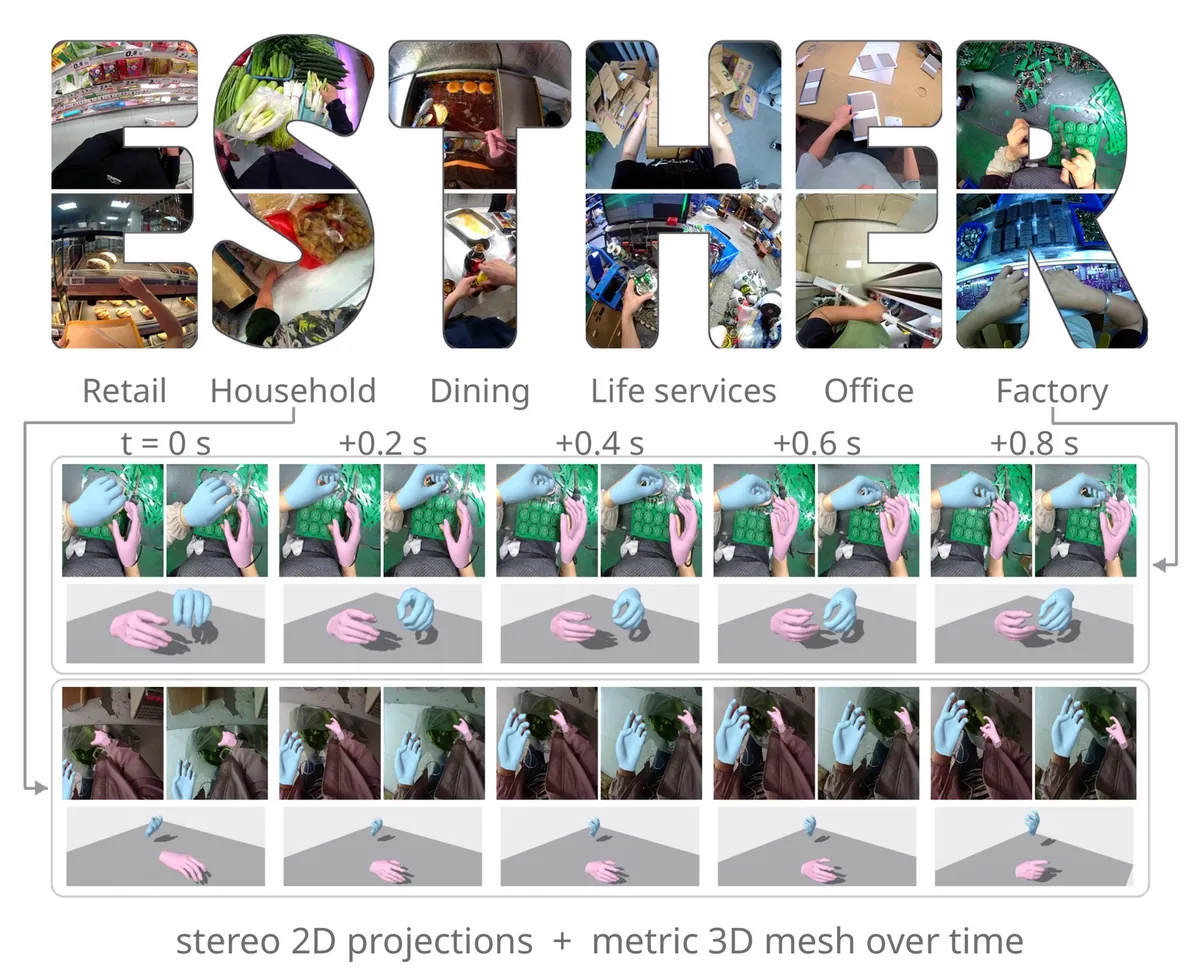
人的手有多灵巧,很大程度取决于两只眼睛一起盯着两只手。双目视差给出的是带米制单位的三维结构,而精细操作需要的正是这个尺度。单目 RGB 也能估出手的网格,只是那个尺度来自学到的先验,不是量出来的距离。
自我视角的双目因此是机器人、AR、VR 的天然感知接口——头戴设备上本来就装着一对短基线相机。可这个设置一直缺两样东西:一个端到端模型,和一套真实场景下的基准。
香港城市大学的 Hongyu Ma、Hairong Qu、Shiqi Zhao、Yongsong Yang、Peng Yin 给出了两样东西:ESTHER 模型,和 ESTHER3D 数据集。任务定义很直接:给一段头戴短基线双目视频,还原 MANO 手部姿态与形状,再给出全局手腕的米制三维平移。
一、双目的三个老问题
论文在开头就摆出了现有方法的三处弱点。这三处毛病在可穿戴双目这个场景里会同时发作。
三角化的锚点不保证。 多视图方法靠标定好的三角化恢复尺度,前提是至少有两只相机同时看见同一个点。可头戴相机里的手经常被模糊和自遮挡从其中一路视图里抹掉,恰恰在最需要米制锚的那些帧上,锚就没了。
检测丢帧是常态。 交互中的那只手会整帧整帧地漏检。按单帧独立处理的架构,离了时序补全根本跑不稳。
手和头的运动搅在一起。 画面里的运动同时混合了手指关节的活动、头部自身的位移,还有裁剪框重新参数化带来的缩放。没有显式解耦的模型,会把后两者吸收进手指姿态里,看起来姿态”合理”,实际是错的。
第三个问题最隐蔽。人的头部在操作时几乎一直在动,模型学到的”手在画面里变大”既可能是手靠近,也可能只是头往前探。
二、两个编码器加一个解码器
ESTHER 的结构按这三个问题切分:
- 立体图像编码器把标定过的双目证据融进联合 token,用的是 Plücker 射线嵌入,把每条像素射线的方向与位置一起编码,几何不是靠网络自己猜的;
- 遮蔽时序运动编码器在这些 token 上跨时间推理,相机与裁剪的运动作为条件 token 一并输入;训练时做运动 token 遮蔽和图像增广(加噪、擦除、整路视图置空、整帧置空),逼它学会补全并判断手是否还在画面里;
- 查询门控融合解码器通过结构化的姿态、形状、手腕 token 读取两个编码器,输出 MANO 姿态、跨时间共享的形状,以及直接回归的绝对手腕位移。
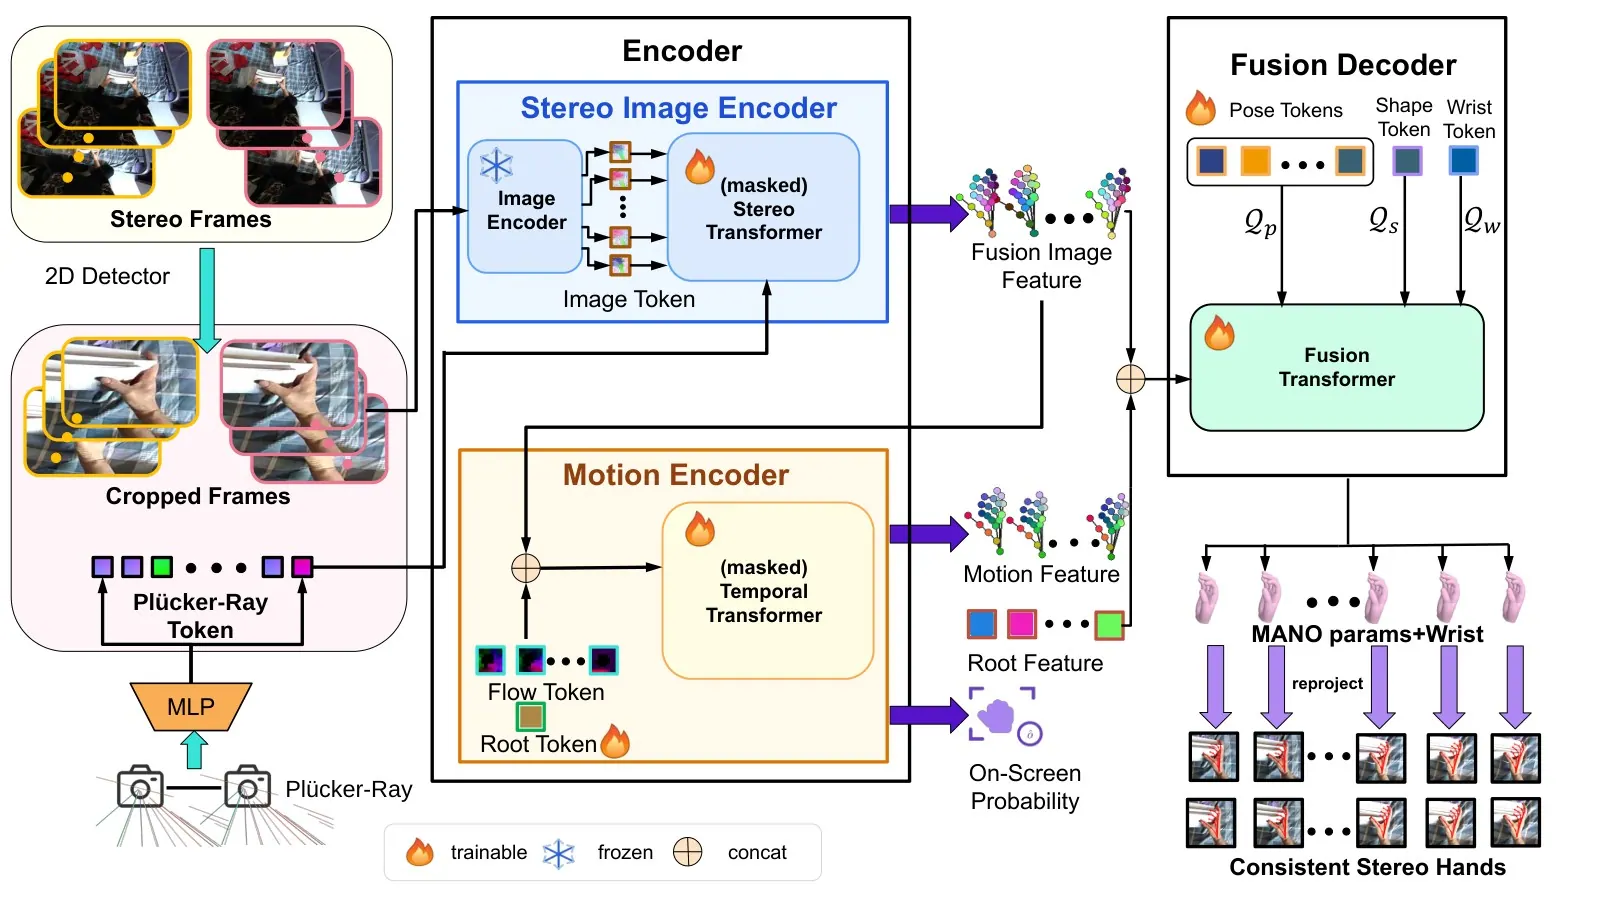
消融表里,几何编码的分量最重:去掉 Plücker 射线嵌入,MPJPE 从 17.7 mm 涨到 27.7 mm(+10.0);去掉跨视图注意力是 26.4 mm(+8.7)。这两个数说明一件事——双目几何不是锦上添花的辅助输入,而是主要的信息来源。完整模型在四张 RTX 4090 上训练约两天。
三、ESTHER3D:训练标签让模型自己标
没有米制标注,就训不出米制模型。而在真实场景里给自我视角双目画面标三维手,本身就是个难题:标注得从残缺、运动、频繁被遮挡的观测里反推出来。
作者的做法是搭一条标定过的教师流水线:把两路视图的 2D 关键点与 WiLoR 的单目预测作为证据,在 DPoser-X 先验约束下做两阶段优化,每条预测再精修 200 步,最后过一遍重投影过滤和人工复核。活下来的标签才进数据集。
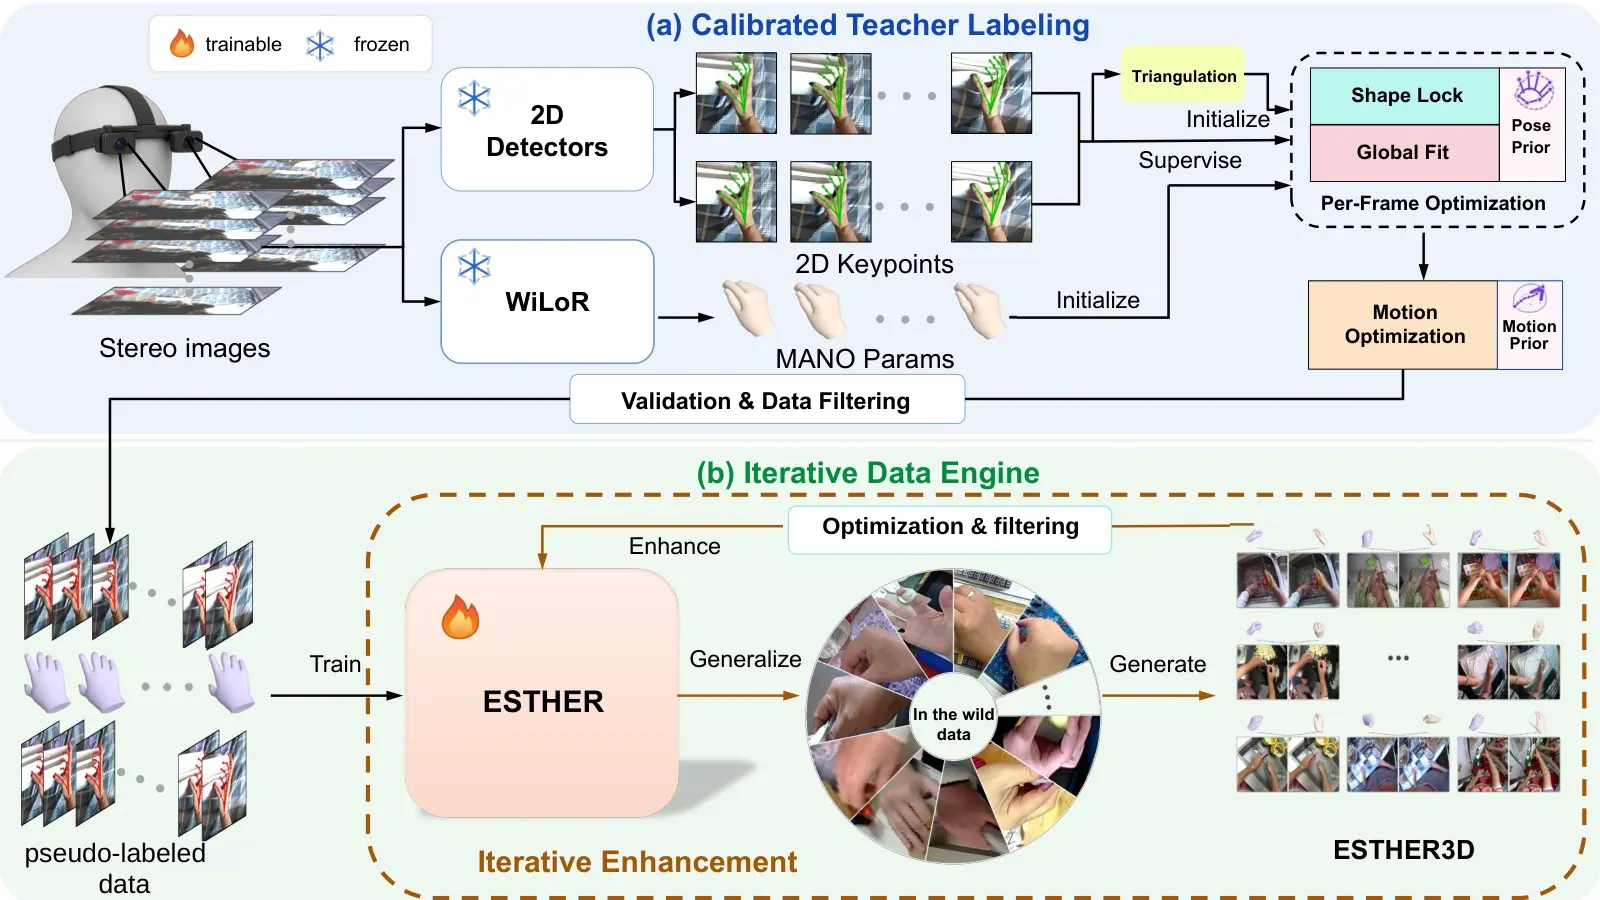
这套标签的可信度,论文给得很克制:真实场景标签的中位重投影残差 5.3 像素,对应面内偏差中位 2.8 mm;在 6.2 cm 基线下,若两路视图误差独立,深度敏感性约 21 mm。作者特意注明,这些是一致性度量与灵敏度度量,不是真值误差的界。跟动捕对齐后,教师模型本身是 15.9 mm MPJPE、19.1 mm 手腕误差。
数据集分两半:
- 训练集来自一套分布式采集程序,121 名采集者、308 个真实场地、44 类场景、约 800 个操作任务,覆盖六个行业,累计约 194 小时,全部由 ESTHER 打标;
- 测试集在动捕棚里拍,覆盖同样六个行业,约 10 小时、6 名被试、50 个脚本任务、14 类手部动作,带真正的米制动捕真值。
每一帧都带双手的 MANO 姿态与形状、绝对米制手腕、标定相机参数、两路视图的 2D 关键点投影和手部包围框。数据引擎是个飞轮:教师标数据 → 训 ESTHER → ESTHER 标更多真实场景数据 → 再训。
四、成绩:姿态赢了,干净帧的手腕没赢
在 ESTHER3D 测试集上(真动捕真值,所有方法零样本):
| 方法 | MPJPE ↓ | PA-MPJPE ↓ | 手腕误差 ↓ | 抖动 ↓ |
|---|---|---|---|---|
| Hiera-FTL | 43.4 | 10.0 | 277 | 79.5 |
| POEM-v2 | 19.4 | 8.9 | 22.5 | 8.5 |
| MVGFormer | 19.2 | 8.9 | 21.0 | 8.7 |
| Epipolar Transformer | 19.0 | 9.0 | 20.9 | 13.3 |
| ESTHER | 17.7 | 8.6 | 21.3 | 3.3 |
姿态上领先,抖动是 3.3 m/s²,比第二名低三到四倍。按单帧独立处理的方法做不出这种时间一致性,这是时序编码器的直接体现。
但手腕误差这一列,ESTHER 是 21.3,没有赢过 Epipolar Transformer 的 20.9 和 MVGFormer 的 21.0。作者自己把这件事写明了:直接回归绝对手腕,是用干净帧上的一点精度,换缺视图时的鲁棒性。
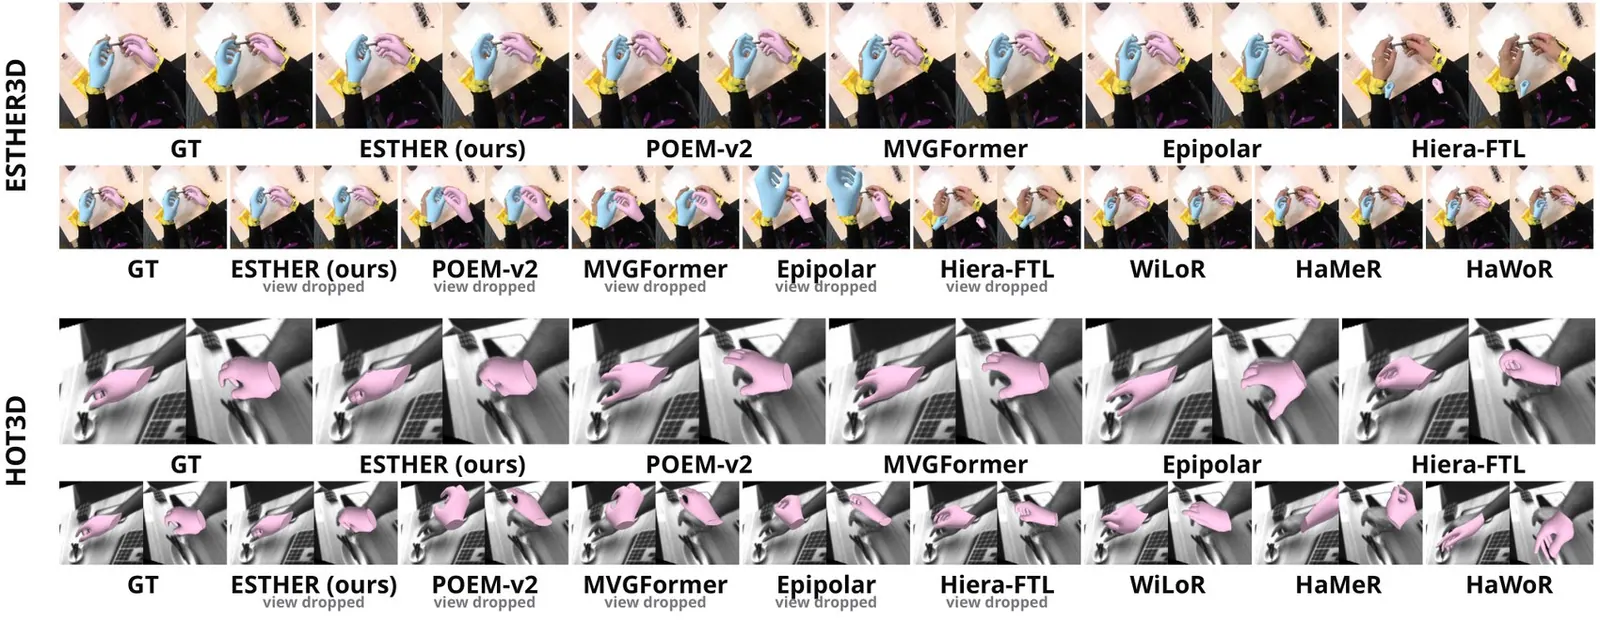
跨数据集的表现更能说明泛化。在 HOT3D 上零样本,ESTHER 的 MPJPE 是 30.5 mm,对手里最好的是 48.3 mm;甚至在 HOT3D 上做了 10% 微调之后,30.5 这个数仍然压着所有微调过的基线。微调之后 ESTHER 是 29.5 mm MPJPE、20.8 mm 手腕、17.1 m/s² 抖动,四项全是最低。
五、丢一路视图:姿态几乎不动,手腕从 21.3 涨到 32.5
可穿戴设备上丢视图不是异常,是日常。作者把一路视图整块置空来模拟这个情况,ESTHER 靠训练时学到的视图遮蔽 token 顶上:
| 方法 | MPJPE ↓ | PA-MPJPE ↓ | 手腕误差 ↓ | 抖动 ↓ |
|---|---|---|---|---|
| HaWoR(单目+时序) | 43.8 | 11.2 | 97.3 | 4.8 |
| HaMeR(单目) | 36.3 | 11.8 | 100.0 | 10.5 |
| WiLoR(单目) | 30.2 | 11.1 | 101.6 | 9.5 |
| POEM-v2 | 29.5 | 9.7 | 96.8 | 8.8 |
| MVGFormer | 28.9 | 9.8 | 97.1 | 9.3 |
| Epipolar Transformer | 27.0 | 9.5 | 171.7 | 10.5 |
| ESTHER | 18.0 | 9.0 | 32.5 | 4.3 |
关键差距在手腕这一列。靠三角化的基线,锚一消失手腕误差直接崩到 96.8–217 mm;ESTHER 只从 21.3 涨到 32.5 mm,相对姿态几乎没动(MPJPE 17.7 → 18.0,PA-MPJPE 8.6 → 9.0)。
另一个数字更说明问题:ESTHER 总参数 355M,在冻结的 DINOv3-L 之上只训了 51M 可训练参数;而它在单路灰度视图上的表现,超过了 1.3B 参数的视频扩散模型 ViDiHand。
六、最有意思的发现:尺寸和深度被绑在一起了
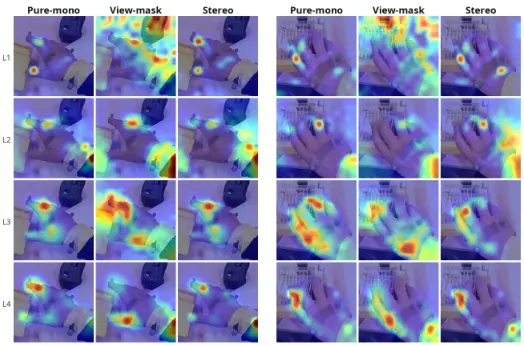
单目回退能保住尺度,这件事本身有点反直觉。作者专门拆开来查,结论是双目训练把”手的视觉尺寸”和”米制深度”绑定成了一个先验。
看注意力。 纯单目模型和双目模型,跨视图注意力的落点几乎一样,都集中在手本身;而视图遮蔽模型明显不同——它的占位 token 会问到手的周围、工作台和小臂上去。也就是说,它在拿场景当深度尺。这一点跟人闭上一只眼之后靠周边参照物判断距离,是同一套办法。
看深度的帧间散布。 作者用 ŷ = a·z + b 拟合预测的手腕深度,把误差拆成可线性校正的系统项和不可约的随机项:
| 配置 | 深度相关性 | 随机散布 |
|---|---|---|
| 双目(完整) | 0.96 | 8 mm |
| 视图遮蔽(丢一路) | 0.92 | 11 mm |
| 纯单目(从头训) | 0.69 | 32 mm |
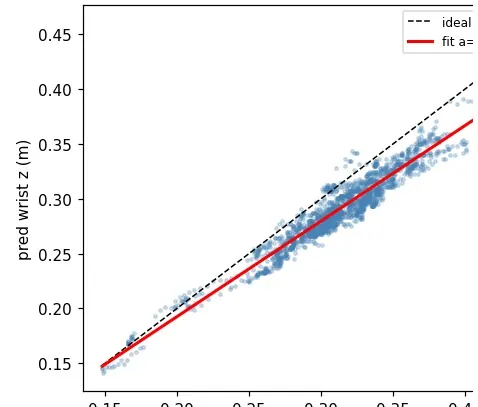
这张表把差别说清楚了。专门为单目从头训的模型,在留出数据上反而垮了,相关性掉到 0.69、随机散布翻三倍到 32 mm,等于在向先验均值回归。而视图遮蔽模型还知道深度怎么逐帧变化,剩下的误差主要是尺度压缩,一个线性项就能修正。
所以”单目回退”在 ESTHER 这里不是降级,是保着双目学来的深度先验去用单目。同一个机制也解释了为什么换基线、换相机内参、甚至换成灰度模态,都只要很少的微调就能适配。
七、这套东西的边界在哪
论文自己把边界写出来了:
- 伪标签的误差界没给。 5.3 像素重投影、2.8 mm 面内偏差、21 mm 深度敏感性,都是与 2D 证据的一致性度量,不是真三维误差的上界。能当”标签大体合理”的证据,不能当精度承诺。
- 测试规模不大。 6 名被试、50 个脚本任务、14 类动作,长尾操作远没覆盖到。
- 干净帧上手腕不是最强。 21.3 mm 那一点让步,是为了缺视图时不崩。
- 三角化锚定的版本更准,但要锚。 消融里”三角化锚定手腕”能到 15.5 mm(比完整模型再好 2.2 mm),代价是必须有稳定三角化——正好是 ESTHER 想去掉的那个依赖。
- 工程数字只给了训练侧。 四张 4090 训两天,推理延迟、真机部署这些一概没提。
对做具身智能的人来说,最有参考价值的可能不是 17.7 这个数,而是那个尺寸—深度绑定的现象:双目训练给模型灌进去的不只是精度,还有一个可以退化使用的几何先验。这个先验在单目回退、更换硬件、降低模态这些现实场景里,比多几个毫米的 MPJPE 值钱。
八、论文与项目页
- 论文:ESTHER: Egocentric Stereo Hand Estimation and Reconstruction in the Wild,arXiv:2609.34817(v1 2026-09-28,v2 2026-10-10)
- 论文地址:https://arxiv.org/abs/2609.34817
- 项目页:https://fruitrabbit.github.io/esther/
- 作者:Hongyu Ma、Hairong Qu、Shiqi Zhao、Yongsong Yang、Peng Yin(香港城市大学);方向:cs.CV / cs.AI